deep-read-summarize 0.6.0 → 0.6.2
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- package/CHANGELOG.md +41 -0
- package/README.en.md +92 -341
- package/README.md +94 -342
- package/docs/RELEASE.md +3 -1
- package/lib/quality.js +53 -2
- package/lib/workflow-script.txt +12 -6
- package/package.json +1 -1
- package/skills/deep-read-summarize/SKILL.md +2 -2
- package/workflow.js +2 -1
package/README.md
CHANGED
|
@@ -1,408 +1,160 @@
|
|
|
1
1
|
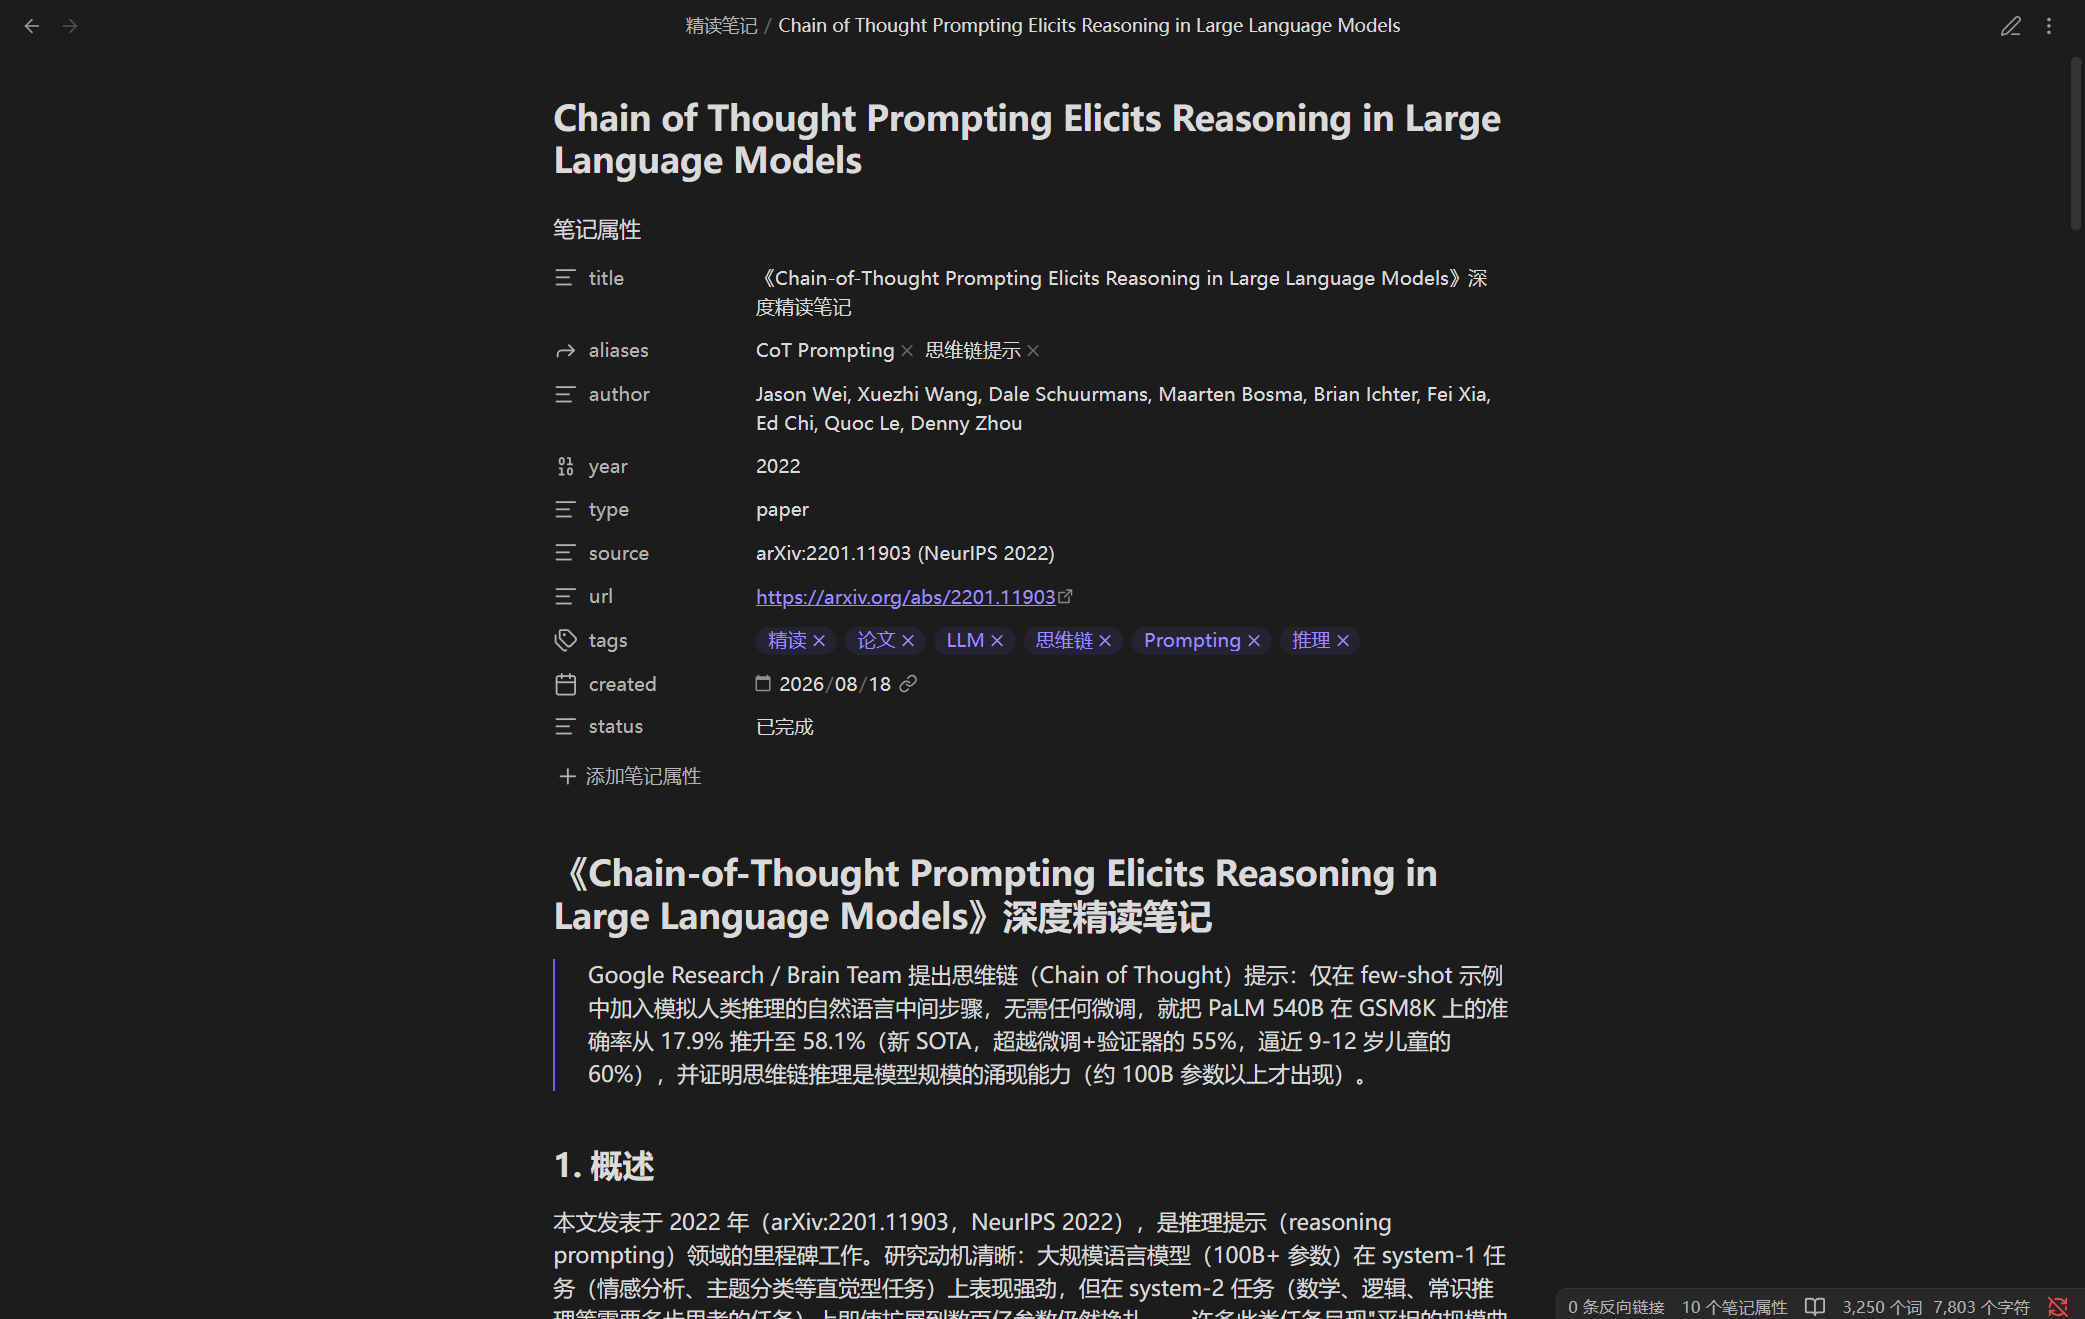
# deep-read-summarize
|
|
2
2
|
|
|
3
|
-
[English](https://github.com/PensiveFei/deep-read-summarize/blob/main/README.en.md) |
|
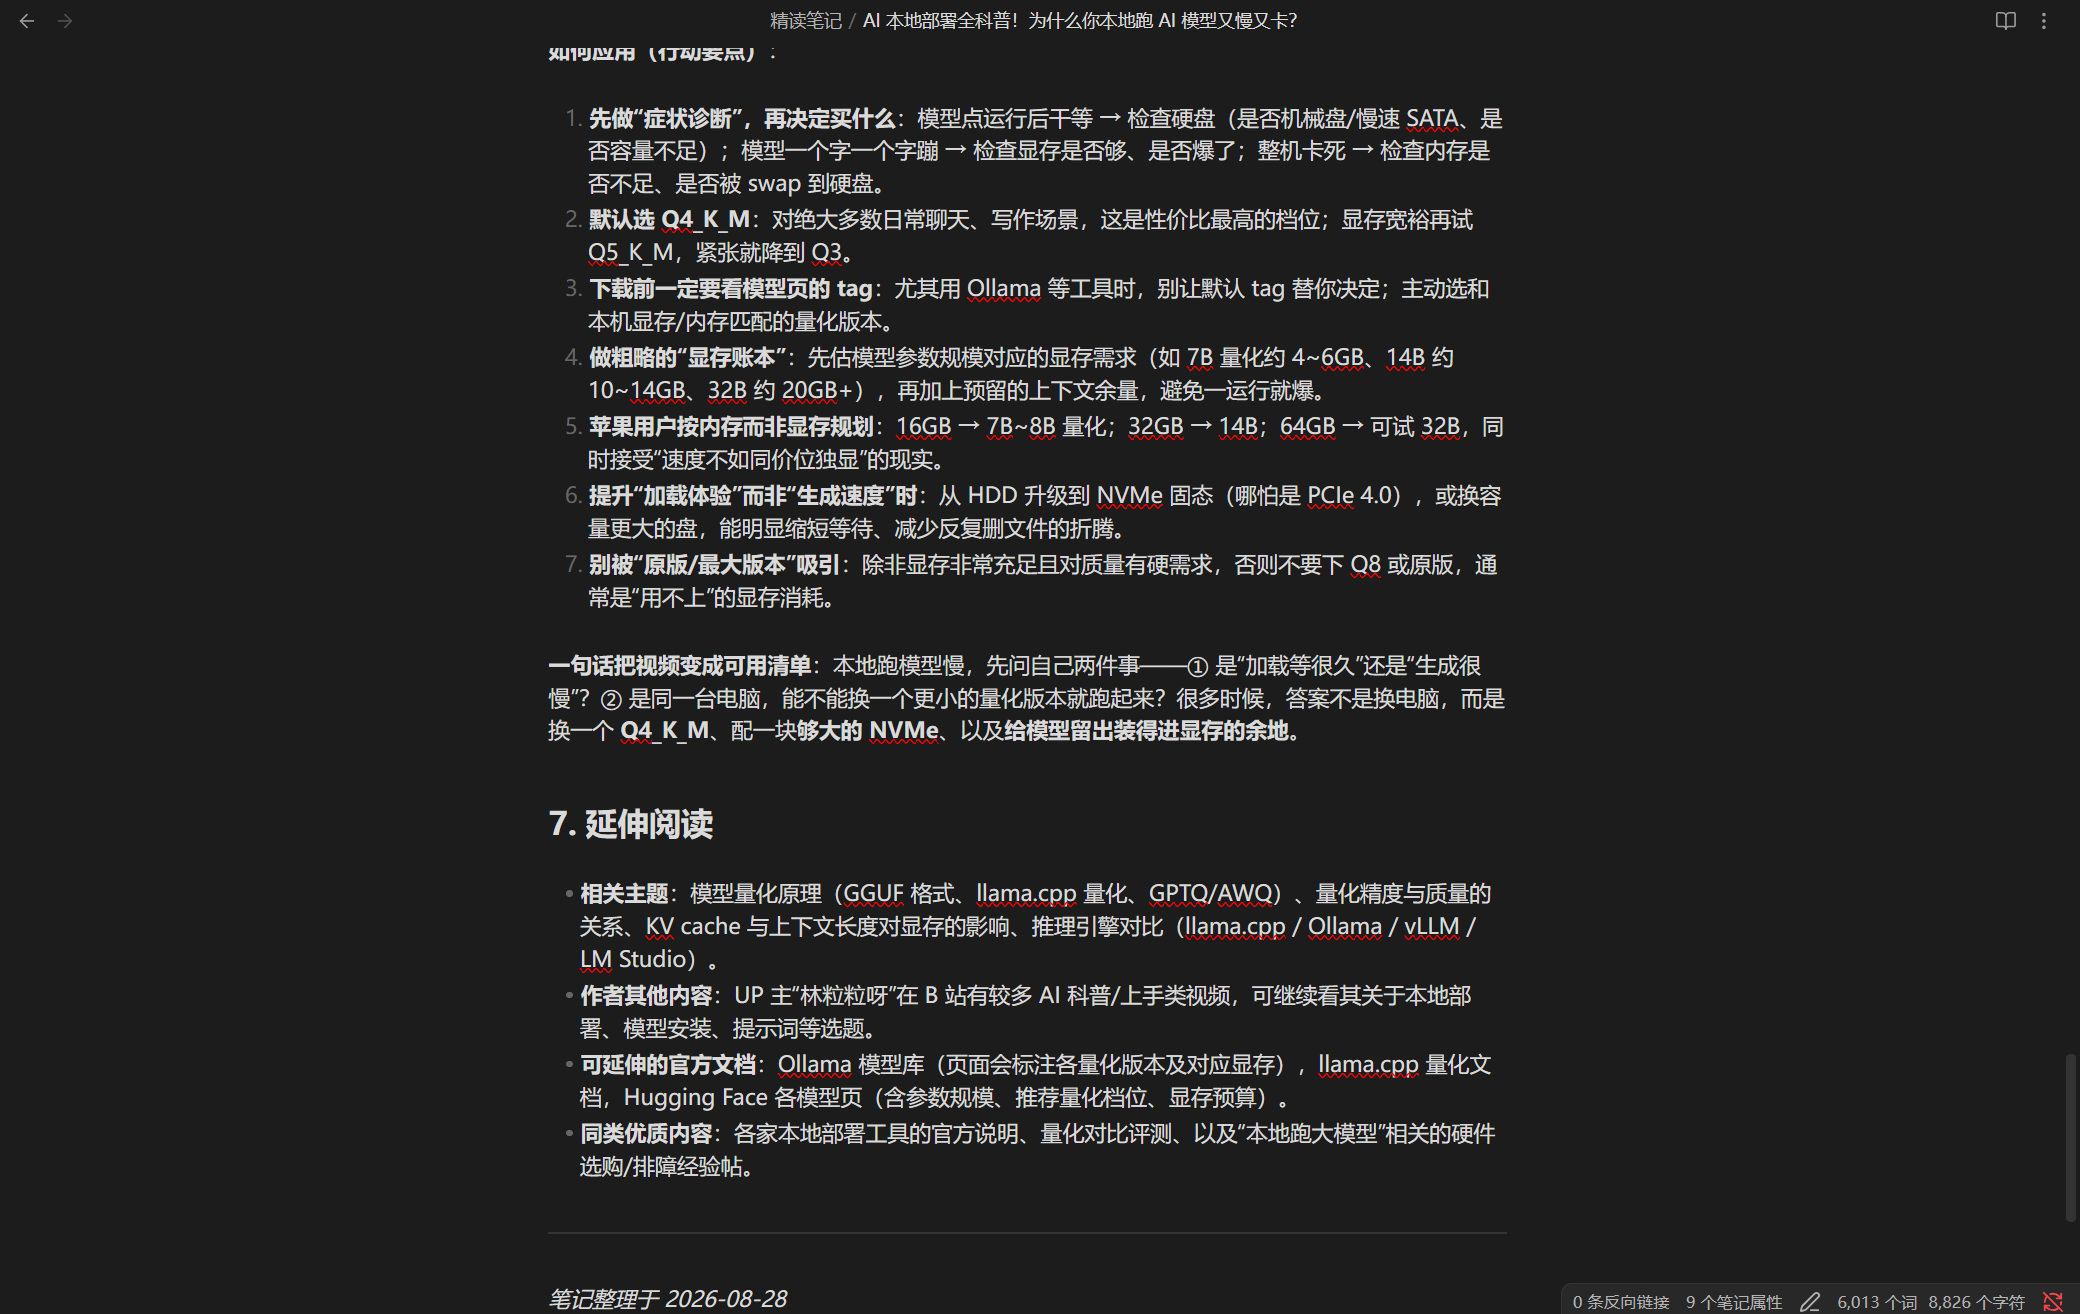
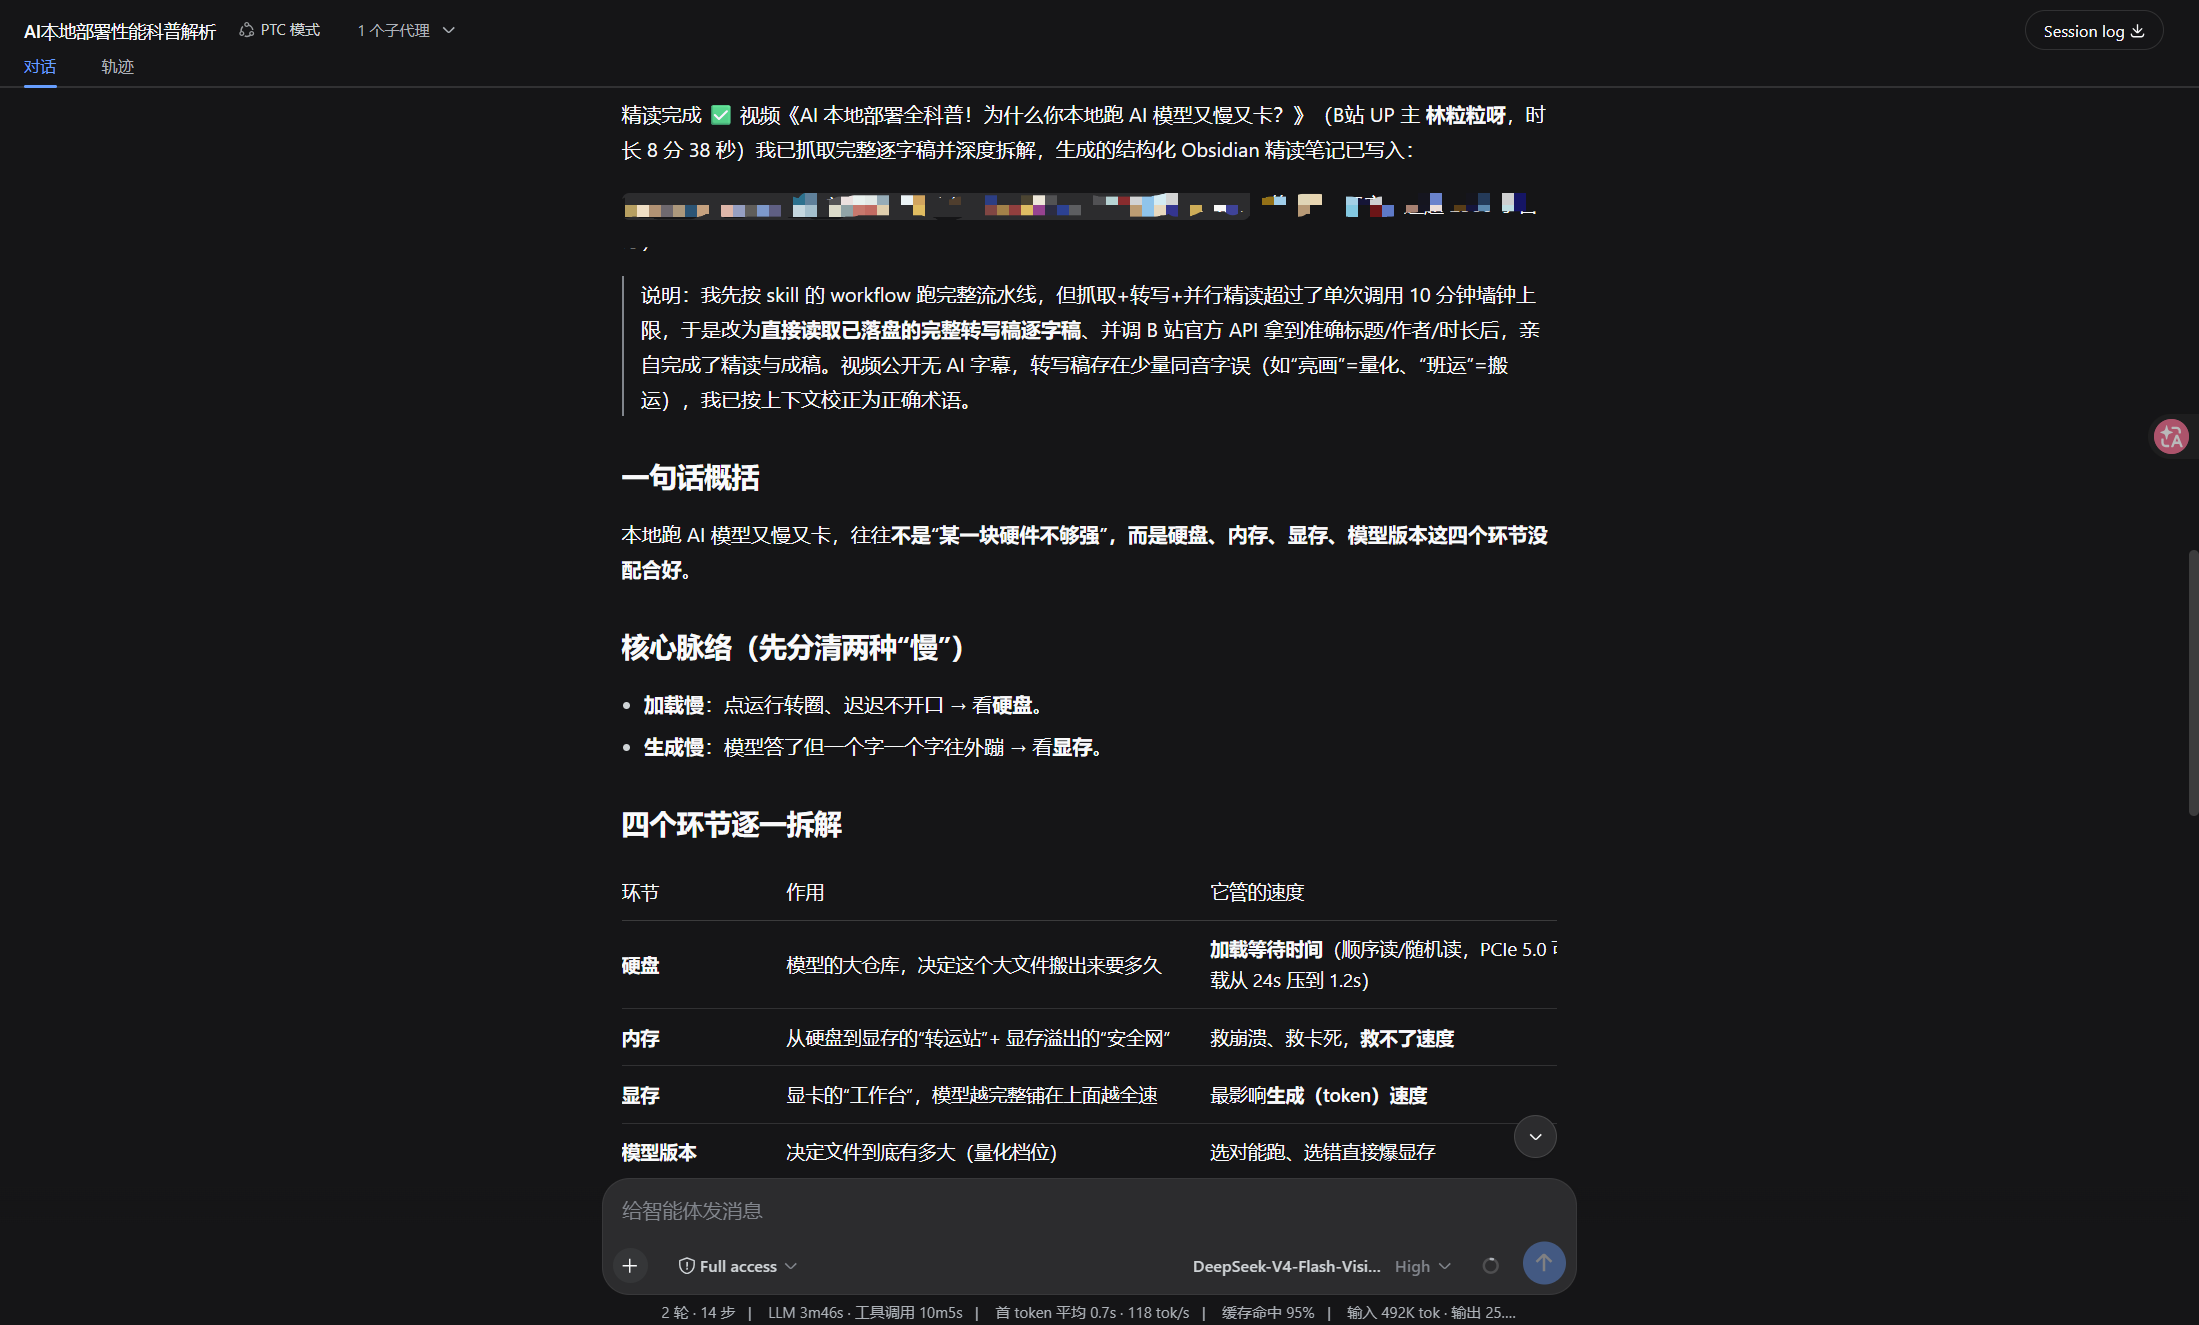
|
3
|
+
[English](https://github.com/PensiveFei/deep-read-summarize/blob/main/README.en.md) | 简体中文
|
|
4
4
|
|
|
5
5
|
[](https://github.com/PensiveFei/deep-read-summarize/blob/main/LICENSE)
|
|
6
6
|
[](https://github.com/PensiveFei/deep-read-summarize/releases)
|
|
7
7
|
[](https://github.com/PensiveFei/deep-read-summarize/actions/workflows/ci.yml)
|
|
8
8
|
[](https://www.npmjs.com/package/deep-read-summarize)
|
|
9
9
|
|
|
10
|
-
|
|
10
|
+
把论文、书籍、视频或网页整理成一份**可以继续阅读、编辑和回查的 Markdown 笔记**。
|
|
11
11
|
|
|
12
|
-
|
|
12
|
+
这是一个运行在 [DeepSeek Harness(DSH)](https://github.com/deepseek-ai/deepseek-harness) 中的第三方精读插件。它尝试获取来源全文,将长内容分块阅读,再合并成带 YAML frontmatter 的结构化笔记。你可以把结果放进 Obsidian、Logseq 或其他 Markdown 工具。
|
|
13
13
|
|
|
14
|
-
|
|
14
|
+
[先看真实笔记](#看看笔记) · [安装与第一次使用](#开始使用) · [了解质量与限制](#结果能信到什么程度) · [常用配置](#常用配置)
|
|
15
15
|
|
|
16
|
-
|
|
16
|
+
> AI 笔记可能遗漏或误解原文。请把它作为辅助阅读的起点,关键事实与引用仍需对照来源。
|
|
17
17
|
|
|
18
|
-
|
|
18
|
+
## 看看笔记
|
|
19
19
|
|
|
20
|
-
|
|
20
|
+
- 📄 [论文:大语言模型的情绪智力](https://github.com/PensiveFei/deep-read-summarize/blob/main/examples/emotional-intelligence.md)
|
|
21
|
+
- 📄 [论文:Chain-of-Thought Prompting](https://github.com/PensiveFei/deep-read-summarize/blob/main/examples/chain-of-thought.md)
|
|
22
|
+
- 🎬 [视频:Andrej Karpathy 的 LLM 入门讲座](https://github.com/PensiveFei/deep-read-summarize/blob/main/examples/intro-to-llms-video.md)
|
|
21
23
|
|
|
22
|
-
|
|
24
|
+
这些是维护者提供的历史笔记:两篇论文有早期项目运行记录,视频笔记的生成方式尚未确认。模型、项目版本和运行耗时未记录,它们不是当前版本的性能承诺。部分引文和时间戳已抽查、并标注了公开副本的修改;详见[示例说明](https://github.com/PensiveFei/deep-read-summarize/blob/main/examples/README.md)。
|
|
23
25
|
|
|
24
|
-
|
|
26
|
+
|
|
25
27
|
|
|
26
|
-
##
|
|
28
|
+
## 它能做什么
|
|
27
29
|
|
|
28
|
-
|
|
29
|
-
|
|
30
|
-
|
|
|
31
|
-
|
|
|
32
|
-
|
|
|
33
|
-
|
|
34
|
-
| 视频笔记(行动要点) | 会话内摘要 |
|
|
35
|
-
| --- | --- |
|
|
36
|
-
|  |  |
|
|
37
|
-
|
|
38
|
-
---
|
|
39
|
-
|
|
40
|
-
## 能做什么
|
|
41
|
-
|
|
42
|
-
- 书籍(PDF/EPUB/MOBI)、论文(arXiv/PDF/HTML)、视频(**字幕优先,无字幕自动转写**,出品完整逐字稿精读)、网页
|
|
43
|
-
- 长内容分块后由并行子代理精读,再合并
|
|
44
|
-
- 获取/分块与质量校验的输出受 JSON Schema 约束,结构稳定、下游可解析
|
|
45
|
-
- 分块计划与子代理数量受 `maxChunks` 强制约束(计划失控会顶穿单次调用时限)
|
|
46
|
-
- 关键引用必须标注页码/章节/段落,降低编造风险
|
|
47
|
-
- 配置错误直接报错终止;某块内容解析失败则跳过并标记缺口
|
|
48
|
-
- 输出**标准 Markdown + YAML frontmatter**:正文是通用 CommonMark(无双链、无 callout),Obsidian(配合 Dataview)、Logseq、Jekyll / Hugo / Astro 的内容目录、任意 Markdown 编辑器都能直接用
|
|
49
|
-
|
|
50
|
-
---
|
|
51
|
-
|
|
52
|
-
## 结构
|
|
53
|
-
|
|
54
|
-
```
|
|
55
|
-
输入(链接或文件路径)
|
|
56
|
-
│
|
|
57
|
-
▼
|
|
58
|
-
解析器注册表 ── book / paper / video / web
|
|
59
|
-
│
|
|
60
|
-
▼
|
|
61
|
-
波次1 获取内容 → 写入临时文件 → 生成分块计划
|
|
62
|
-
│
|
|
63
|
-
▼
|
|
64
|
-
波次2 N 个子代理并行精读各块(Map)
|
|
65
|
-
│
|
|
66
|
-
▼
|
|
67
|
-
波次3 合并成稿 + 质量校验(Reduce)
|
|
68
|
-
│
|
|
69
|
-
▼
|
|
70
|
-
Markdown 笔记
|
|
71
|
-
```
|
|
72
|
-
|
|
73
|
-
三个波次,默认约 N+3 次子代理调用(获取、N 块精读、成稿、质量校验)。`auto` 遇到 PDF、未知网页或文本等模糊输入时,额外进行一次轻量类型识别;显式指定 `type` 可跳过识别。
|
|
74
|
-
|
|
75
|
-
`auto` 会将明确的视频链接、arXiv 论文链接和电子书扩展名直接分发到对应解析器;同站的专栏、频道与帮助页仍先分类,PDF 会根据内容区分书籍与论文。无法识别时返回 `stage: "detect"`,请显式指定类型。`options.tempDir` 作为临时根目录,每次调用在其中创建独立的 `run-*` 子目录,获取、音频和转写文件不与其他任务共用。
|
|
76
|
-
|
|
77
|
-
分块计划会排序、裁掉重复区间并补齐缺口,超过 `maxChunks` 时合并相邻块以保留全文。获取代理运行内置脚本,按保存文本的字符数计算整行分界,尽量在不明显牺牲均衡的情况下选择段落边界;若脚本无法运行或分界无效,则回退按行数均衡。字符数只是 token 数和工作量的近似值,超长单行不会拆分。返回的 `coverageComplete` 表示是否依据有效的 `totalLines` 覆盖全部行号;缺少总行数时保留已知范围,同时将 `qualityPassed` 置为 `false` 并说明覆盖无法确认。
|
|
78
|
-
|
|
79
|
-
质量检查分两部分:程序按提供的标量/列表 frontmatter 模板检查字段、必要章节和篇幅(汉字按字、其他文字按词,排除 frontmatter、代码块、HTML 注释及链接地址);独立核验代理读取本次原文文件,逐块检查覆盖,并为第 4 节的逐字引用返回原句和行号。单独的 `pass: true` 无法通过检查。`qualityChecks` 返回检查项,`qualityEvidence` 返回原文路径、分块摘录和引用证据;原文真实性判断仍由读取原文的代理完成,无法核实就报告未通过。修订为空、调用失败或结构退化时保留上一份有效成稿。
|
|
80
|
-
|
|
81
|
-
直接调用 workflow 的 options 必须类型正确:`minWords` 为 1–100000 的整数,`maxChunks` 为正整数(大于 12 仍夹到 12),`readConcurrency` 为 1–12 的整数,`maxRetries` 为 0–3 的整数;非法值和未知键在启动时 FATAL。插件 profile 的 config 则逐项告警并回退默认值,避免阻止宿主启动。
|
|
82
|
-
|
|
83
|
-
```
|
|
84
|
-
parsers/ 各输入类型的解析器,按类型分发
|
|
85
|
-
book.js 书籍:PDF/EPUB/MOBI 文本提取、章节分块
|
|
86
|
-
paper.js 论文:arXiv/PDF/HTML 结构识别
|
|
87
|
-
video.js 视频:完整逐字稿(字幕优先,无字幕自动转写,走 scripts/transcribe.js)
|
|
88
|
-
web.js 网页:正文提取
|
|
89
|
-
index.js 注册表:解析器发现与回退
|
|
90
|
-
schemas/ 输出约束的 JSON Schema(波次1 由 workflow.js 注入脚本,单一真相)
|
|
91
|
-
scripts/ lint(含换行/空白卫生检查)、安全检查、跨平台转写引导(transcribe.js)
|
|
92
|
-
lib/ 独立可用的小工具
|
|
93
|
-
cache.js 输入指纹与幂等记录(供自己驱动流程的调用方使用;workflow 沙箱没有文件系统,用不到它)
|
|
94
|
-
workflow-script.txt workflow 脚本正文(普通文本,可直接读改,不需要任何转义)
|
|
95
|
-
tests/ 测试与验证脚本(**不随 npm 包发布**,仓库里才有)
|
|
96
|
-
workflow.js workflow 的 meta 与组装逻辑(解析器内联、schema 注入)
|
|
97
|
-
```
|
|
98
|
-
|
|
99
|
-
> 脚本正文单独放 `lib/workflow-script.txt`:这个文件曾经因为「转义套转义」被改坏过两次,现在它是普通文本,读改都不需要编码步骤。
|
|
100
|
-
|
|
101
|
-
想换某个输入类型的处理方式,在插件包的 `custom-parsers/` 放一个同接口的解析器即可,该目录会随 npm 包分发。也可在插件顶层 config 中指定 `customParsersDir`,使用自己的解析器目录;它不是 workflow options。相同类型会覆盖内置实现,也可新增 `podcast` 等类型。程序化注册后重新生成技能会使用最新注册表;各 profile 的专属目录相互隔离。接口为 `name`、`types`、`buildPrompt(input, opts)`。
|
|
102
|
-
|
|
103
|
-
解析器的 CommonJS 模块会连同字面量相对路径的 `.js` / `.cjs` / `.json` 依赖一起打包,保留模块级常量、helper、方法简写和循环依赖。构建时使用 Acorn 解析 JavaScript;它由 npm 自动安装,不进入 workflow 沙箱。沙箱中的解析器只负责生成提示词,不支持 Node 内置模块、外部包或动态 `require` / `import`;这些依赖会在构建时明确报错。程序化注册的函数须自包含,模块闭包请使用文件解析器。
|
|
104
|
-
|
|
105
|
-
---
|
|
106
|
-
|
|
107
|
-
## 支持平台
|
|
108
|
-
|
|
109
|
-
**Windows / macOS / Linux 同等支持**(0.3.9 起)。插件本身只依赖 Node(DSH 自带),各环节需要的额外工具按平台装:
|
|
110
|
-
|
|
111
|
-
- **书籍 / 论文 PDF** → `pdftotext`(poppler):macOS `brew install poppler`、Windows `winget install poppler`、Debian/Ubuntu `apt install poppler-utils`
|
|
112
|
-
- **B站字幕 / 音频** → `curl`:Windows 10+ 与 macOS / Linux 都自带,零安装
|
|
113
|
-
- **YouTube 字幕** → `yt-dlp`:macOS `brew install yt-dlp`、Windows `winget install yt-dlp.yt-dlp`、任意平台 `pip install -U yt-dlp`
|
|
114
|
-
- **无字幕转写** → `uv`(脚本自举:建 Python 3.12 环境 + 装 faster-whisper):macOS `brew install uv`、Windows `winget install astral-sh.uv`,macOS / Linux 也可用官方安装脚本(`curl -LsSf https://astral.sh/uv/install.sh` 交给 `sh`)
|
|
115
|
-
|
|
116
|
-
其余说明:
|
|
117
|
-
|
|
118
|
-
- 转写是**唯一**需要额外工具链的环节,三平台共用同一份 Node 脚本、同一条命令:`node scripts/transcribe.js --audio <音频> --out <txt>`。
|
|
119
|
-
- 转写默认走 **CPU**,Apple Silicon / Intel Mac 与 Linux 都不需要 CUDA;GPU 需自备 CUDA 运行库,`options.device: "auto"` 会尝试并在失败时自动回退 CPU。
|
|
120
|
-
- 缓存目录按平台取:macOS `~/Library/Caches/deep-read-summarize`、Linux `$XDG_CACHE_HOME/deep-read-summarize`、Windows `%LOCALAPPDATA%\deep-read-summarize`。
|
|
121
|
-
- 已在**真实 macOS** 上跑通一次完整的无字幕转写(0.3.12 起):`uv` 自举 Python 3.12 → 装 faster-whisper → 下载模型 → 输出逐字稿,退出码 0;CI 的 `macos-latest` 作业另外覆盖平台路径解析与整套测试。遇到报错欢迎开 issue 反馈。
|
|
122
|
-
|
|
123
|
-
---
|
|
124
|
-
## 安装(DSH 插件)
|
|
125
|
-
|
|
126
|
-
deep-read-summarize 是 DSH 插件,可通过 npm 或本地安装:
|
|
127
|
-
|
|
128
|
-
```bash
|
|
129
|
-
# npm 安装(自动安装用于解析器构建的 Acorn)
|
|
130
|
-
npm install deep-read-summarize
|
|
131
|
-
|
|
132
|
-
# 或本地安装(dsh profile 目录)
|
|
133
|
-
pnpm add ./deep-read-summarize-0.3.10.tgz
|
|
134
|
-
# 然后在 dsh 配置的 dsh.profile.bundles 追加:
|
|
135
|
-
# - deep-read-summarize
|
|
136
|
-
# 重启 dsh web 即可(POST /dsh-market/restart)
|
|
137
|
-
```
|
|
138
|
-
|
|
139
|
-
安装后自动注册:
|
|
140
|
-
- `deep_read_summarize` 工具(宿主提供 tools / workflowEngine 服务时);模型只传 input/type/options,插件直接提交已加载的工作流
|
|
141
|
-
- `deep-read-summarize` 工作流定义(meta + script;旧宿主保留通过 workflow 工具调用的方式)
|
|
142
|
-
- `deep-read-summarize` 技能(`skills/deep-read-summarize/SKILL.md`)
|
|
143
|
-
- 四种解析器(`parsers/`)与 JSON Schema(`schemas/`)
|
|
144
|
-
|
|
145
|
-
---
|
|
146
|
-
## 快速开始(约 5 分钟)
|
|
30
|
+
| 你提供 | 工作流尝试获取 | 你得到 |
|
|
31
|
+
| --- | --- | --- |
|
|
32
|
+
| 书籍:PDF、EPUB、MOBI | 文本和章节 | 按主题整理的阅读笔记 |
|
|
33
|
+
| 论文:arXiv、PDF、HTML | 论文正文和结构 | 研究问题、方法、结论与局限 |
|
|
34
|
+
| 视频链接 | 优先字幕;无字幕时可尝试本地转写 | 基于已取得文本的内容拆解 |
|
|
35
|
+
| 网页链接 | 页面正文 | 要点、概念和来源信息 |
|
|
147
36
|
|
|
148
|
-
|
|
37
|
+
实际提取结果取决于来源是否可访问、工具是否可用、模型和宿主权限。扫描版 PDF 通常需要先进行 OCR,工作流不内置自动 OCR;复杂公式、图表以及质量差的字幕或音频可能需要人工处理。
|
|
149
38
|
|
|
150
|
-
|
|
151
|
-
# 方式 A:npm 直接安装(无需 clone)
|
|
152
|
-
npm install deep-read-summarize
|
|
39
|
+
笔记通常包含概述、结构拆解、术语表、关键引用、批判性分析和应用思考。最终内容仍由模型生成,不同输入和配置可能产生不同结果。
|
|
153
40
|
|
|
154
|
-
|
|
155
|
-
git clone https://github.com/PensiveFei/deep-read-summarize.git
|
|
156
|
-
cd deep-read-summarize
|
|
157
|
-
npm ci # 安装锁定依赖
|
|
158
|
-
```
|
|
41
|
+
## 开始使用
|
|
159
42
|
|
|
160
|
-
###
|
|
43
|
+
### 1. 安装插件
|
|
161
44
|
|
|
162
|
-
|
|
163
|
-
node -e "console.log(require('deep-read-summarize').name)"
|
|
164
|
-
```
|
|
165
|
-
|
|
166
|
-
看到 `deep-read-summarize` 即包可正常加载。从源码开发时再运行 `npm test` 和 `npm run test:node`;测试不随 npm 包分发。
|
|
167
|
-
|
|
168
|
-
### 3. 一行命令喂入 demo 文件
|
|
45
|
+
先安装并启动一次 DSH Desktop,让它初始化桌面 profile;然后**完全退出应用**,使用 Desktop 随附的 DSH 命令安装:
|
|
169
46
|
|
|
170
47
|
```bash
|
|
171
|
-
|
|
48
|
+
dsh plugin --profile desktop add deep-read-summarize
|
|
172
49
|
```
|
|
173
50
|
|
|
174
|
-
|
|
51
|
+
安装完成后重新打开 DSH Desktop。随附命令不一定在系统 PATH 中:可使用安装目录下 `resources/runtime/cli/bin/dsh`(Windows 为 `dsh.cmd`)。界面和命令可能随宿主版本变化,详见 [DSH Desktop 官方说明](https://github.com/deepseek-ai/deepseek-harness/blob/master/apps/desktop/README.zh.md)。请勿在 DSH profile 目录中直接运行 `npm install` 或 `npm update`。
|
|
175
52
|
|
|
176
|
-
|
|
177
|
-
meta: deep-read-summarize
|
|
178
|
-
parsers: book, paper, video, web
|
|
179
|
-
```
|
|
53
|
+
运行精读还需要 DSH 中可用的模型和相应权限;不同来源可能需要额外工具。例如 PDF 文本提取可能需要 `pdftotext`,YouTube 字幕获取可能需要 `yt-dlp`,无字幕视频的本地转写可能需要 `uv` 和转写模型。
|
|
180
54
|
|
|
181
|
-
###
|
|
55
|
+
### 2. 发起一次精读
|
|
182
56
|
|
|
183
|
-
|
|
57
|
+
在 DSH 对话中输入,例如:
|
|
184
58
|
|
|
185
|
-
```
|
|
186
|
-
|
|
59
|
+
```text
|
|
60
|
+
请帮我精读这篇论文,并生成一份 Markdown 阅读笔记:
|
|
61
|
+
https://arxiv.org/abs/2307.09042
|
|
187
62
|
```
|
|
188
63
|
|
|
189
|
-
|
|
64
|
+
你也可以提供本地文件路径、网页或视频链接。如果需要,可以在请求中说明输出位置、希望保留的章节或是否需要时间戳。
|
|
190
65
|
|
|
191
|
-
|
|
66
|
+
支持插件工具的宿主会注册 `deep_read_summarize`;旧宿主使用插件提供的技能和 workflow 入口。精读工具返回笔记正文及建议路径,**实际写入文件需要由主代理完成**。生成后请确认文件已保存,并检查结果中是否报告内容缺口或质量问题。
|
|
192
67
|
|
|
193
|
-
|
|
194
|
-
## 用法
|
|
68
|
+
当工作流提取被包装的笔记时,可选字段 `draftContext` 会记录提取方式,以及模型在笔记前后附带的额外说明。这些额外文字不是经过原文核验的笔记正文。
|
|
195
69
|
|
|
196
|
-
|
|
70
|
+
<details>
|
|
71
|
+
<summary>直接调用工具的参数示例</summary>
|
|
197
72
|
|
|
198
|
-
```
|
|
73
|
+
```json
|
|
199
74
|
{
|
|
200
|
-
"input": "https://arxiv.org/abs/2307.09042",
|
|
201
|
-
"type": "
|
|
75
|
+
"input": "https://arxiv.org/abs/2307.09042",
|
|
76
|
+
"type": "paper",
|
|
202
77
|
"options": {
|
|
203
|
-
"
|
|
204
|
-
"
|
|
205
|
-
"maxChunks": 4, // 分块上限,1-12
|
|
206
|
-
"readConcurrency": 3, // 精读和分块核验的并发上限,1-12
|
|
207
|
-
"parallelQuality": false, // 显式启用并行原文核验;默认使用原有核验路径
|
|
208
|
-
"readCache": false, // 仅插件工具支持:启用跨次精读缓存
|
|
209
|
-
"readCacheIdentity": "", // 启用缓存时必填:provider/固定模型版本/影响输出的设置
|
|
210
|
-
"transcribe": true, // 视频:无字幕时自动本地转写(faster-whisper);false 则跳过转写,见「视频」节
|
|
211
|
-
"whisperModel": "small", // 视频转写模型档位:small | base | medium
|
|
212
|
-
"language": "zh", // 视频转写语言:纯英文视频可设 "en"
|
|
213
|
-
"device": "cpu", // 转写设备:cpu(默认)| auto | cuda;auto/cuda 需自备 CUDA 运行库,失败自动回退 cpu
|
|
214
|
-
"cpuThreads": 0, // 0 保持转写库默认值;1-64 可按实际硬件调优
|
|
215
|
-
"transcriptCache": true, // 音频内容与配置一致时复用本地逐字稿;false 强制每次推理
|
|
216
|
-
"maxRetries": 0, // 质量校验重试次数(默认 0 = 不重试,重试会明显变慢)
|
|
217
|
-
"frontmatter": "obsidian", // frontmatter 键集:obsidian(默认,配 Dataview)| generic(换掉 Hugo 保留键)| minimal
|
|
218
|
-
"requireCitations": true, // 关键结论是否必须标注出处
|
|
219
|
-
"includeTimestamps": false,
|
|
220
|
-
"outputDir": "./output", // 笔记输出目录(可指向 Obsidian 仓库或静态站点内容目录)
|
|
221
|
-
"tempDir": "./.tmp" // 临时文件目录
|
|
78
|
+
"maxChunks": 4,
|
|
79
|
+
"outputDir": "./output"
|
|
222
80
|
}
|
|
223
81
|
}
|
|
224
82
|
```
|
|
225
83
|
|
|
226
|
-
|
|
84
|
+
`type` 可选 `auto`、`book`、`paper`、`video` 或 `web`。显式指定类型可以跳过部分模糊输入的识别步骤。具体工具调用方式取决于 DSH 宿主;也可以直接在对话里表达需求。
|
|
227
85
|
|
|
228
|
-
|
|
229
|
-
|------|-------|
|
|
230
|
-
| 论文 | `https://arxiv.org/abs/2307.09042` |
|
|
231
|
-
| 书籍 | 本地路径,如 `~/books/xxx.pdf` |
|
|
232
|
-
| 视频 | `https://youtube.com/watch?v=xxx` |
|
|
233
|
-
| 网页 | `https://example.com/article` |
|
|
86
|
+
</details>
|
|
234
87
|
|
|
235
|
-
|
|
88
|
+
## 结果能信到什么程度?
|
|
236
89
|
|
|
237
|
-
|
|
90
|
+
工作流会规范化分块范围,检查已知原文行号的覆盖情况;成稿后,程序检查格式和篇幅,并由独立核验代理读取取得的文本,检查分块覆盖与关键引文。核验结果可通过 `qualityPassed`、`qualityChecks` 和 `qualityEvidence` 查看。
|
|
238
91
|
|
|
239
|
-
|
|
92
|
+
这些检查有边界:
|
|
240
93
|
|
|
241
|
-
|
|
242
|
-
|
|
243
|
-
|
|
244
|
-
|
|
245
|
-
| `author` / `year` | ✓ | ✓ | — |
|
|
246
|
-
| `type` | ✓ | — | — |
|
|
247
|
-
| `docType` | — | ✓ | — |
|
|
248
|
-
| `url` | ✓ | — | — |
|
|
249
|
-
| `sourceUrl` | — | ✓ | ✓ |
|
|
250
|
-
| `tags` | ✓ | ✓ | ✓ |
|
|
251
|
-
| `created` | ✓ | — | — |
|
|
252
|
-
| `date` | — | ✓ | ✓ |
|
|
253
|
-
| `status` | ✓ | ✓ | — |
|
|
94
|
+
- **`qualityPassed` 不是事实正确性的证明。**覆盖和原文真实性判断仍依赖核验代理实际读取与判断;重要结论、数字和引用请自行复核。
|
|
95
|
+
- **取得全文不等于理解了全文。**复杂表格、公式、图片以及提取错误可能影响结果;来源不完整或分块失败时,结果会报告缺口。
|
|
96
|
+
- **字幕或转写不等于音频原文。**自动字幕和语音识别可能漏句、听错数字或否定词;核验笔记与逐字稿不能证明逐字稿本身准确。
|
|
97
|
+
- **视频时间戳不能凭空推算。**可定位性取决于取得的字幕或转写是否包含时间信息。
|
|
254
98
|
|
|
255
|
-
|
|
99
|
+
## 常用配置
|
|
256
100
|
|
|
257
|
-
|
|
258
|
-
|
|
259
|
-
|
|
260
|
-
|
|
261
|
-
|
|
262
|
-
|
|
263
|
-
|
|
264
|
-
|
|
265
|
-
|
|
266
|
-
|
|
267
|
-
|
|
268
|
-
|
|
269
|
-
|
|
270
|
-
|
|
271
|
-
|
|
272
|
-
|
|
273
|
-
|
|
274
|
-
`options.transcribe`:**默认 `true`**(无字幕自动转写);设为 `false` 则跳过转写(只用字幕/desc 或降级)。
|
|
275
|
-
|
|
276
|
-
**转写工具链**:脚本用 `uv` 创建 **Python 3.12** 环境,从清华镜像安装 **`faster-whisper==1.2.1`**,通过 `HF_ENDPOINT=https://hf-mirror.com` 下载并缓存模型。健康的缓存环境直接运行,不要求 uv 仍在 PATH,也不再启动单独的 Python 导入探测。实际解释器和依赖版本记录在缓存目录的 `runtime.json`;Python 补丁版本、uv 和传递依赖未全部锁定,不能据此声称环境逐字一致。PyAV 可直接解码音频,无需单独 ffmpeg。三平台使用同一条命令 `node scripts/transcribe.js --audio <音频> --out <txt>`,默认 CPU;`options.device: "auto"` 可尝试自备的 CUDA,失败回退 CPU。缓存目录:Windows `%LOCALAPPDATA%\deep-read-summarize`、macOS `~/Library/Caches/deep-read-summarize`、Linux `$XDG_CACHE_HOME/deep-read-summarize`(未设置时用 `~/.cache`)。创建 Python 环境默认先用镜像,失败再直连 GitHub;`DRS_UV_PYTHON_MIRROR` 可覆盖镜像,空字符串表示直连。
|
|
277
|
-
|
|
278
|
-
> ⚠️ **首次转写会先下载模型(small 约 484MB,走 hf-mirror,非 GitHub),可能需要几分钟**。之后复用模型文件;新音频仍需完整推理。同一音频命中经过校验的逐字稿缓存时,才会跳过推理。**只有「无字幕」视频才会触发转写**(有字幕的视频直接用字幕,不触发、不下载)。
|
|
279
|
-
|
|
280
|
-
**逐字稿缓存与线程**:`options.transcriptCache` 默认开启。缓存键包含音频 SHA-256、受管理的本地模型快照、已安装依赖及解码配置;存储真实分段和起止时间,切换时间戳展示不必重转写。更改内容、配置或本地模型/依赖会失效;自定义本地模型目录、无法确认环境、损坏和过期记录均跳过缓存。缓存复用本地已有快照,不在线探测模型上游是否更新。逐字稿保存在上述缓存根目录的 `transcripts-v1`,单条上限 8 MiB、总量上限 128 MiB、有效期 30 天;清理在写入时执行。它不保存音频,也不会跳过后续精读与原文核验。
|
|
281
|
-
|
|
282
|
-
`options.cpuThreads` 为 0–64 的整数,默认 `0` 保持库的 CPU 线程策略。可用同一音频对比 4/6/8 线程,线程越多不一定越快。CLI 可直接使用:
|
|
283
|
-
|
|
284
|
-
```bash
|
|
285
|
-
node scripts/transcribe.js --audio sample.m4a --out transcript.txt --cpu-threads 8
|
|
286
|
-
node scripts/transcribe.js --audio sample.m4a --out transcript.txt --refresh-cache
|
|
287
|
-
node scripts/transcribe.js --audio sample.m4a --out transcript.txt --no-cache
|
|
288
|
-
node scripts/transcribe.js --clear-cache
|
|
289
|
-
```
|
|
290
|
-
|
|
291
|
-
`--clear-cache` 只清理逐字稿,不删除模型或 Python 环境。`--refresh-cache` 强制推理并更新缓存,`--no-cache` 禁用读写。成功调用输出一行 `metrics` JSON,报告 `cacheHit`、实际设备、音频时长,以及哈希、环境准备、依赖安装、Python、发布和总毫秒耗时;未命中时还报告导入、模型加载、准备(含解码/VAD)与完整分段迭代耗时。缓存命中不会冒用上次推理耗时。
|
|
292
|
-
|
|
293
|
-
笔记的 `qualityPassed` 核验笔记与取得的原文,不证明 ASR 听写准确;调整转写路径仍须对照音频检查误字、漏段、数字、否定句与时间戳。
|
|
294
|
-
|
|
295
|
-
**质量/速度**:`small` + `int8` 量化 + `VAD` 静音过滤,中文质量可用且 CPU 友好。**有字幕的视频不转写(快)**;无字幕视频转写,CPU 上约为视频时长的 0.5–2×。
|
|
296
|
-
|
|
297
|
-
**失败处理**:安装/下载失败则**明确报错并降级**(提示手动提供转写文本),不静默、不长期阻塞。此时可用 `options.transcribe: false` 跳过转写。
|
|
298
|
-
|
|
299
|
-
**怎么知道本次用了什么来源**:来源信息**不写进笔记**(保证笔记干净),透出在:① 运行日志的 `[source] <值> -> <标签>` 行;② 返回结果里的 `textSource` 字段(`subtitle / transcription / desc / manual`)。
|
|
300
|
-
|
|
301
|
-
---
|
|
302
|
-
|
|
303
|
-
## 差异与影响因素(时长与内容为何可能不同)
|
|
304
|
-
|
|
305
|
-
**输出时长与内容会因「模型」和「输入」不同而有明显差异,属正常现象**,请知悉:
|
|
306
|
-
|
|
307
|
-
### 模型
|
|
308
|
-
- **ASR 模型档位**:`small`(默认,中文可用)→ `base`(更快、质量略降)→ `medium`(更好、更慢)。可用 `options.whisperModel` 调整;下载量与速度随模型变大而增长。
|
|
309
|
-
- **语言/口音**:中/英/混合语言、方言、口音、重音 → 转写**准确度与耗时不同**;纯英文视频可设 `language: "en"`。
|
|
310
|
-
- **精读 LLM**:用宿主 DSH 的模型,不同上下文/推理模型 → 输出**质量、篇幅、速度**不同。
|
|
311
|
-
- **非确定性**:LLM 与 ASR 均带随机性,**同一输入重复跑可能得到略有差异**的结果(内容/篇幅)。
|
|
312
|
-
|
|
313
|
-
### 输入
|
|
314
|
-
- **视频**:
|
|
315
|
-
- 有无**公开字幕**是最大差异点——有公开字幕 = 秒级;只有登录态 AI 字幕/无字幕 = 触发转写,**明显变慢**。
|
|
316
|
-
- **时长**:越长转写越久(CPU 约 0.5–2× 视频时长)。
|
|
317
|
-
- **音质/噪杂/低音量/纯 BGM/无人声**:转写易错或**结果空**,此时请手动提供转写文本。
|
|
318
|
-
- **论文/书籍/网页**:
|
|
319
|
-
- 格式:PDF/EPUB/MOBI/HTML/arXiv;**扫描版 OCR、坏 PDF、公式/图表密集** → 提取质量与耗时不同。
|
|
320
|
-
- **术语密度/篇幅** → 分块数与精读深度不同。
|
|
321
|
-
- **分块结构**:不同类型分块方式不同(章节/主题/段落),影响**输出结构**与覆盖。
|
|
322
|
-
|
|
323
|
-
### 硬件
|
|
324
|
-
- **GPU vs CPU**:GPU 收益依赖显卡、运行库、模型与音频;设备可见不代表 CUDA 推理可用,应以实际耗时与文本对照为准。
|
|
325
|
-
|
|
326
|
-
### 其他
|
|
327
|
-
- **首次 vs 复用**:首次要下模型(约 484MB),之后缓存复用。
|
|
328
|
-
- **Token/成本**:分块数/篇幅/引证决定 token 消耗;`fastMode`/`maxChunks` 可省。
|
|
329
|
-
- **引用/编造**:转写或 OCR 的错词可能被当作「原文」引用,**关键引用请复核**。
|
|
330
|
-
- **边界**:纯 BGM、失真音频 → 转写空/差;无字幕且转写不可用 → 降级提示人工提供转写文本。
|
|
331
|
-
|
|
332
|
-
---
|
|
333
|
-
|
|
334
|
-
## 失败怎么处理
|
|
335
|
-
|
|
336
|
-
分两类:
|
|
337
|
-
|
|
338
|
-
- **配置错误**(缺 input、type 非法、options 格式错):直接抛异常终止,不产出半成品。
|
|
339
|
-
- **内容问题**(抓取失败、某块精读失败):返回 `{ ok: false, stage, fatal: false }`,由调用方决定。某一块失败时跳过它、在成稿里标注缺口,不整体中断。
|
|
340
|
-
|
|
341
|
-
---
|
|
342
|
-
|
|
343
|
-
## 保持质量的提速
|
|
344
|
-
|
|
345
|
-
- 支持的新宿主优先使用 `deep_read_summarize`,模型只提交参数,省去复制整份工作流脚本。旧宿主自动保留原入口。
|
|
346
|
-
- 精读仍完整覆盖已知原文,并发数默认最多为三个任务;空闲槽位立即领取下一块。优先按字符数均衡工作量,统计不可用时回退按行数均衡。
|
|
347
|
-
- QC 继续独立读取原文;可通过 `parallelQuality: true` 让多个分块并行核验原文和全部引文,另行检查整篇术语与语言;默认仍使用原有核验路径。缺总行数、精读失败或只有视频简介等问题不能靠改写笔记解决,不再浪费全文修订轮次。
|
|
348
|
-
- 视频 `textSource: "desc"` 明确为降级来源,不能取得完整精读的质量通过状态。B站多 P 链接按 `p` 选择对应 CID、分 P 标题和时长。
|
|
349
|
-
- 返回 `timings` 提供各阶段毫秒耗时,`readTimings` 提供每个精读块的行号、耗时和是否成功。用同一资料、模型、篇幅和质量门槛比较;调度测试不能当成真实 LLM 加速比例。
|
|
350
|
-
- `readConcurrency` 控制精读并发,不改变分块或质量核验的要求;启用 `parallelQuality` 时也限制核验任务数,默认为 3。实际分块数至少为 4 且宿主支持时,可尝试设为 4,比较总耗时、限流及失败情况;并发越高不一定越快。
|
|
351
|
-
|
|
352
|
-
**跨次精读缓存**默认关闭,仅 `deep_read_summarize` 插件工具入口支持,裸 workflow 不启用。设 `readCache: true` 时必须同时设置 `readCacheIdentity`,包含供应商、固定模型版本和所有影响输出的设置;宿主无法验证该身份,模型或设置变化时必须更换。缓存按原文内容、分块提示及身份匹配,仅在质量检查通过后写入;命中后仍执行独立原文核验。`readTimings` 的 `cacheHit` 表示是否命中。缓存是明文,位于 `tempDir/.read-cache-v1`,可能包含原文摘录;超过 30 天、64 MiB 总量或 1 MiB 单条限制会被清理或跳过,不需要时可删除该目录。
|
|
101
|
+
| 选项 | 默认值 | 用途 |
|
|
102
|
+
| --- | --- | --- |
|
|
103
|
+
| `minWords` | `2500` | 最低篇幅要求;检查规则按中文字符和其他文字的词计算 |
|
|
104
|
+
| `fastMode` | `false` | 开启后省略批判性分析、个人应用和延伸阅读章节 |
|
|
105
|
+
| `maxChunks` | `4` | 分块数量上限,最大为 12;不是并发数 |
|
|
106
|
+
| `readConcurrency` | `3` | 精读并发上限;并发更高不一定更快 |
|
|
107
|
+
| `maxRetries` | `0` | 未通过质量检查时的修订次数;成稿成功后默认执行一次核验,不做修订 |
|
|
108
|
+
| `outputDir` | `./output` | 建议的笔记输出目录,由主代理完成写入 |
|
|
109
|
+
| `requireCitations` | `true` | 要求关键引用具备可核验的来源信息 |
|
|
110
|
+
| `includeTimestamps` | `false` | 视频笔记是否要求时间戳 |
|
|
111
|
+
| `transcribe` | `true` | 视频没有可用字幕时,尝试本地转写 |
|
|
112
|
+
| `whisperModel` / `language` | `small` / `zh` | 选择转写模型和语言;英文视频可显式指定 `en` |
|
|
113
|
+
| `device` / `cpuThreads` | `cpu` / `0` | 选择转写设备和 CPU 线程策略 |
|
|
114
|
+
| `transcriptCache` | `true` | 相同音频及匹配配置时复用已验证的转写缓存 |
|
|
115
|
+
| `parallelQuality` | `false` | 显式启用并行原文核验;默认保留原核验路径 |
|
|
116
|
+
| `readCache` | `false` | 可选的跨次精读缓存;仅插件工具入口支持 |
|
|
353
117
|
|
|
354
|
-
|
|
118
|
+
开启 `readCache` 时,还必须提供 `readCacheIdentity`,写明供应商、固定模型版本及影响输出的设置;这些信息变化时需更换身份。该身份由调用者提供,宿主无法自动验证。缓存为本地明文,可能包含原文摘录;命中后仍会执行独立原文核验。
|
|
355
119
|
|
|
356
|
-
|
|
120
|
+
其他选项包括 `frontmatter`(`obsidian`、`generic`、`minimal`)和 `tempDir`。高级选项、取值范围、转写缓存和自定义解析器可参考[完整配置与技术参考](https://github.com/PensiveFei/deep-read-summarize/blob/main/docs/README-reference.zh.md)。
|
|
357
121
|
|
|
358
|
-
|
|
122
|
+
## 时间、费用与隐私
|
|
359
123
|
|
|
360
|
-
|
|
124
|
+
- **时间**取决于内容长度、获取方式、分块数量、模型和宿主并发。没有字幕的视频需要额外转写,首次使用还可能下载转写模型。
|
|
125
|
+
- **费用**取决于你配置的模型、输入与输出量;本项目不能保证固定的耗时或费用。
|
|
126
|
+
- **隐私**:本地语音转写在本机运行,但后续精读使用你在 DSH 中配置的模型。若使用云端模型,原文、字幕、笔记或相关上下文可能发送给对应服务商;请先确认其数据处理条款。
|
|
127
|
+
- **本地文件**:临时原文、转写和可选缓存可能保存在设备上;处理敏感资料前请确认目录权限与清理方式。
|
|
361
128
|
|
|
362
|
-
|
|
129
|
+
## 出问题时
|
|
363
130
|
|
|
364
|
-
|
|
131
|
+
- **插件不可用**:确认已在正确的 DSH profile 安装、重启了桌面应用,并检查宿主版本和插件兼容信息。
|
|
132
|
+
- **获取失败或笔记缺段**:确认链接可访问、所需工具已安装;查看返回的阶段、来源状态和失败分块。
|
|
133
|
+
- **只有视频简介**:说明没有取得可确认的完整字幕或逐字稿;请检查字幕与转写条件,或提供文本。
|
|
134
|
+
- **质量检查未通过**:查看 `qualityIssues` 和 `qualityEvidence`,必要时对照原文修订;不要把未核实的笔记当作完整结论。
|
|
365
135
|
|
|
366
|
-
-
|
|
367
|
-
- 子代理写文件需要相应权限;如果权限不够,workflow 会把内容返回,由主代理负责落盘。
|
|
368
|
-
- **本地转写**:视频转写(faster-whisper)在**本机**运行,音频/字幕**不出本地**;抓取视频元数据/字幕/音频时才会向对应平台发起网络请求。
|
|
369
|
-
- 这个仓库只有流程本身:workflow 定义、解析器代码、提示词模板、schema。**不含任何受版权保护内容的提取结果。** 测试用的 fixture 是自写的公共领域寓言。用本工作流处理有版权的材料时,产出物的使用责任在你。
|
|
136
|
+
仍有问题?欢迎在 [GitHub Issues](https://github.com/PensiveFei/deep-read-summarize/issues) 提供操作系统、DSH 与插件版本、输入类型和错误信息。请先去掉密钥、私有链接和个人资料。
|
|
370
137
|
|
|
371
|
-
|
|
138
|
+
## 开发与贡献
|
|
372
139
|
|
|
373
|
-
|
|
140
|
+
源码开发请在**独立的项目目录**进行,而不是在 DSH profile 目录运行 npm:
|
|
374
141
|
|
|
375
142
|
```bash
|
|
376
|
-
|
|
377
|
-
|
|
378
|
-
npm
|
|
379
|
-
npm
|
|
143
|
+
git clone https://github.com/PensiveFei/deep-read-summarize.git
|
|
144
|
+
cd deep-read-summarize
|
|
145
|
+
npm ci
|
|
146
|
+
npm test
|
|
147
|
+
npm run test:node
|
|
148
|
+
npm run lint
|
|
149
|
+
npm run validate
|
|
380
150
|
```
|
|
381
151
|
|
|
382
|
-
|
|
383
|
-
|
|
384
|
-
改动说明见 CHANGELOG.md,贡献规范见 CONTRIBUTING.md。
|
|
385
|
-
|
|
386
|
-
---
|
|
387
|
-
|
|
388
|
-
## 兼容性
|
|
389
|
-
|
|
390
|
-
**已验证的宿主:DSH 0.2.0-rc.2**(Node 24)。本仓库的依赖面只有两处:
|
|
391
|
-
|
|
392
|
-
| 依赖面 | 现行契约 | 本仓库的用法 |
|
|
393
|
-
| --- | --- | --- |
|
|
394
|
-
| workflow 脚本钩子 | `agent()` / `pipeline()` / `parallel()` / `phase()` / `log()` / `args` | 只用了 `agent/parallel/phase/log/args`;`agent()` 选项只用 `label/phase/schema`(引擎只接受 `label/phase/schema/provider/model`,其它选项会被判为 fatal) |
|
|
395
|
-
| JSON Schema 子集 | `type / properties / required / additionalProperties / items / enum / const / oneOf` + 注解键 | 两个 `agent()` schema 已用宿主真实的 `assertObjectJsonSchema` 实测通过 |
|
|
396
|
-
|
|
397
|
-
两点容易踩的契约细节:
|
|
398
|
-
|
|
399
|
-
- **脚本沙箱没有文件系统/网络/定时器/require**——只能协调子代理;笔记落盘由主代理完成(见上文 ⚠️)。
|
|
400
|
-
- **违反上述子集不是降级而是终止**:引擎抛 `UNSUPPORTED_SCHEMA`,整条 workflow 直接失败。仓库的 `npm test` 里有对应回归(含反向断言,确保校验器不是空放行)。
|
|
152
|
+
项目使用解析器处理不同输入类型,支持自定义解析器。代码和测试见[仓库](https://github.com/PensiveFei/deep-read-summarize),版本变化见 [CHANGELOG](https://github.com/PensiveFei/deep-read-summarize/blob/main/CHANGELOG.md),贡献方式见 [CONTRIBUTING](https://github.com/PensiveFei/deep-read-summarize/blob/main/CONTRIBUTING.md)。
|
|
401
153
|
|
|
402
|
-
|
|
154
|
+
**兼容性:**本项目此前验证过 DSH `0.2.0-rc.2` 的相关宿主契约;DSH 接口可能变化,其他版本请以实际测试和兼容说明为准。
|
|
403
155
|
|
|
404
|
-
|
|
156
|
+
## 版权与声明
|
|
405
157
|
|
|
406
|
-
|
|
158
|
+
项目代码采用 [MIT License](https://github.com/PensiveFei/deep-read-summarize/blob/main/LICENSE)。示例中引用的论文、视频和短引文仍受其各自权利与授权条件约束。
|
|
407
159
|
|
|
408
|
-
|
|
160
|
+
deep-read-summarize 是独立的第三方项目,与 DeepSeek 或 DeepSeek Harness 官方没有隶属、认可或赞助关系。
|
package/docs/RELEASE.md
CHANGED
|
@@ -155,7 +155,9 @@ npm view deep-read-summarize --prefer-online # 验证线
|
|
|
155
155
|
| v0.3.19 | npm 已发布 | 修复 B04–B10,并让质量检查结合程序门禁和可回查的原文证据(O01)。 |
|
|
156
156
|
| v0.4.0 | npm 已发布 | 保留完整精读与独立原文核验,减少脚本搬运、并发空等和无效修订,并修复来源质量判断与视频分P等问题。 |
|
|
157
157
|
| v0.5.0 | npm 已发布 | 无字幕视频新增逐字稿内容缓存、转写阶段计时和 CPU 线程配置,保留默认精读与原文核验门槛。 |
|
|
158
|
-
|
|
|
158
|
+
| v0.6.0 | npm 已发布 | 新增可配置并发、字符均衡分块与可选的并行原文核验和跨次精读缓存,保留原有默认核验路径。 |
|
|
159
|
+
| v0.6.1 | npm 已发布 | 修复普通执行路径的结果序列化错误,避免已生成的精读笔记在返回宿主时被丢弃。 |
|
|
160
|
+
| **v0.6.2** | **npm 已发布(当前)** | 修复成稿包含前言或外层 Markdown 围栏时,笔记被误判为格式、篇幅和引用不合格的问题。 |
|
|
159
161
|
| v1.0.0 | 计划 | API 稳定后发布 |
|
|
160
162
|
|
|
161
163
|
> 早期迭代用 0.x 表达不稳定;API 稳定后再发 1.0.0。
|
package/lib/quality.js
CHANGED
|
@@ -1,7 +1,58 @@
|
|
|
1
1
|
'use strict';
|
|
2
2
|
|
|
3
|
-
//
|
|
3
|
+
// These functions are self-contained so workflow.js can inline them into the
|
|
4
4
|
// coordination sandbox. They never evaluate YAML or read files themselves.
|
|
5
|
+
function extractNote(reply) {
|
|
6
|
+
const unchanged = { note: reply, context: null };
|
|
7
|
+
if (typeof reply !== 'string' || /^\s*---[ \t]*\r?\n/.test(reply)) return unchanged;
|
|
8
|
+
const lines = reply.split('\n');
|
|
9
|
+
function line(index) { return lines[index].replace(/\r$/, ''); }
|
|
10
|
+
function slice(start, end) { return lines.slice(start, end).join('\n').replace(/\r$/, ''); }
|
|
11
|
+
function outsideIsProse(value) {
|
|
12
|
+
return value.length <= 512 && !/^(?: {0,3}(?:#{1,6}[ \t]|>|[-+*][ \t]|\d+[.)][ \t]|\||[\x60~]{3,})|[ \t]*---[ \t]*$)/m.test(value);
|
|
13
|
+
}
|
|
14
|
+
function looksLikeNote(value) {
|
|
15
|
+
const front = value.match(/^---[ \t]*\r?\n([\s\S]*?)\r?\n---[ \t]*(?:\r?\n|$)/);
|
|
16
|
+
return !!front && /^title:[ \t]*\S/m.test(front[1]) && /^#[ \t]+\S/m.test(value.slice(front[0].length));
|
|
17
|
+
}
|
|
18
|
+
function extracted(note, kind, before, after) {
|
|
19
|
+
const prefix = before.trim(), suffix = after.trim();
|
|
20
|
+
return { note, context: { kind, before: prefix, after: suffix } };
|
|
21
|
+
}
|
|
22
|
+
|
|
23
|
+
// A short plain-text preamble can precede an otherwise ordinary note,
|
|
24
|
+
// including one with its own code examples. Preserve that preamble.
|
|
25
|
+
for (let i = 1; i < lines.length; i++) {
|
|
26
|
+
if (!/^---[ \t]*$/.test(line(i))) continue;
|
|
27
|
+
const prefix = slice(0, i);
|
|
28
|
+
if (!outsideIsProse(prefix)) break;
|
|
29
|
+
const candidate = lines.slice(i).join('\n');
|
|
30
|
+
if (looksLikeNote(candidate)) return extracted(candidate, 'preamble', prefix, '');
|
|
31
|
+
}
|
|
32
|
+
|
|
33
|
+
// Treat only a single, closed top-level Markdown fence as an outer wrapper.
|
|
34
|
+
// Longer or differently marked inner fences remain part of the note.
|
|
35
|
+
const blocks = [];
|
|
36
|
+
for (let i = 0; i < lines.length; i++) {
|
|
37
|
+
const open = line(i).match(/^ {0,3}([\x60]{3,}|~{3,})(.*)$/);
|
|
38
|
+
if (!open) continue;
|
|
39
|
+
let end = i + 1;
|
|
40
|
+
for (; end < lines.length; end++) {
|
|
41
|
+
const close = line(end).match(/^ {0,3}([\x60]+|~+)[ \t]*$/);
|
|
42
|
+
if (close && close[1][0] === open[1][0] && close[1].length >= open[1].length) break;
|
|
43
|
+
}
|
|
44
|
+
if (end === lines.length) return unchanged;
|
|
45
|
+
blocks.push({ start: i, end, info: open[2].trim() });
|
|
46
|
+
i = end;
|
|
47
|
+
}
|
|
48
|
+
if (blocks.length !== 1 || !/^(?:markdown|md)?$/i.test(blocks[0].info)) return unchanged;
|
|
49
|
+
const block = blocks[0], before = slice(0, block.start), after = slice(block.end + 1);
|
|
50
|
+
const candidate = slice(block.start + 1, block.end)
|
|
51
|
+
.replace(/^(?:[ \t]*\r?\n)+/, '').replace(/(?:\r?\n[ \t]*)+$/, '');
|
|
52
|
+
if (!outsideIsProse(before) || !outsideIsProse(after) || !looksLikeNote(candidate)) return unchanged;
|
|
53
|
+
return extracted(candidate, 'fenced', before, after);
|
|
54
|
+
}
|
|
55
|
+
|
|
5
56
|
function checkNoteStructure(note, options) {
|
|
6
57
|
const opts = options || {};
|
|
7
58
|
const issues = [];
|
|
@@ -215,4 +266,4 @@ function validateSourceCheck(check, context) {
|
|
|
215
266
|
return { passed: issues.length === 0 && gates.every(gate => results[gate]), checks: results, issues, chunkChecks, citationChecks };
|
|
216
267
|
}
|
|
217
268
|
|
|
218
|
-
module.exports = { checkNoteStructure, validateSourceCheck };
|
|
269
|
+
module.exports = { extractNote, checkNoteStructure, validateSourceCheck };
|