dsh-knit 0.19.0 → 0.20.0
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- package/CHANGELOG.md +285 -0
- package/README.en.md +298 -217
- package/README.md +184 -113
- package/SECURITY.md +2 -2
- package/package.json +7 -3
- package/src/client/client.js +742 -63
- package/src/host/context.js +29 -1
- package/src/host/index.js +124 -13
- package/src/host/passage.js +408 -0
- package/src/host/tool.js +104 -23
- package/test/client.test.mjs +793 -12
- package/test/context/fixture.mjs +2 -5
- package/test/deep-context.test.mjs +447 -0
- package/test/deep-eval.test.mjs +90 -0
- package/test/deep-scale.test.mjs +64 -0
- package/test/eval/deep.mjs +322 -0
- package/test/eval/fixture.mjs +6 -9
- package/test/fixture.mjs +21 -1
- package/test/harness.mjs +63 -4
- package/test/host.test.mjs +2 -2
- package/test/icon.test.mjs +11 -8
- package/test/tool.test.mjs +247 -18
package/README.md
CHANGED
|
@@ -1,28 +1,59 @@
|
|
|
1
1
|
# Knit
|
|
2
2
|
|
|
3
|
-
>
|
|
4
|
-
> Knit 把它们放到对话旁边 —— 你正在聊什么,相关的那篇就在最上面。
|
|
3
|
+
> **面向 AI Coding Agent 的任务感知工作区上下文检索与生命周期追踪。**
|
|
5
4
|
>
|
|
6
|
-
>
|
|
5
|
+
> Task-aware workspace context retrieval and lifecycle tracking for AI coding agents.
|
|
6
|
+
|
|
7
|
+
Knit 接的是**当前任务**和**整个工作区**之间那一层:从工作区里找出最相关的文档、源码与媒体,
|
|
8
|
+
组织成 **主要 / 辅助 / 相关** 三层上下文(Context Pack),交给面板、也交给 agent;
|
|
9
|
+
再持续追踪这些上下文**有没有被读、被读之后有没有变**。
|
|
10
|
+
|
|
11
|
+
**找到 → 组织 → 追踪**,三步都在本机用字符串运算完成 —— 不调模型、不联网、零延迟、内容不出本机。
|
|
12
|
+
|
|
13
|
+
```text
|
|
14
|
+
当前任务
|
|
15
|
+
│
|
|
16
|
+
工作区检索
|
|
17
|
+
┌────────────┼────────────┐
|
|
18
|
+
▼ ▼ ▼
|
|
19
|
+
主要上下文 辅助上下文 相关上下文
|
|
20
|
+
└────────────┼────────────┘
|
|
21
|
+
▼
|
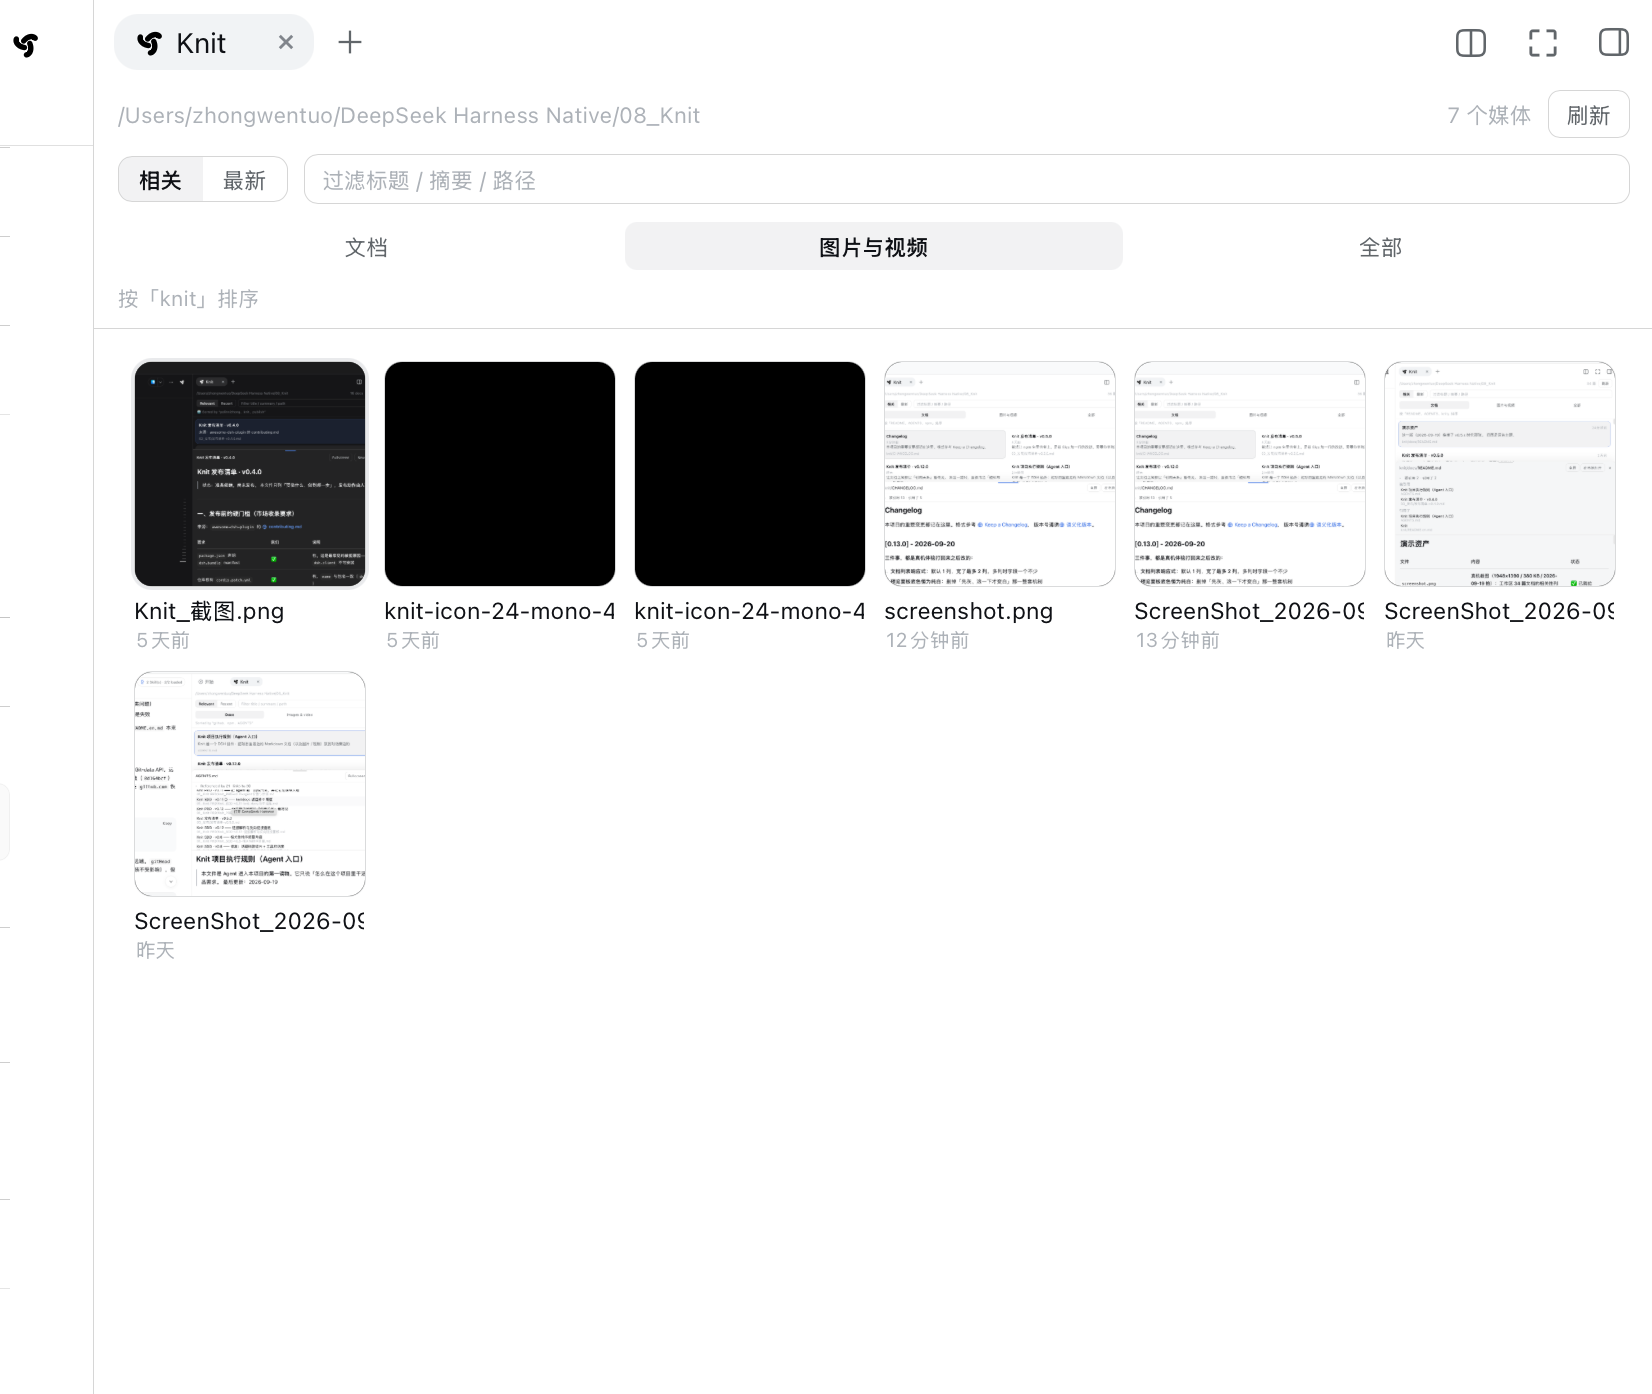
|
22
|
+
Context Pack ──► `knit_docs` 工具(给 agent)
|
|
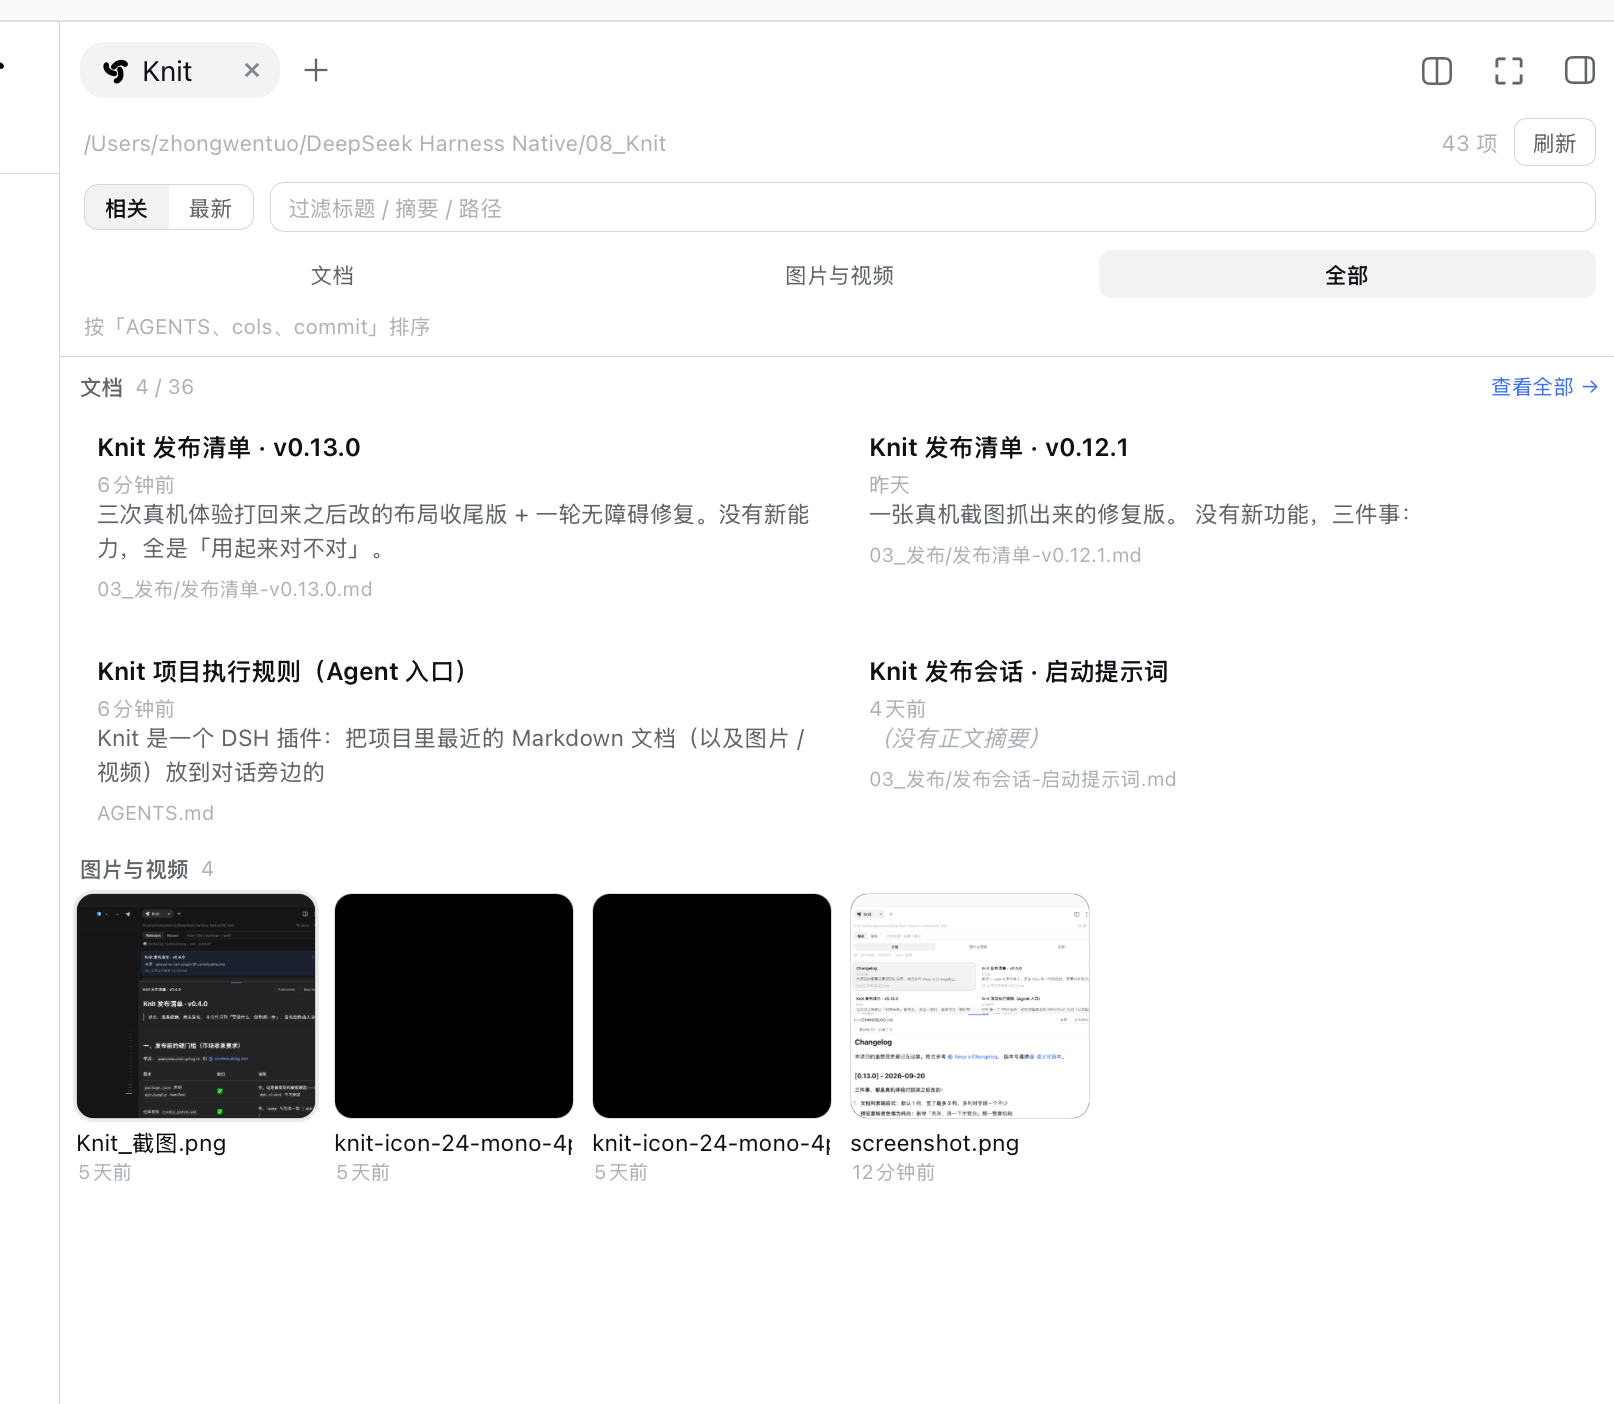
23
|
+
▼
|
|
24
|
+
Agent 读取
|
|
25
|
+
▼
|
|
26
|
+
读取证据 · Context Epoch
|
|
27
|
+
▼
|
|
28
|
+
工作区发生变化
|
|
29
|
+
▼
|
|
30
|
+
重新读取 · 生命周期
|
|
31
|
+
```
|
|
32
|
+
|
|
33
|
+
> **它不是「更聪明的最近文件列表」,也不是「代码浏览器」。**
|
|
34
|
+
> 最近文件记的是「你点开过什么、哪个更新」;Knit 回答的是
|
|
35
|
+
> **当前这个任务,项目里哪些东西最值得先看 —— 以及看过之后,事情变成了什么样。**
|
|
7
36
|
|
|
8
|
-
|
|
9
38
|
|
|
10
39
|
*真机截图(不是原型):同一个工作区,这张停在 **「代码」档** —— v0.19 起,源码和 Markdown 一样是一等公民。*
|
|
11
|
-
|
|
12
|
-
|
|
40
|
+
*每行下面的副行写着它是怎么被命中的(`直接命中 classification · changelog` / `路径命中 agents · classification`),*
|
|
41
|
+
*以及**命中段** —— 这次查询在这份文件里最像的是哪一段(`命中段 24–38`)。*
|
|
42
|
+
*点一行**就地**展开预览,并且**直接停在那一段**上:这里是 `knit/src/host/passage.js`,行号栏 + 语法高亮,*
|
|
43
|
+
*命中的那几行带一条灰底横带;预览头里只有路径和四个动作(复制 / 全屏 / 本地打开 / 关闭)。*
|
|
13
44
|
*头部只放路径、一个计数与两个开关;列表按「相关」还是「最新」排,由左边那一对页签决定 —— 按「相关」时排的就是你正在聊什么。*
|
|
14
|
-
*v0.14
|
|
45
|
+
*v0.14 起列表永远单列:最左边独立一列是序号(与标题第一行垂直居中),右边第一行=*
|
|
15
46
|
*Primary 点 + 标题 + 相对时间(**时间靠右**),摘要再往下;**路径只出现在预览头里**(目录收敛成一个 `…/` 占位,完整相对路径在悬停提示里),列表行不再重复。*
|
|
16
47
|
*序号是**跨三档连续**的一条(先看 / 辅助 / 背景);「其他相关文档」不在包里、不编号,那一格用一个 `·` 占位 ——*
|
|
17
48
|
*空着会被读成「漏了一个号」(2026-10-01)。*
|
|
18
49
|
|
|
19
|
-
|
|
20
51
|
|
|
21
|
-
|
|
22
|
-
|
|
23
|
-
|
|
24
|
-
|
|
25
|
-
|
|
52
|
+
*排序跟着对话走(同一个工作区、新开的一个会话):聊天里先聊过一轮发布清单,顶上几条就是发布清单那一族;*
|
|
53
|
+
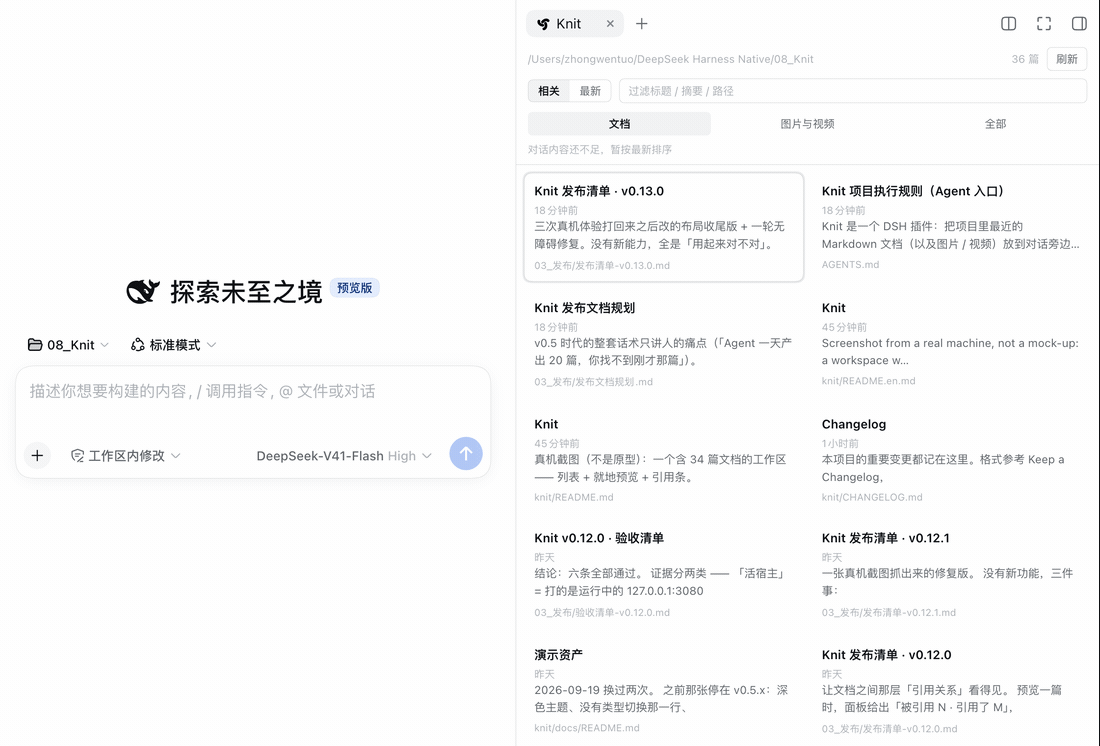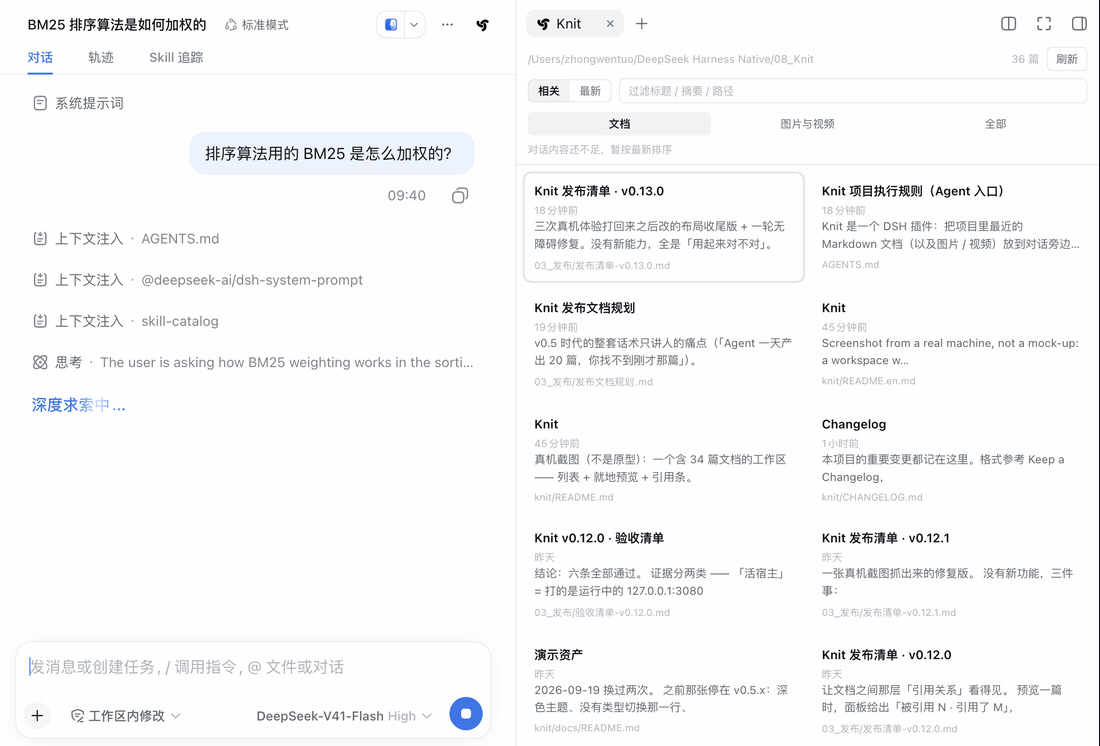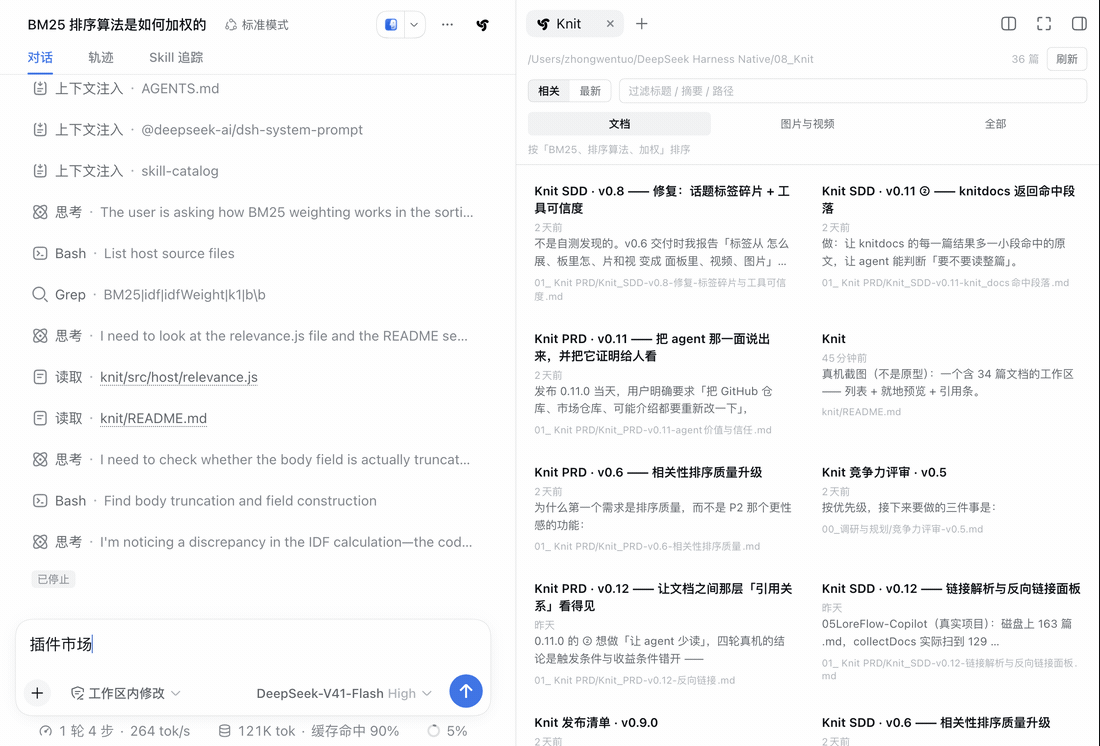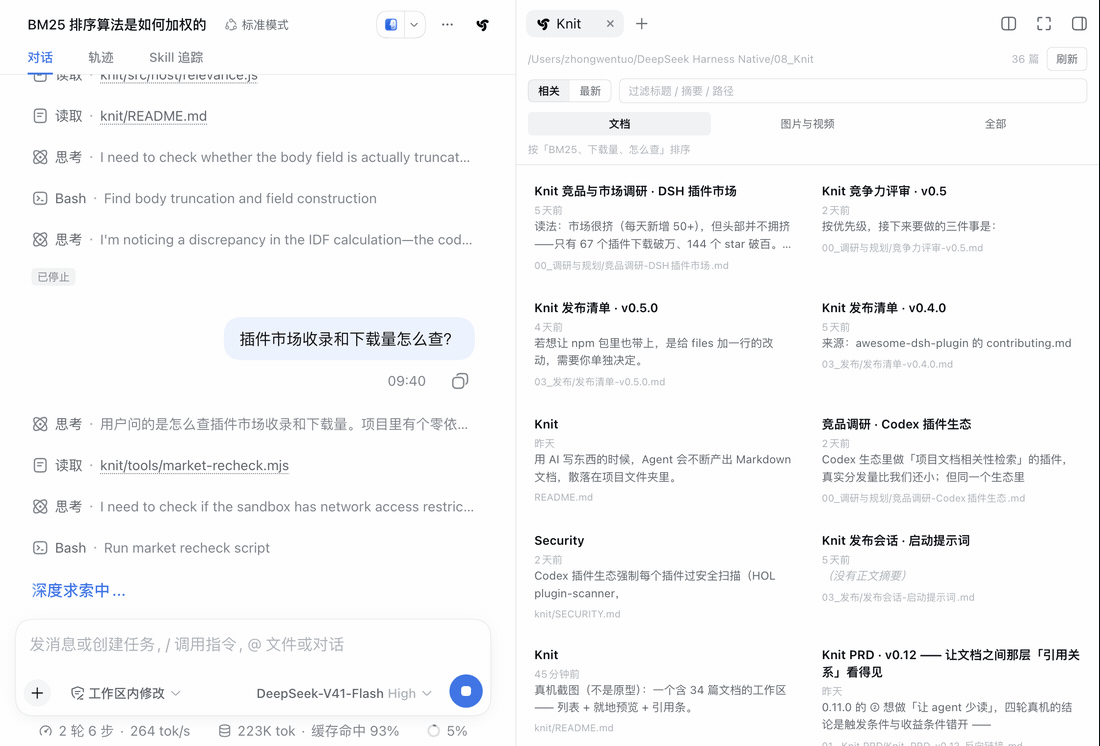
*再问一句「Knit 里 BM25 的字段权重是怎么定的?」,列表整个换成 BM25 那一族 ——*
|
|
54
|
+
*分组标题与**跨三档连续的序号**随之一起出现,每篇下面多一行「为什么」(命中在哪、怎么命中的、命中段是哪一段)。*
|
|
55
|
+
*⚠️ 面板是**每 5 秒轮询一次**的,重排不是发消息那一瞬间:这一屏里顶上几条是这一轮对话推进之后才整个换掉的*
|
|
56
|
+
*(中间那几十秒被剪掉了)。动图比真实时间快。*
|
|
26
57
|
|
|
27
58
|
扫整个项目文件夹的文档 / 代码 / 图片 / 视频 · 排序跟着对话走 · 不调模型、不联网
|
|
28
59
|
|
|
@@ -32,93 +63,47 @@ dsh plugin --profile web add dsh-knit
|
|
|
32
63
|
|
|
33
64
|
---
|
|
34
65
|
|
|
35
|
-
##
|
|
36
|
-
|
|
37
|
-
**是的,但有两个关键区别:**
|
|
38
|
-
|
|
39
|
-
1. **范围**:最近打开列表只记你**点开过**的文件;Knit 扫**整个项目文件夹**。
|
|
40
|
-
重启 DSH、新开会话、跨天回来,它都还在。
|
|
41
|
-
2. **排序**:它按时间排;Knit 按**你正在聊什么**排。
|
|
42
|
-
|
|
43
|
-
三句话说完它是什么:
|
|
44
|
-
|
|
45
|
-
1. 扫**整个项目文件夹**的文档与代码,不只是这一轮生成的那几篇 —— 重启、换会话、跨天都还在
|
|
46
|
-
2. 排序**跟着你正在聊什么走**:聊架构,架构文档浮上来;聊 loader 的 bug,`plugin-loader.ts` 浮上来
|
|
47
|
-
3. **不调模型、不联网**:全是本地字符串运算,零延迟、零成本、文档不出本机
|
|
48
|
-
|
|
49
|
-
---
|
|
50
|
-
|
|
51
|
-
## 「相关」是怎么算出来的
|
|
52
|
-
|
|
53
|
-
没有玄学,就是字符串运算。三步:
|
|
54
|
-
|
|
55
|
-
**1. 读当前会话。** 取最近 6 条用户 / 助手消息,只认真人输入的用户消息
|
|
56
|
-
(`agent.inject()` 塞进来的合成上下文不算,那会把话题带偏)。越新的消息权重越高:3 / 2 / 1 / 1 …
|
|
57
|
-
|
|
58
|
-
**2. 抽关键词。**
|
|
59
|
-
|
|
60
|
-
- **英文词**:取值很高,出现 1 次就要(`chokidar`、`mtime` 这种精确词)
|
|
61
|
-
- **中文 2/3-gram**:出现 2 次,或出现在最新那条消息里
|
|
62
|
-
- **丢掉跨词边界的碎片**:中文没有词边界,n-gram 会把相邻两个词的字粘起来
|
|
63
|
-
(「图片和」「个插」「的排」)。这类碎片有个共同特征 —— **首字或尾字是纯虚词**,
|
|
64
|
-
一律丢掉。不丢的话它们会占满候选位,把「图片」「排序」这些真词全挤出去
|
|
65
|
-
- 虚词表过滤 + 贪心去重叠(选了「相关性排序」就不再算「相关性」和「排序」)
|
|
66
|
+
## 为什么需要它
|
|
66
67
|
|
|
67
|
-
|
|
68
|
+
> Agent 一天产出 20 篇文档,你找不到刚才那篇。
|
|
68
69
|
|
|
69
|
-
|
|
70
|
-
|
|
71
|
-
再按字段加权求和:标题 ×4 + 摘要 ×2 + 正文前 2500 字 ×1
|
|
72
|
-
每个字段都按 BM25 饱和 + 长度归一化(k1 = 1.2,b = 0.3 / 0.5 / 0.75)
|
|
73
|
-
再叠 10% 的时间新鲜度微调(主排序仍是相关性)
|
|
74
|
-
```
|
|
70
|
+
这是它最开始要解决的问题:**产出速度超过了人翻目录的速度**。
|
|
71
|
+
DSH 自带的「最近文件」只记你点开过什么;一轮对话结束,前面那几篇就沉下去了。
|
|
75
72
|
|
|
76
|
-
|
|
73
|
+
Knit 换了个问法:**不看「谁新」,看「和现在这件事有多相关」**。
|
|
74
|
+
它扫的是**整个工作区**(不是这一轮生成的那几篇),按你正在聊的内容排序 ——
|
|
75
|
+
重启 DSH、换会话、跨天回来,它都还在。
|
|
77
76
|
|
|
78
|
-
|
|
79
|
-
|
|
80
|
-
|
|
81
|
-
- 命中次数封顶 6 次是个手写硬拐点;`k1` / `b` 才是为这件事设计的
|
|
77
|
+
后来问题往前长了一步:真要动一个功能时,最该先看的往往不是文档,而是**那几行源码**。
|
|
78
|
+
v0.19 起代码进了同一条链路。再往后,「排在前面」也不够用了 ——
|
|
79
|
+
**排出来的那些,agent 到底读了没有?读完改过没有?** v0.15–v0.18 补的就是这一层。
|
|
82
80
|
|
|
83
|
-
|
|
81
|
+
三句话:**找到**(扫全工作区、按当前任务排序)→ **组织**(主要 / 辅助 / 相关三层 + 每条的理由)
|
|
82
|
+
→ **追踪**(读了没有、读完变了没有)。
|
|
84
83
|
|
|
85
|
-
|
|
86
|
-
|---|---|---|
|
|
87
|
-
| 旧做法(加权命中) | 76.2% | 0.830 |
|
|
88
|
-
| **BM25** | **95.2%** | **0.976** |
|
|
84
|
+
---
|
|
89
85
|
|
|
90
|
-
|
|
91
|
-
所以「新引擎必须显著更好」是自动验证的,而不是引用一个写死的数字。
|
|
86
|
+
## 「最近文件列表」和「代码浏览器」都不是它
|
|
92
87
|
|
|
93
|
-
|
|
94
|
-
语料刻意做成有真实陷阱的 —— 12 篇短而聚焦的主题文档,加上一堆「每条主题各提 5 次、
|
|
95
|
-
但哪一件都没讲」的长干扰文档(真实项目里的 CHANGELOG 就长这样)。
|
|
96
|
-
主题文档一半用描述性文件名,一半看不出内容。
|
|
88
|
+
这两个类比各自只说中 Knit 的一个**表层形态**,说不到它回答的问题。
|
|
97
89
|
|
|
98
|
-
|
|
|
90
|
+
| | 最近文件列表 | 代码浏览器 | **Knit** |
|
|
99
91
|
|---|---|---|---|
|
|
100
|
-
|
|
|
101
|
-
|
|
|
102
|
-
|
|
|
103
|
-
|
|
104
|
-
|
|
105
|
-
**文件名匹配只在名字描述内容时好使**,Knit 是唯一两种都 100% 的;
|
|
106
|
-
**自己数的可靠性随规模单调下降**。
|
|
92
|
+
| 范围 | 你点开过的 | 一棵目录树 | **整个工作区**:文档 / 代码 / 图片 / 视频 |
|
|
93
|
+
| 排序 | 修改时间 | 你自己翻 | **当前任务的相关性**(BM25 + IDF,本地算) |
|
|
94
|
+
| 输出 | 一条平铺列表 | 你打开的那一个文件 | **主要 / 辅助 / 相关** 三层,每条都写明为什么在这里 |
|
|
95
|
+
| 给谁 | 你 | 你 | 你**和** agent —— 同一份 Context Pack,走 `knit_docs` |
|
|
96
|
+
| 之后 | 不管 | 不管 | **读了没有 / 读完变了没有**(读取证据 + 生命周期) |
|
|
107
97
|
|
|
108
|
-
|
|
109
|
-
中文没有词边界,候选里必然有跨词的碎片(「项目文档」会切出 `项目文` / `目文档`),
|
|
110
|
-
直接显示就成了乱码 —— 把它们的**区间合并**再切原文,正好还原出 `项目文档`。
|
|
111
|
-
标签是你**自己打的字**,所以大小写原样保留(打 `BM25` 就显示 `BM25`)。
|
|
98
|
+
三条最要紧的区别:
|
|
112
99
|
|
|
113
|
-
|
|
114
|
-
|
|
115
|
-
|
|
100
|
+
1. **范围**:最近打开列表只记你**点开过**的文件;Knit 扫**整个项目文件夹** ——
|
|
101
|
+
重启 DSH、新开会话、跨天回来,它都还在。
|
|
102
|
+
2. **排序**:它按时间排;Knit 按**你正在聊什么**排 ——
|
|
103
|
+
聊架构,架构文档浮上来;聊 loader 的 bug,`plugin-loader.ts` 浮上来。
|
|
104
|
+
3. **它不止于「找」**:找完还要**组织**(三层 + 可核验的理由)和**追踪**(哪些真被读了、读完有没有变)。
|
|
116
105
|
|
|
117
|
-
|
|
118
|
-
- **语料只有三五篇时 IDF 几乎不起作用**:`df` 的取值范围太窄,动态范围被压扁。
|
|
119
|
-
文档越多这个排序越准 —— 这正是它该有的样子
|
|
120
|
-
- **它只能排「和对话有共同词汇」的文档**:如果一个词都没命中,所有文档同分,
|
|
121
|
-
名次就退化成按时间排
|
|
106
|
+
**不调模型、不联网**:全是本地字符串运算,零延迟、零成本、内容不出本机。
|
|
122
107
|
|
|
123
108
|
---
|
|
124
109
|
|
|
@@ -142,22 +127,6 @@ dsh plugin --profile web add dsh-knit
|
|
|
142
127
|
|
|
143
128
|
---
|
|
144
129
|
|
|
145
|
-
## 反馈
|
|
146
|
-
|
|
147
|
-
**这个项目当前的重心不是加功能,是搞清楚「按对话给文档排序」这件事到底有没有人在用。**
|
|
148
|
-
所以最有价值的一句话不是「能不能加个 XX」,而是**你现在是怎么绕过它的** ——
|
|
149
|
-
哪怕结论是「装了,但一周没打开过」,也请直说,那比一个功能建议有用得多。
|
|
150
|
-
|
|
151
|
-
- 💬 [说说你在什么场景下会打开它](https://github.com/PolinniZhong/dsh-knit/issues/new?template=feature.yml) —— 两步、三十秒,不必客气
|
|
152
|
-
- 🐞 [装不上 / 面板打不开 / 排得不对](https://github.com/PolinniZhong/dsh-knit/issues/new?template=bug.yml)
|
|
153
|
-
- 📖 提之前先看一眼[已知限制](#已知限制) —— 短对话退化、中文用 n-gram 近似,这几条是已知的取舍,不是 bug
|
|
154
|
-
|
|
155
|
-
> 一条 issue 会被当成真实信号处理。这个插件到现在**一个真实用户的痕迹都没有**
|
|
156
|
-
> (npm 那个下载量是自动化版本枚举、不是人 —— `latest` 占比只有 14%,而真人只会装 `latest`)
|
|
157
|
-
> —— 一条有人味儿的反馈能直接改变接下来做什么。
|
|
158
|
-
|
|
159
|
-
---
|
|
160
|
-
|
|
161
130
|
## 功能
|
|
162
131
|
|
|
163
132
|
| 能力 | |
|
|
@@ -199,16 +168,16 @@ dsh plugin --profile web add dsh-knit
|
|
|
199
168
|
|
|
200
169
|
|
|
201
170
|
*媒体:方形缩略图,**列数跟着面板宽度连续变** —— 这一屏是 6 列,格子约 110px。*
|
|
202
|
-
*列出的就是工作区里真实的图片与 SVG
|
|
203
|
-
|
|
171
|
+
*列出的就是工作区里真实的图片与 SVG 文件(这一屏 18 个媒体),所以看起来像一屏文件缩略图*
|
|
172
|
+
*(那个纯黑方块是单色 SVG 图标本身,不是加载失败)。*
|
|
204
173
|
*视频会取首帧当海报、中央叠播放三角、右下角叠时长,只是这个工作区里没有视频,所以这一屏看不到。*
|
|
205
174
|
|
|
206
175
|
|
|
207
176
|
|
|
208
|
-
*全部:**文档区最多 4 条**、**代码区最多 4 条**(超出时各区右侧给「查看全部 →」,这一屏是「4 /
|
|
177
|
+
*全部:**文档区最多 4 条**、**代码区最多 4 条**(超出时各区右侧给「查看全部 →」,这一屏是「4 / 21」与「4 / 8」),最后是媒体网格(11 条)。*
|
|
209
178
|
*⚠️ 三个区共用宿主返回的**同一个 40 条窗口**:某一类如果按相关性排到第 40 名之外,「全部」档就整个看不到它。*
|
|
210
179
|
*这张图用的是**「最新」排序** —— 在这个工作区里,默认的「相关」排序下媒体恒定掉在 40 条窗口之外*
|
|
211
|
-
*(`limit=40` 时那 40
|
|
180
|
+
*(`limit=40` 时那 40 条全是文档 + 代码)。**「媒体」/「代码」档不受影响**,它们各自单独取。*
|
|
212
181
|
*这是已知缺陷,复现与修法记在 [`docs/README.md`](docs/README.md)。*
|
|
213
182
|
|
|
214
183
|
---
|
|
@@ -348,7 +317,12 @@ Markdown 仍是 `title ×4 / summary ×2 / body ×1`。**两套字段权重,
|
|
|
348
317
|
|
|
349
318
|
点一个代码文件,就在**面板下方就地展开**(和 Markdown 一模一样的位置、一样的交互,
|
|
350
319
|
没有新的弹窗):行号 + 等宽字体 + 横向滚动,页脚给复制与「本地打开」。
|
|
351
|
-
|
|
320
|
+
**有语法高亮,但用的是 DSH 自己的那一套**(v0.20,2026-10-07 按用户要求改):客户端复用
|
|
321
|
+
`@deepseek-ai/dsh-client-ui-primitives` 的 `useCodeHighlighter`,颜色全部来自官方的 `--shiki-*` 令牌
|
|
322
|
+
⇒ **浅色 / 暗色都跟 DSH 一致**,不自己造一套配色。**只给命中段那一带上色**(前后各 60 行,窗口
|
|
323
|
+
最多 800 行),其余行保持默认正文色 —— 没有命中段的文件一个 token 都不上色(高亮要跑同步分词,
|
|
324
|
+
4 千行整篇着色要 2 秒量级);宿主没导出这个 hook(旧版 DSH)或行数对不上 ⇒ 静默回落纯文本。
|
|
325
|
+
不做代码折叠、不做多标签、不做 git diff —— **Knit 不是代码浏览器**。
|
|
352
326
|
|
|
353
327
|
同类入口还有:双击进官方标签页预览(带 DSH 自己的渲染器)、`Esc` 收起、键盘 `↑↓` 预览。
|
|
354
328
|
|
|
@@ -363,7 +337,7 @@ Markdown 仍是 `title ×4 / summary ×2 / body ×1`。**两套字段权重,
|
|
|
363
337
|
`primary` / `supporting` / `related` 三层,每项带路径 + 标题 + 摘要 +
|
|
364
338
|
**结构化理由**(`direct` / `summaryMatch` / `bodyMatch` / `linkTarget` / `linkSource` / `related`)
|
|
365
339
|
+ **项目角色**(`impl` / `test` / `config` / `design` / `doc`)+
|
|
366
|
-
|
|
340
|
+
命中的那一小段原文**和它的行号区间**(`match: lines 147–163 — …`),再用它自己的 `read` 打开其中一篇。
|
|
367
341
|
|
|
368
342
|
**为什么有用**:agent 想引用项目里已有的文档时,只能靠猜路径、或者把 `glob`
|
|
369
343
|
出来的路径一个个 `read` 试过去。这份排序 Knit **每一轮已经算好了**,这个工具只是把它交出去 ——
|
|
@@ -379,7 +353,10 @@ Knit 一装上就有整个项目的历史文档可用。
|
|
|
379
353
|
没有两套排序逻辑,也没有两份规则。
|
|
380
354
|
- **不返回相关度分数**。它是**相对**分数(永远有一篇 100%,每次刷新可能换人当),
|
|
381
355
|
给模型看会被当成绝对置信度去推理。**顺序即相关度** —— 与面板同一条规矩。
|
|
382
|
-
-
|
|
356
|
+
- **搜的是全文**(v0.20 起)。每篇文件都按结构切成分片、逐片打分,所以「相关内容在前 2500 字之后」
|
|
357
|
+
不再等于「搜不到」;单文件超过 256 KB 时只索引到那里,媒体没有正文 —— 这两条边界会在输出里如实说明。
|
|
358
|
+
- **不返回正文**。只给命中片段(每篇最多一段、≤200 字符),agent 有自己的 `read` 工具;
|
|
359
|
+
Knit 负责**发现**,不负责**搬运**。
|
|
383
360
|
- **拿不到会话就报错,不兜底**。HTTP 路由在会话查不到时会兜底到进程 cwd
|
|
384
361
|
(兼容不带 sessionId 的老客户端),工具**没有这个包袱** ——
|
|
385
362
|
兜底只会扫到一个不相干的项目并返回它的文档。宁可报错,也不返回错的东西。
|
|
@@ -526,6 +503,83 @@ v0.17 的信息都在,但**摞在一行字和几个折叠块里**,读不出
|
|
|
526
503
|
|
|
527
504
|
---
|
|
528
505
|
|
|
506
|
+
## 检索是怎么算的(实现细节,不是产品定义)
|
|
507
|
+
|
|
508
|
+
> 这一节是**证据**,不是卖点:支撑上面那句「按当前任务排序」的,就是下面这套本地算法。
|
|
509
|
+
> 产品要回答的问题在开头那一屏,这里回答的是「它凭什么排得准」。
|
|
510
|
+
|
|
511
|
+
没有玄学,就是字符串运算。三步:
|
|
512
|
+
|
|
513
|
+
**1. 读当前会话。** 取最近 6 条用户 / 助手消息,只认真人输入的用户消息
|
|
514
|
+
(`agent.inject()` 塞进来的合成上下文不算,那会把话题带偏)。越新的消息权重越高:3 / 2 / 1 / 1 …
|
|
515
|
+
|
|
516
|
+
**2. 抽关键词。**
|
|
517
|
+
|
|
518
|
+
- **英文词**:取值很高,出现 1 次就要(`chokidar`、`mtime` 这种精确词)
|
|
519
|
+
- **中文 2/3-gram**:出现 2 次,或出现在最新那条消息里
|
|
520
|
+
- **丢掉跨词边界的碎片**:中文没有词边界,n-gram 会把相邻两个词的字粘起来
|
|
521
|
+
(「图片和」「个插」「的排」)。这类碎片有个共同特征 —— **首字或尾字是纯虚词**,
|
|
522
|
+
一律丢掉。不丢的话它们会占满候选位,把「图片」「排序」这些真词全挤出去
|
|
523
|
+
- 虚词表过滤 + 贪心去重叠(选了「相关性排序」就不再算「相关性」和「排序」)
|
|
524
|
+
|
|
525
|
+
**3. 给文档打分 —— BM25。**
|
|
526
|
+
|
|
527
|
+
```
|
|
528
|
+
每个词先算 IDF:在语料里越罕见越值钱 ln(1 + (N - df + 0.5) / (df + 0.5))
|
|
529
|
+
再按字段加权求和:标题 ×4 + 摘要 ×2 + 正文 ×1
|
|
530
|
+
每个字段都按 BM25 饱和 + 长度归一化(k1 = 1.2,b = 0.3 / 0.5 / 0.75)
|
|
531
|
+
再叠 10% 的时间新鲜度微调(主排序仍是相关性)
|
|
532
|
+
```
|
|
533
|
+
|
|
534
|
+
**为什么是 BM25 而不是「命中次数 × 权重」**(那是最初的做法,已换掉):
|
|
535
|
+
|
|
536
|
+
- 没有 IDF 时,**语料里到处都是的词**(比如项目名)和罕见词一样值钱,
|
|
537
|
+
于是高频词不产生任何区分度,还稀释掉罕见词的分辨力
|
|
538
|
+
- 没有长度归一化时,**长文档靠堆词就能赢**
|
|
539
|
+
- 命中次数封顶 6 次是个手写硬拐点;`k1` / `b` 才是为这件事设计的
|
|
540
|
+
|
|
541
|
+
实测(`test/eval/fixture.mjs`,21 个用例,两版引擎跑同一套语料):
|
|
542
|
+
|
|
543
|
+
| | top-1 命中 | MRR |
|
|
544
|
+
|---|---|---|
|
|
545
|
+
| 旧做法(加权命中) | 76.2% | 0.830 |
|
|
546
|
+
| **BM25** | **95.2%** | **0.976** |
|
|
547
|
+
|
|
548
|
+
这套评测在 `npm test` 里跑,**基线由 `test/eval/legacy.mjs` 冻结的旧引擎现算**,
|
|
549
|
+
所以「新引擎必须显著更好」是自动验证的,而不是引用一个写死的数字。
|
|
550
|
+
|
|
551
|
+
**跟「自己数关键词」比**(`knit/tools/scale-benchmark.mjs`,N = 20/60/180/540):
|
|
552
|
+
语料刻意做成有真实陷阱的 —— 12 篇短而聚焦的主题文档,加上一堆「每条主题各提 5 次、
|
|
553
|
+
但哪一件都没讲」的长干扰文档(真实项目里的 CHANGELOG 就长这样)。
|
|
554
|
+
主题文档一半用描述性文件名,一半看不出内容。
|
|
555
|
+
|
|
556
|
+
| 路线 | 文件名说得清 | 文件名看不出 | MRR 随规模 |
|
|
557
|
+
|---|---|---|---|
|
|
558
|
+
| **Knit(BM25)** | **100%** | **100%** | **1.000(不随规模变)** |
|
|
559
|
+
| 自己 `grep -c` 数关键词 | 17% | **0%** | 0.313 → **0.089** |
|
|
560
|
+
| 只看文件名 | 100% | **0%** | 0.602 |
|
|
561
|
+
|
|
562
|
+
三件事:**排序强于自己数关键词**(所以让 agent 重算是不理性的);
|
|
563
|
+
**文件名匹配只在名字描述内容时好使**,Knit 是唯一两种都 100% 的;
|
|
564
|
+
**自己数的可靠性随规模单调下降**。
|
|
565
|
+
|
|
566
|
+
**关于那行「按「xxx」排序」**:显示的是**命中词在原文里覆盖的那一段**,不是词表里的碎片。
|
|
567
|
+
中文没有词边界,候选里必然有跨词的碎片(「项目文档」会切出 `项目文` / `目文档`),
|
|
568
|
+
直接显示就成了乱码 —— 把它们的**区间合并**再切原文,正好还原出 `项目文档`。
|
|
569
|
+
标签是你**自己打的字**,所以大小写原样保留(打 `BM25` 就显示 `BM25`)。
|
|
570
|
+
|
|
571
|
+
全是字符串运算 —— **没有 embedding,没有模型调用**。
|
|
572
|
+
|
|
573
|
+
**并且老实说边界**:
|
|
574
|
+
|
|
575
|
+
- **对话只有一两句时**关键词太少,它会退回按修改时间排,并在面板上说明这一点 —— 不假装排了个序
|
|
576
|
+
- **语料只有三五篇时 IDF 几乎不起作用**:`df` 的取值范围太窄,动态范围被压扁。
|
|
577
|
+
文档越多这个排序越准 —— 这正是它该有的样子
|
|
578
|
+
- **它只能排「和对话有共同词汇」的文档**:如果一个词都没命中,所有文档同分,
|
|
579
|
+
名次就退化成按时间排
|
|
580
|
+
|
|
581
|
+
---
|
|
582
|
+
|
|
529
583
|
## 它读什么,不读什么
|
|
530
584
|
|
|
531
585
|
- 扫描**当前会话工作区内**的 `.md`、第一批代码后缀(见上文「代码上下文」)、图片与视频
|
|
@@ -577,13 +631,29 @@ v0.17 的信息都在,但**摞在一行字和几个折叠块里**,读不出
|
|
|
577
631
|
|
|
578
632
|
---
|
|
579
633
|
|
|
634
|
+
## 反馈
|
|
635
|
+
|
|
636
|
+
**这个项目当前的重心不是加功能,是搞清楚「按对话给文档排序」这件事到底有没有人在用。**
|
|
637
|
+
所以最有价值的一句话不是「能不能加个 XX」,而是**你现在是怎么绕过它的** ——
|
|
638
|
+
哪怕结论是「装了,但一周没打开过」,也请直说,那比一个功能建议有用得多。
|
|
639
|
+
|
|
640
|
+
- 💬 [说说你在什么场景下会打开它](https://github.com/PolinniZhong/dsh-knit/issues/new?template=feature.yml) —— 两步、三十秒,不必客气
|
|
641
|
+
- 🐞 [装不上 / 面板打不开 / 排得不对](https://github.com/PolinniZhong/dsh-knit/issues/new?template=bug.yml)
|
|
642
|
+
- 📖 提之前先看一眼[已知限制](#已知限制) —— 短对话退化、中文用 n-gram 近似,这几条是已知的取舍,不是 bug
|
|
643
|
+
|
|
644
|
+
> 一条 issue 会被当成真实信号处理。这个插件到现在**一个真实用户的痕迹都没有**
|
|
645
|
+
> (npm 那个下载量是自动化版本枚举、不是人 —— `latest` 占比只有 14%,而真人只会装 `latest`)
|
|
646
|
+
> —— 一条有人味儿的反馈能直接改变接下来做什么。
|
|
647
|
+
|
|
648
|
+
---
|
|
649
|
+
|
|
580
650
|
## 开发
|
|
581
651
|
|
|
582
652
|
```sh
|
|
583
653
|
git clone https://github.com/PolinniZhong/dsh-knit.git
|
|
584
654
|
cd dsh-knit
|
|
585
655
|
|
|
586
|
-
npm test #
|
|
656
|
+
npm test # 641 项,零依赖,不需要先 npm install
|
|
587
657
|
```
|
|
588
658
|
|
|
589
659
|
**改动生效方式**:宿主半边(`src/host/`)改了**必须重启 DSH**(实测不热加载);
|
|
@@ -604,12 +674,13 @@ knit/
|
|
|
604
674
|
│ ├── host/classification.js # 文件分类层:kind / language / 能力位(纯函数,零 I/O)
|
|
605
675
|
│ ├── host/relevance.js # 相关性引擎:BM25 + 关键词抽取(纯函数)
|
|
606
676
|
│ ├── host/links.js # 引用关系解析(纯解析,不碰排序)
|
|
677
|
+
│ ├── host/passage.js # 内容片段层:切分 / 片段打分 / 行号映射(纯函数,零 I/O)
|
|
607
678
|
│ ├── host/context.js # 上下文装配:Context Pack 三层(纯函数,零 I/O)
|
|
608
679
|
│ ├── host/feedback.js # 使用反馈:读时归因 / Context Epoch / Delta(纯逻辑,只读事件流)
|
|
609
680
|
│ ├── host/tool.js # agent 文档工具 knit_docs(手写 ToolDefinition)
|
|
610
681
|
│ └── client/client.js # 双宿主注册 + 面板 UI
|
|
611
|
-
└── test/ #
|
|
612
|
-
├── eval/ # 检索质量评测:语料 + 用例 + 冻结的 v0.5.2 基线
|
|
682
|
+
└── test/ # 641 项测试
|
|
683
|
+
├── eval/ # 检索质量评测:语料 + 用例 + 冻结的 v0.5.2 基线 + Deep Context 四指标
|
|
613
684
|
└── context/ # 上下文分层评测:24 篇语料 + 12 条任务型用例
|
|
614
685
|
```
|
|
615
686
|
|
package/SECURITY.md
CHANGED
|
@@ -2,7 +2,7 @@
|
|
|
2
2
|
|
|
3
3
|
> **Knit 的安全属性 —— 每一条都指向一个真实存在的检查。**
|
|
4
4
|
>
|
|
5
|
-
> 最后更新:2026-10-07(v0.
|
|
5
|
+
> 最后更新:2026-10-07(v0.20.0)
|
|
6
6
|
|
|
7
7
|
## 为什么有这份文件
|
|
8
8
|
|
|
@@ -47,6 +47,6 @@ Knit 的安全属性其实一直成立 —— 但它们此前只散落在文档
|
|
|
47
47
|
## 如何自己复核
|
|
48
48
|
|
|
49
49
|
```sh
|
|
50
|
-
npm test #
|
|
50
|
+
npm test # 641 项,含本节所有断言
|
|
51
51
|
npm test -- test/security.test.mjs # 只跑安全守卫
|
|
52
52
|
```
|
package/package.json
CHANGED
|
@@ -1,8 +1,8 @@
|
|
|
1
1
|
{
|
|
2
2
|
"name": "dsh-knit",
|
|
3
|
-
"version": "0.
|
|
3
|
+
"version": "0.20.0",
|
|
4
4
|
"type": "module",
|
|
5
|
-
"description": "Task-aware workspace context retrieval for DeepSeek Harness.
|
|
5
|
+
"description": "Task-aware workspace context retrieval and lifecycle tracking for DeepSeek Harness. Finds the documents, source files and media most relevant to the current conversation, organises them into a Context Pack (primary / supporting / related) in the sidebar with inline preview, and tracks which of them were actually read and what changed afterwards. Zero model calls, zero network, nothing leaves the machine.",
|
|
6
6
|
"main": "./src/host/index.js",
|
|
7
7
|
"exports": {
|
|
8
8
|
".": "./src/host/index.js",
|
|
@@ -23,7 +23,8 @@
|
|
|
23
23
|
"LICENSE"
|
|
24
24
|
],
|
|
25
25
|
"scripts": {
|
|
26
|
-
"
|
|
26
|
+
"agents:budget": "node tools/agents-budget.mjs",
|
|
27
|
+
"test": "node --test test/host.test.mjs test/host-http.test.mjs test/client.test.mjs test/tier1.test.mjs test/entry.test.mjs test/i18n.test.mjs test/icon.test.mjs test/path.test.mjs test/peek.test.mjs test/eval.test.mjs test/tool.test.mjs test/label.test.mjs test/links.test.mjs test/security.test.mjs test/context.test.mjs test/context-eval.test.mjs test/feedback.test.mjs test/context-delta.test.mjs test/context-feedback-eval.test.mjs test/context-effectiveness.test.mjs test/document-lifecycle.test.mjs test/classification.test.mjs test/code-context.test.mjs test/deep-context.test.mjs test/deep-eval.test.mjs test/deep-scale.test.mjs"
|
|
27
28
|
},
|
|
28
29
|
"dsh": {
|
|
29
30
|
"bundle": {
|
|
@@ -53,6 +54,9 @@
|
|
|
53
54
|
"recent-files",
|
|
54
55
|
"relevance",
|
|
55
56
|
"context-pack",
|
|
57
|
+
"workspace-context",
|
|
58
|
+
"context-retrieval",
|
|
59
|
+
"context-lifecycle",
|
|
56
60
|
"task-context",
|
|
57
61
|
"images",
|
|
58
62
|
"video",
|