dolphindb 3.0.112 → 3.0.114
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- package/browser.d.ts +5 -0
- package/browser.js +4 -4
- package/browser.js.map +1 -1
- package/docs.en.json +5868 -5812
- package/docs.zh.json +395 -395
- package/i18n/index.d.ts +2 -2
- package/index.d.ts +5 -0
- package/index.js +4 -4
- package/index.js.map +1 -1
- package/package.json +6 -9
- package/unused.d.ts +0 -1
- package/unused.js +0 -1
- package/unused.js.map +1 -1
- package/eslint.config.d.ts +0 -2
package/docs.zh.json
CHANGED
|
@@ -3527,7 +3527,7 @@
|
|
|
3527
3527
|
]
|
|
3528
3528
|
}
|
|
3529
3529
|
],
|
|
3530
|
-
"markdown": "### [count](https://docs.dolphindb.cn/zh/funcs/c/count.html)\n\n\n\n#### 语法\n\ncount(X)\n\n#### 参数\n\n**X** 可以是标量、向量、矩阵或表。\n\n#### 详情\n\n[size](https://docs.dolphindb.cn/zh/funcs/s/size.html) 和 `count` 不同。`size` 返回向量/矩阵中元素的个数,而 `count` 返回向量/矩阵中非 NULL 的元素个数。`count` 可以用在 SQL 查询中,而 `size` 不可以。对于表而言,`size` 和 `count` 都返回行数。参见相关函数 [size](https://docs.dolphindb.cn/zh/funcs/s/size.html)。\n\n#### 例子\n\n```\ncount(3 NULL 5 6);\n// output\n3\nsize(3 NULL 5 6);\n// output\n4\n\nm=1 2 3 NULL 4 5$2:3;\nm;\n```\n\n| #0 | #1 | #2 |\n| -- | -- | -- |\n| 1 | 3 | 4 |\n| 2 | | 5 |\n\n```\ncount(m);\n// output\n5\nsize(m);\n// output\n6\n\nt = table(1 NULL 3 as id, 3 NULL 9 as qty);\nt;\n```\n\n| id | qty |\n| -- | --- |\n| 1 | 3 |\n| | |\n| 3 | 9 |\n\n```\ncount(t);\n// output\n3\nsize(t);\n// output\n3\n```\n"
|
|
3530
|
+
"markdown": "### [count](https://docs.dolphindb.cn/zh/funcs/c/count.html)\n\n\n\n#### 语法\n\ncount(X)\n\n#### 参数\n\n**X** 可以是标量、向量、矩阵或表。\n\n#### 详情\n\n[size](https://docs.dolphindb.cn/zh/funcs/s/size.html) 和 `count` 不同。`size` 返回向量/矩阵中元素的个数,而 `count` 返回向量/矩阵中非 NULL 的元素个数。`count` 可以用在 SQL 查询中,而 `size` 不可以。对于表而言,`size` 和 `count` 都返回行数。参见相关函数 [size](https://docs.dolphindb.cn/zh/funcs/s/size.html)。\n\n`count` 用于 SQL 查询时,有如下三种常见用法:\n\n* `select count(*) from pt` :返回 pt 表中的数据条数。\n* `count(1) from pt` :若 pt 为空表,则返回1;否则返回 pt 表中数据涉及到的分区数量。\n* `select count(colName) from pt` :返回列 colName 中的非空数据的个数。\n\n#### 例子\n\n```\ncount(3 NULL 5 6);\n// output\n3\nsize(3 NULL 5 6);\n// output\n4\n\nm=1 2 3 NULL 4 5$2:3;\nm;\n```\n\n| #0 | #1 | #2 |\n| -- | -- | -- |\n| 1 | 3 | 4 |\n| 2 | | 5 |\n\n```\ncount(m);\n// output\n5\nsize(m);\n// output\n6\n\nt = table(1 NULL 3 as id, 3 NULL 9 as qty);\nt;\n```\n\n| id | qty |\n| -- | --- |\n| 1 | 3 |\n| | |\n| 3 | 9 |\n\n```\ncount(t);\n// output\n3\nsize(t);\n// output\n3\n```\n\n```\ndata = table(2023.10.01 + take(0..9,100) as date, take(['A','B','C','D'],100) as sym, 1..100 as val) \n\ndb = database(\"dfs://demo\",VALUE,2023.10.01..2023.10.10)\npt = db.createPartitionedTable(data,`pt,`date)//创建一个分区表\n \npt.append!(data) //向表中插入数据\n\nselect count(*) from pt;//返回数据条数\n```\n\n| count |\n| ----- |\n| 100 |\n\n```\nselect count(1) from pt;//返回分区数\n```\n\n| count |\n| ----- |\n| 10 |\n"
|
|
3531
3531
|
},
|
|
3532
3532
|
"countNanInf": {
|
|
3533
3533
|
"url": "https://docs.dolphindb.cn/zh/funcs/c/countNanInf.html",
|
|
@@ -5062,7 +5062,7 @@
|
|
|
5062
5062
|
]
|
|
5063
5063
|
}
|
|
5064
5064
|
],
|
|
5065
|
-
"markdown": "### [createOrderBookSnapshotEngine](https://docs.dolphindb.cn/zh/funcs/c/createorderbooksnapshotengine.html)\n\n\n\n#### 语法\n\ncreateOrderBookSnapshotEngine(name, exchange, orderbookDepth, intervalInMilli, date, startTime, prevClose, dummyTable, outputTable, inputColMap, \\[outputColMap], \\[outputCodeMap], \\[snapshotDir], \\[snapshotIntervalInMsgCount], \\[raftGroup], \\[outputIntervalOffsetMap], \\[checkRestrict], \\[maxPrice], \\[minPrice], \\[userDefinedMetrics], \\[priceNullFill], \\[triggerType], \\[forceTriggerTime], \\[precision], \\[orderBySeq], \\[skipCrossedMarket=true], \\[orderBookDetailDepth=0], \\[orderBookAsArray=false], \\[useSystemTime=false])\n\n**Note:**\n\n社区版 License 暂不支持该引擎,如需使用此功能,请联系技术支持。\n\n#### 详情\n\n该函数基于一个包含了逐笔委托和逐笔交易数据表,实时合成指定频率(1秒,100ms,30ms 等)的全档位盘口信息、窗口内统计信息、全天累计统计信息等订单薄(或者叫快照)数据。也可通过历史逐笔数据来合成需要的订单薄数据。\n\n目前支持合成深交所股票、深交所可转债、深交所基金、上交所股票、上交所可转债、上交所基金的订单薄数据。请注意,可转债的规则遵循自2022年8月之后发布的新规定。\n\n##### 窗口规则\n\n由参数 *intervalInMilli* 指定窗口的长度(以时间衡量),输出表中显示的时间为窗口的右边界。最后一个窗口的右边界最大值是 14:57:00.000,此时,窗口区间为左开右开,且输出窗口显示为右边界的时间戳(14:57:00.000),其余情况的窗口区间全部左开右闭。\n\n##### 触发规则\n\n第一条输出记录由输入表中第一条时间戳大于 startTime + intervalInMilli 的记录触发,此时输出表的时间戳为 startTime + intervalInMili。之后根据参数 *triggerType*的配置值,决定新收到任意一条逐笔数据,当其时间戳大于窗口右边界时,触发输出单个或所有证券代码的快照。\n\n**Note:**\n\n* 一个引擎至多只能输入某一天一个通道的全部股票数据。\n* 必须保证注入引擎的数据表内的数据按照交易所的逐笔序号排序。\n\n#### 参数\n\n**Note:** 传参时必须指定参数名。\n\n**name** 字符串标量,表示 orderbook 快照引擎的名称,可包含字母,数字和下划线,但必须以字母开头。\n\n**exchange** 字符串标量,表示证券的类型。可选参数:\n\n* “XSHE” 或 “XSHESTOCK”:深交所股票\n* “XSHEBOND”:深交所可转债\n* “XSHEFUND”:深交所基金\n* “XSHG” 或 “XSHGSTOCK”:上交所股票\n* “XSHGBOND”:上交所可转债\n* “XSHGFUND”:上交所基金\n\n**orderbookDepth** 正整数,表示 orderbook 中最多能够显示的买卖报价的档位。\n\n**intervalInMilli** 正整数,表示触发输出数据的时间间隔,即合成快照的时间频率,单位为毫秒。\n\n**date** DATE 类型标量,表示交易日期。该参数和窗口右边界组合成输出表的 TIMESTAMP 列。\n\n**startTime** TIME 类型标量,表示触发输出数据的起始时刻。引擎只会输出该参数指定时刻(规整后)之后的数据。\n\n**prevClose** 字典,其 key 为字符串标量或向量,表示股票代码;其 value 为数值类型,表示对应于股票代码的上一个交易日的收盘价格。\n\n**dummyTable** 一个表对象,和订阅的流数据表的 schema 一致,可以含有数据,亦可为空表。。\n\n**outputTable** 一个表对象。若指定 *userDefinedMetrics*,*outputTable* 根据 `genOutputColumnsForOBSnapshotEngine` 函数指定的 *basic*、*depth* 以及用户自定义的指标来确定表结构。否则,*outputTable* 根据 *outputColMap*的设置来确定表结构。\n\n**inputColMap** 字典,将输入表中列字段的名称映射为引擎计算所需要的列。其中:\n\n* key 为字符串类型,表示引擎所需要的固定的输入字段。具体字段名和含义见下表。注意,这些 key 区分大小写,必须全部指定,但顺序可以不固定。\n* value 为字符串类型,表示输入表中对应的列名称。\n\n<table id=\"table_s52_ghv_x1c\"><thead><tr><th>\n\nkey\n\n</th><th>\n\nvalue 对应的字段类型\n\n</th><th>\n\n含义\n\n</th></tr></thead><tbody><tr><td>\n\n“timeColumn”\n\n</td><td>\n\nTIME\n\n</td><td>\n\n交易时间\n\n</td></tr><tr><td>\n\n“typeColumn”\n\n</td><td>\n\nINT\n\n</td><td>\n\n交易类型:- 如果是逐笔委托单,则:1表示市价;2表示限价;3表示本方最优;10表示撤单(仅上交所);11市场状态(仅上交所)\n\n* 如果是逐笔成交单,则:0表示成交;1表示撤单(仅深交所)\n\n</td></tr><tr><td>\n\n“priceColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n价格,真实价格\\*10000\n\n</td></tr><tr><td>\n\n“qtyColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n数量(股数)\n\n</td></tr><tr><td>\n\n“buyOrderColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n* 逐笔成交:对应其原始成交中的买方委托序号。\n* 逐笔委托:\n * 上交所:填充原始委托中的原始订单号,即上交所在新增、删除订单时用以标识订单的唯一编号(OrderNo 字段)\n * 深交所:填充0。此字段为深交所为了补全上交所数据格式而增加的冗余列\n\n</td></tr><tr><td>\n\n“sellOrderColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n* 逐笔成交:对应其原始成交中的卖方委托序号。\n* 逐笔委托:\n * 上交所:填充原始委托中的原始订单号,即上交所在新增、删除订单时用以标识订单的唯一编号(OrderNo 字段)\n * 深交所:填充0。此字段深交所为了补全上交所数据格式而增加的冗余列\n\n</td></tr><tr><td>\n\n“sideColumn”\n\n</td><td>\n\nINT\n\n</td><td>\n\n买卖方向:1表示买单;2表示卖单说明:\n\n* 委托单的 BSFlag,必填\n* 撤单的 BSFlag 由原始委托单决定买卖方向,必填\n* 成交单的 BSFlag,不影响结果,非必填\n\n</td></tr><tr><td>\n\n“msgTypeColumn”\n\n</td><td>\n\nINT\n\n</td><td>\n\n数据类型:- 0表示逐笔委托;\n\n* 1表示逐笔成交;\n* -1表示产品状态。\n\n</td></tr><tr><td>\n\n“seqColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n一个通道内从 1 开始递增的逐笔数据序号。深交所为 appseqlnum 字段,若深交所数据中包含 index 字段,也可以使用 index;上交所为 bizIndex 字段。\n\n</td></tr><tr><td>\n\n“codeColumn”\n\n</td><td>\n\nSYMBOL\n\n</td><td>\n\n证券代码(如300010.SZ)\n\n</td></tr></tbody>\n</table>**Note:** 引擎规范了枚举类型中各枚举值的具体含义。输入表对应的枚举值必须遵守这个规范。比如枚举类型字段 sideColumn 所对应的输入表中的字段必须使用 1 代表买方向,2 代表卖方向。\n\n**outputColMap** 可选参数,字符串向量,用于指定需要输出的字段名称,不区分大小写。为方便指定 *outputColMap*,用户可通过 `genOutputColumnsForOBSnapshotEngine` 函数生成需要输出的字段名称,将返回值的第一个元素赋值给 *outputColMap* 即可。\n\n**outputCodeMap** 可选参数,字符串向量,表示股票代码,例如:“000803.SZ”。指定该参数后,将只输出指定股票对应的数据。\n\n**outputIntervalOffsetMap** 可选参数,向量或字典,用于指定输出表中股票被触发计算的时间偏移量。\n\n* 当为向量时,向量中的元素表示不同的时间偏移量,单位为毫秒。引擎将根据输入的股票数量自动将这些股票均匀分配到这些偏移量上。例如,outputIntervalOffsetMap = \\[400, 500],表示引擎将自动将输入的股票均匀分成两部分,经过intervalInMilli + 400(ms) 后触发其中一部分股票的数据输出;经过 intervalInMilli + 500(ms) 后触发另一部分股票的数据输出。\n* 当为字典时,其 key 为字符串类型,表示股票代码;其 value 为整型,表示时间偏移量,单位为毫秒。例如:outputIntervalOffsetMap =dict(\\[\"127053.sz\",\"123082.SZ\"],\\[400, 500]),表示经过 intervalInMilli + 400(ms) 后触发 127053.sz 股票的数据输出;经过 intervalInMilli + 500(ms) 后触发 123082.SZ 股票的数据输出。\n\n**checkRestrict** 可选参数,布尔值,默认值为 true,表示开启价格笼子机制;若设置为 false,则关闭笼子机制,此时会取消对股票交易的限制,创业板合成出的快照可能不正确。\n\n**Note:** 深交所对创业板证券(证券代码以 3 开头)设定了价格笼子。在 *checkRestrict*=true 时,引擎只会将证券代码的首字符是否为 3 作为是否执行价格笼子的判断标准。因此,在向引擎输入创业板数据时,证券代码必须以 3 开头。\n\n**maxPrice** 可选参数,字典。其 key 为字符串类型,表示证券代码;其 value 为 DOUBLE 类型,表示涨停价格。\n\n**minPrice** 可选参数,字典。其 key 为字符串类型,表示证券代码;其 value 为 DOUBLE 类型,表示跌停价格。\n\n**userDefinedMetrics** 可选参数,一元函数。\n\n* 函数的入参是一个表,表的每一行是一个标的,每一列是标的对应的快照。若指定 *outputColMap*,则表中数据为 *outputColMap*设置的字段;否则表中数据为基础字段和报价/询价的价格和数量。\n\n* 函数的返回值是一个元组,元组的每一个元素是一个常规向量,代表每个标的经对应指标计算后的结果。\n\n**priceNullFill** 一个数字。该参数值用于填充输出表中多档买/卖价格中缺失档位的价格。例如涨停后卖单的价格都为 NULL,此时如有指定卖单价格为 0 的需求,可以设置 priceNullFill=0。\n\n**triggerType** 可选参数,字符串标量,表示触发方式。可选值为:\n\n* “mutual”:新收到任意一条逐笔数据,当其时间戳大于窗口右边界时,就会触发所有股票未计算的快照合成输出。触发计算的数据并不会参与该次计算。\n* “independent”:新收到任意一条逐笔数据,当其时间戳大于窗口右边界时,只触发该条数据对应股票未计算的快照合成输出。触发计算的数据并不会参与该次计算。\n* “perRow”:每收到一行逐笔数据都会触发该条数据对应股票计算并输出,触发计算的数据并参与该次计算。\n\n**forceTriggerTime** 可选参数,是非负整数,单位为毫秒。除了正常触发合成快照外,有时会出现一些数据因乱序不能触发合成快照,而是被缓存在引擎中。在这种情况下,可通过该参数设置强制触发引擎中长时间未处理的逐笔数据合成快照。触发规则为:\n\n1. 最新收到的逐笔数据的时间戳(t )减去最后一条已经处理的交易数据的时间戳(t0 )大于或等于 *forceTriggerTime*,则触发未处理的数据中序号最小的那条数据合成快照,并更新已经处理的交易数据的时间戳(t1)。\n2. 重复上述操作,若判断 t-t1 >= *forceTriggerTime*,则触发未处理的数据中序号最小的那条数据合成快照,并更新已经处理的交易数据的时间戳(t2);直到两个时间戳的差值小于 *forceTriggerTime*时,停止触发快照合成。\n\n**precision** 可选参数,非负整数,表示小数位数,取值范围为\\[0,4]。若指定该参数,则输出表中所有的价格将按照指定的位数进行四舍五入。否则,按照原始结果输出。\n\n**orderBySeq** 可选参数,布尔值或元组\n\n* 指定该参数值为布尔值时,表示是否按照逐笔数据中的 seqColumn 列中值的大小顺序处理数据。\n * 当 *orderBySeq*=true(默认值) 时,会根据逐笔数据的序号有序处理数据,并计算输出。例如引擎先后收到序号为1,3的数据,因为缺少序号为2的数据,引擎先将1和3的数据缓存,待收到序号2的数据时,再进行计算输出。此时也可以指定 *forceTriggerTime*强制触发计算输出。\n * 当 *orderBySeq*=false 时,每接收到一条数据都会立即进行计算并输出,此时不可设置 *forceTriggerTime*。\n* 指定该参数值为元组时,以(BOOL, INTEGER, \\[STRING])的形式表示,其中:\n * 第一个元素为布尔值,表示是否按照逐笔数据的序号有序输出结果的布尔值,作用同上。\n * 第二个元素为正整数,表示记录缓存输入数据量的时间间隔,单位为毫秒(ms)。\n * 第三个元素为指定输出日志级别的字符串标量,可选参数,其可用值为 DEBUG (默认值)和 INFO,分别对应 Debug 和 Info 级别的日志输出。\n\n**skipCrossedMarket**可选参数, 布尔值,表示是否输出买一卖一价交叉的计算结果。\n\n* 当 *skipCrossedMarket*=true(默认值)时,若设置 *useSystemTime* = false,若出现买一卖一价交叉,即卖一价<=买一价,则不输出该条结果;若设置 *useSystemTime* = true,则出现买一卖一交叉时,暂时不输出该条快照,若接下来收到的数据不再有交叉,则立即触发该条快照输出。\n* 当 *skipCrossedMarket*=false 时,若出现买一卖一价交叉,仍然输出该条结果。\n\n**orderBookDetailDepth** 可选参数,整型标量,表示 orderbook 明细的深度。默认值为0,表示不输出。该参数必须和 *outputColMap* 中 orderBookDetailDepth 字段的值保持一致。\n\n**orderBookAsArray** 可选参数,布尔值,表示是否以数组向量形式输出报价/询价的价格和数量。默认值为 false,价格和数量将以多列形式输出。\n\n注意,若指定 *userDefinedMetrics*,价格和数量的输出形式由 *orderBookAsArray* 确定。否则,价格和数量的输出形式由 *outputColMap* 确定,该参数失效。\n\n**useSystemTime** 可选参数,布尔值,表示是否使用系统时间来触发快照输出。\n\n* 当 *useSystemTime* = true 时,引擎将基于当前的系统时间,按照 *intervalInMilli* 设置的时间间隔触发快照输出。此时,不能指定*skipCrossedMarket* 和 *forceTriggerTime*;可以不指定 *triggerType*,或者指定为 *triggerType*=”mutual”。\n\n* 当 *useSystemTime* = false(缺省值)时,引擎根据事件时间来触发快照输出。\n\n#### 例子\n\n运行代码前,先下载 [../data/orderbookDemoInput.zip](https://docs.dolphindb.cn/zh/funcs/data/orderbookDemoInput.zip) 文件。\n\n```\n// 登录\nlogin(\"admin\", \"123456\")\n\n// 释放已有的引擎\ntry { dropStreamEngine(\"demo\") } catch(ex) { print(ex) }\n\n// 创建引擎参数 outputTable,即指定输出表\nsuffix = string(1..10)\ncolNames = `SecurityID`timestamp`lastAppSeqNum`tradingPhaseCode`modified`turnover`volume`tradeNum`totalTurnover`totalVolume`totalTradeNum`lastPx`highPx`lowPx`ask`bid`askVol`bidVol`preClosePx`invalid join (\"bids\" + suffix) join (\"bidVolumes\" + suffix) join (\"bidOrderNums\" + suffix) join (\"asks\" + suffix) join (\"askVolumes\" + suffix) join (\"askOrderNums\" + suffix) \ncolTypes = [SYMBOL,TIMESTAMP,LONG,INT,BOOL,DOUBLE,LONG,INT,DOUBLE,LONG,INT,DOUBLE,DOUBLE,DOUBLE,DOUBLE,DOUBLE,LONG,LONG,DOUBLE,BOOL] join take(DOUBLE, 10) join take(LONG, 10) join take(INT, 10) join take(DOUBLE, 10) join take(LONG, 10) join take(INT, 10) \nshare table(10000000:0, colNames, colTypes) as outTable\n\n// 创建引擎参数 dummyTable,即指定输入表的表结构\ncolNames = `SecurityID`Date`Time`SecurityIDSource`SecurityType`Index`SourceType`Type`Price`Qty`BSFlag`BuyNo`SellNo`ApplSeqNum`ChannelNo\ncolTypes = [SYMBOL, DATE, TIME, SYMBOL, SYMBOL, LONG, INT, INT, LONG, LONG, INT, LONG, LONG, LONG, INT]\ndummyOrderStream = table(1:0, colNames, colTypes)\n\n// 创建引擎参数 inputColMap,即指定输入表各字段的含义\ninputColMap = dict(`codeColumn`timeColumn`typeColumn`priceColumn`qtyColumn`buyOrderColumn`sellOrderColumn`sideColumn`msgTypeColumn`seqColumn, `SecurityID`Time`Type`Price`Qty`BuyNo`SellNo`BSFlag`SourceType`ApplSeqNum)\n\n// 创建引擎参数 prevClose,即昨日收盘价,prevClose 不影响最终的输出结果中除昨日收盘价以外的其他字段\nprevClose = dict(`000587.SZ`002694.SZ`002822.SZ`000683.SZ`301063.SZ`300459.SZ`300057.SZ`300593.SZ`301035.SZ`300765.SZ, [1.66, 6.56, 6.10, 8.47, 38.10, 5.34, 9.14, 48.81, 60.04, 16.52])\n\n// 定义引擎,每1s计算输出深交所股票10档买卖盘口\nengine = createOrderBookSnapshotEngine(name=\"demo\", exchange=\"XSHE\", orderbookDepth=10, intervalInMilli = 1000, date=2022.01.10, startTime=09:15:00.000, prevClose=prevClose, dummyTable=dummyOrderStream, outputTable=outTable, inputColMap=inputColMap)\n\nfilePath = \"./orderbookDemoInput.csv\"\ncolNames = `SecurityID`Date`Time`SecurityIDSource`SecurityType`Index`SourceType`Type`Price`Qty`BSFlag`BuyNo`SellNo`ApplSeqNum`ChannelNo\ncolTypes = [SYMBOL, DATE, TIME, SYMBOL, SYMBOL, LONG, INT, INT, LONG, LONG, INT, LONG, LONG, LONG, INT]\norderTrade = table(1:0, colNames, colTypes)\norderTrade.append!(select * from loadText(filePath) order by Time)\n\n// 10支股票的逐笔数据批量注入快照合成引擎\nengine.append!(orderTrade)\nselect count(*) from outTable where SecurityID=\"300593.SZ\", timestamp between 2022.01.10T13:15:01.000 and 2022.01.10T13:15:10.000\n\n//output: 10\n```\n\n通过 *outputColMap*指定需要输出的字段。`genOutputColumnsForOBSnapshotEngine` 函数返回值的第一个元素即为 *outputColMap*,返回值的第二个元素可以确定 *outputTable* 的 schema。\n\n```\ntry { dropStreamEngine(\"demo\") } catch(ex) { print(ex) }\n\nfilePath = \"./orderbookDemoInput.csv\"\n\n// 创建引擎参数 dummyTable,即指定输入表的表结构\ncolNames = `SecurityID`Date`Time`SecurityIDSource`SecurityType`Index`SourceType`Type`Price`Qty`BSFlag`BuyNo`SellNo`ApplSeqNum`ChannelNo\ncolTypes = [SYMBOL, DATE, TIME, SYMBOL, SYMBOL, LONG, INT, INT, LONG, LONG, INT, LONG, LONG, LONG, INT]\nshare table(1:0, colNames, colTypes) as dummyOrderStream\n\n// 创建引擎参数 inputColMap,即指定输入表各字段的含义\ninputColMap = dict(`codeColumn`timeColumn`typeColumn`priceColumn`qtyColumn`buyOrderColumn`sellOrderColumn`sideColumn`msgTypeColumn`seqColumn, `SecurityID`Time`Type`Price`Qty`BuyNo`SellNo`BSFlag`SourceType`ApplSeqNum)\n\n// 创建引擎参数 prevClose,即昨日收盘价,prevClose 不影响最终的输出结果中除昨日收盘价以外的其他字段\nprevClose = dict(`000587.SZ`002694.SZ`002822.SZ`000683.SZ`301063.SZ`300459.SZ`300057.SZ`300593.SZ`301035.SZ`300765.SZ, [1.66, 6.56, 6.10, 8.47, 38.10, 5.34, 9.14, 48.81, 60.04, 16.52])\n\n//创建使用 outputColMap 和 outputTableSch 接收 genOutputColumnsForOBSnapshotEngine 的返回值。它们分别用于确定 outputColMap 和 outputTable\noutputColMap, outputTableSch = genOutputColumnsForOBSnapshotEngine(basic=true, time=false, depth=(10, true), tradeDetail=true, orderDetail=false, withdrawDetail=false, orderBookDetailDepth=0, prevDetail=false)\n\nengine = createOrderBookSnapshotEngine(name=\"demo\", exchange=\"XSHE\", orderbookDepth=10, intervalInMilli = 1000, date=2022.01.10, startTime=09:15:00.000, prevClose=prevClose, dummyTable=dummyOrderStream, outputTable=outputTableSch, inputColMap=inputColMap, outputColMap=outputColMap, orderBookAsArray=true)\n\n// 10支股票的逐笔数据批量注入快照合成引擎\nengine.append!(select * from loadText(filePath) order by Time)\nselect top 10 * from outputTableSch where code=\"300593.SZ\", timestamp between 2022.01.10T13:15:01.000 and 2022.01.10T13:15:10.000\n```\n\n部分结果展示如下:\n\n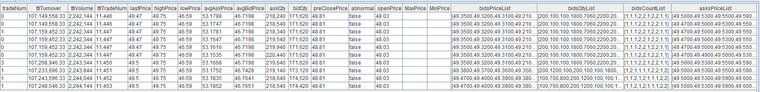\n\n```\ntry { dropStreamEngine(\"demo\") } catch(ex) { print(ex) }\n\nfilePath = \"./orderbookDemoInput.csv\"\n\n// 创建引擎参数 dummyTable,即指定输入表的表结构\ncolNames = `SecurityID`Date`Time`SecurityIDSource`SecurityType`Index`SourceType`Type`Price`Qty`BSFlag`BuyNo`SellNo`ApplSeqNum`ChannelNo\ncolTypes = [SYMBOL, DATE, TIME, SYMBOL, SYMBOL, LONG, INT, INT, LONG, LONG, INT, LONG, LONG, LONG, INT]\nshare table(1:0, colNames, colTypes) as dummyOrderStream\n\n// 创建引擎参数 inputColMap,即指定输入表各字段的含义\ninputColMap = dict(`codeColumn`timeColumn`typeColumn`priceColumn`qtyColumn`buyOrderColumn`sellOrderColumn`sideColumn`msgTypeColumn`seqColumn, `SecurityID`Time`Type`Price`Qty`BuyNo`SellNo`BSFlag`SourceType`ApplSeqNum)\n\n// 创建引擎参数 prevClose,即昨日收盘价,prevClose 不影响最终的输出结果中除昨日收盘价以外的其他字段\nprevClose = dict(`000587.SZ`002694.SZ`002822.SZ`000683.SZ`301063.SZ`300459.SZ`300057.SZ`300593.SZ`301035.SZ`300765.SZ, [1.66, 6.56, 6.10, 8.47, 38.10, 5.34, 9.14, 48.81, 60.04, 16.52])\n\n//此处只定义 outputColMap 接收 genOutputColumnsForOBSnapshotEngine 的第一个返回值。因 userDefinedMetrics 定义的指标中需要使用委托明细和回撤明细,因此 genOutputColumnsForOBSnapshotEngine 需要指定 orderDetail=false, withdrawDetail=true\noutputColMap = genOutputColumnsForOBSnapshotEngine(basic=true, time=false, depth=(10, true), tradeDetail=true, orderDetail=false, withdrawDetail=true, orderBookDetailDepth=0, prevDetail=false)[0]\n\n\n//// 定义用户自定义因子\ndef userDefinedFunc(t){\n AvgBuyDuration = rowAvg(t.TradeMDTimeList-t.TradeOrderBuyNoTimeList).int()\n AvgSellDuration = rowAvg(t.TradeMDTimeList-t.TradeOrderSellNoTimeList).int() \n BuyWithdrawQty = rowSum(t.WithdrawBuyQtyList)\n SellWithdrawQty = rowSum(t.WithdrawSellQtyList)\n return (AvgBuyDuration, AvgSellDuration, BuyWithdrawQty, SellWithdrawQty)\n}\n\n// 定义 orderbook 引擎的输出表,需要包含基础字段(basic),报价/询价的多档价格和数量(depth),userDefinedMetrics 自定义指标的输出结果\noutputTableSch = genOutputColumnsForOBSnapshotEngine(basic=true, time=false, depth=(10, true), tradeDetail=false, orderDetail=false, withdrawDetail=false, orderBookDetailDepth=0, prevDetail=false)[1]\ncolNames = outputTableSch.schema().colDefs.name join (`AvgBuyDuration`AvgSellDuration`BuyWithdrawQty`SellWithdrawQty)\ncolTypes = outputTableSch.schema().colDefs.typeString join (`INT`INT`INT`INT) \noutputTable = table(1:0, colNames, colTypes)\n\n// 创建引擎,每1s计算输出深交所股票10档 orderbook \n\nengine = createOrderBookSnapshotEngine(name=\"demo\", exchange=\"XSHE\", orderbookDepth=10, intervalInMilli = 1000, date=2022.01.10, startTime=09:30:00.000, prevClose=prevClose, dummyTable=dummyOrderStream, outputTable=outputTable, inputColMap=inputColMap, outputColMap=outputColMap, orderBookAsArray=true, userDefinedMetrics=userDefinedFunc)\n\n\nengine.append!(select * from loadText(filePath) order by Time)\nselect top 10 * from outputTable where code=\"300593.SZ\", timestamp between 2022.01.10T13:15:01.000 and 2022.01.10T13:15:10.000\n```\n\n部分结果展示如下:\n\n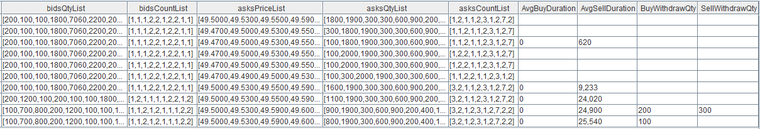\n\n相关函数:[genOutputColumnsForOBSnapshotEngine](https://docs.dolphindb.cn/zh/funcs/g/genoutputcolumnsforobsnapshotengine.html)\n\n相关教程:[基于逐笔数据合成高频 Orderbook:DolphinDB Orderbook 引擎](https://docs.dolphindb.cn/zh/tutorials/orderBookSnapshotEngine.html)\n\n#### 附录\n\n**basic(基础字段)**\n\n不指定 *outputColMap* 和 *userDefinedMetrics* 时,输出除 openPrice,maxPrice,minPrice 外的字段。\n\n<table id=\"table_e13_h2b_bbc\"><thead><tr><th>\n\n字段名\n\n</th><th>\n\n类型\n\n</th><th>\n\n说明\n\n</th></tr></thead><tbody><tr><td>\n\ncode\n\n</td><td>\n\nSYMBOL\n\n</td><td>\n\n证券代码\n\n</td></tr><tr><td>\n\ntimestamp\n\n</td><td>\n\nTIMESTAMP\n\n</td><td>\n\n快照时间戳,如以1s间隔合成快照:2022.08.01T09:20:00.000,2022.08.01T09:20:01.000\n\n</td></tr><tr><td>\n\nlastSeq\n\n</td><td>\n\nLONG\n\n</td><td>\n\n最后一条逐笔数据的序号(lastAppSeqNum)\n\n</td></tr><tr><td>\n\ntradingPhaseCode\n\n</td><td>\n\nINT\n\n</td><td>\n\n交易阶段代码(tradingPhaseCode)。枚举值:0(开盘前,启动)、1(开盘集合竞价)、2(开盘集合竞价阶段结束至连续竞价阶段开始之前)、3(连续竞价)、4(中午午休)、5(收盘集合竞价)\n\n</td></tr><tr><td>\n\nmodified\n\n</td><td>\n\nBOOL\n\n</td><td>\n\n各证券代码当前周期无输入数据,则对应输出表中的该字段显示为 false,否则显示为 true。\n\n</td></tr><tr><td>\n\nturnover\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n当前周期内的成交金额\n\n</td></tr><tr><td>\n\nvolume\n\n</td><td>\n\nLONG\n\n</td><td>\n\n当前周期内的成交量\n\n</td></tr><tr><td>\n\ntradeNum\n\n</td><td>\n\nINT\n\n</td><td>\n\n当前周期内的成交笔数\n\n</td></tr><tr><td>\n\nttlTurnover\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(totalTurnover)开盘到现在的成交金额\n\n</td></tr><tr><td>\n\nttlVolume\n\n</td><td>\n\nLONG\n\n</td><td>\n\n(totalVolume)开盘到现在的成交量\n\n</td></tr><tr><td>\n\nttlTradeNum\n\n</td><td>\n\nINT\n\n</td><td>\n\n(totalTradeNum)开盘到现在的成交笔数\n\n</td></tr><tr><td>\n\nlastPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(lastPx)最近成交价\n\n</td></tr><tr><td>\n\nhighPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(highPx)开盘到现在的最高价\n\n</td></tr><tr><td>\n\nlowPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(lowPx)开盘到现在的最低价\n\n</td></tr><tr><td>\n\nopenPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(openPx)开盘价\n\n</td></tr><tr><td>\n\navgAskPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(ask)卖出加权平均价 = 卖单的每一档价格\\*量 / 卖单的总量\n\n</td></tr><tr><td>\n\navgBidPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(bid)买入加权平均价 = 买单的每一档价格\\*量 / 买单的总量\n\n</td></tr><tr><td>\n\naskQty\n\n</td><td>\n\nLONG\n\n</td><td>\n\n(askVol)当前卖盘加权挂单量\n\n</td></tr><tr><td>\n\nbidQty\n\n</td><td>\n\nLONG\n\n</td><td>\n\n(bidVol)当前买盘加权挂单量\n\n</td></tr><tr><td>\n\npreClosePrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(preClosePx)昨收价。\n\n引擎外部定义昨收价,并以字典的方式传入引擎。\n\n</td></tr><tr><td>\n\nabnormal\n\n</td><td>\n\nBOOL\n\n</td><td>\n\n(invalid)输入数据是否异常:true 表示输入数据异常;false 表示输入数据正常。\n\n数据异常是指收到了逐笔成交或者撤单,却找不到对应的委托单。\n\n</td></tr><tr><td>\n\nmaxPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n涨停价。\n\n引擎外部定义涨停价,并以字典的方式传入引擎。\n\n</td></tr><tr><td>\n\nminPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n跌停价。\n\n引擎外部定义跌停价,并以字典的方式传入引擎。\n\n</td></tr></tbody>\n</table>**time(时间字段)**\n\n<table id=\"table_f13_h2b_bbc\"><thead><tr><th>\n\n字段名\n\n</th><th>\n\n类型\n\n</th><th>\n\n说明\n\n</th></tr></thead><tbody><tr><td>\n\nmdTime\n\n</td><td>\n\nTIME\n\n</td><td>\n\n快照时间戳,如以1s间隔合成快照:09:20:00.000,09:20:01.000\n\n</td></tr><tr><td>\n\nmdDate\n\n</td><td>\n\nDATE\n\n</td><td>\n\n快照日期。\n\n引擎外部定义快照日期,通过 date 参数传入引擎。\n\n</td></tr><tr><td>\n\nUpdateTime1\n\n</td><td>\n\nNANOTIMESTAMP\n\n</td><td>\n\n触发窗口关闭的那条输入数据的 receiveTime\n\n</td></tr><tr><td>\n\nUpdateTime2\n\n</td><td>\n\nNANOTIMESTAMP\n\n</td><td>\n\n触发窗口关闭后计算完成的系统时刻,即输出计算结果时的系统时间。\n\n</td></tr></tbody>\n</table>**depth(报价/询价档位)**\n\n不指定 *outputColMap* 和 *userDefinedMetrics* 时,会输出 depth 中的所有字段。提供两种方式存储 depth 数据。两种方式只能选其一:\n\n* 每个档位输出一列。比如 bidsPrice 有10个档位,则会输出10个 bidsPrice 字段:bidsPrice1、bidsPrice2、…、bidsPrice10。\n\n| 字段名 | 类型 | 说明 |\n| --------- | ----------- | ---------------------------------------------- |\n| bidsPrice | DOUBLE (多个) | (bids)多个字段,分别存放多档买入价格,档位由 *depth*确定 |\n| bidsQty | LONG (多个) | (bidVolumes)多个字段,分别存放多档买入数量,档位由 *depth* 确定 |\n| bidsCount | INT (多个) | (bidOrderNums)多个字段,分别存放多档买入委托笔数,档位由 *depth* 确定 |\n| asksPrice | DOUBLE (多个) | (asks)多个字段,分别存放多档卖出价格,档位由 *depth* 确定 |\n| asksQty | LONG (多个) | (askVolumes)多个字段,分别存放多档卖出数量,档位由 *depth* 确定 |\n| asksCount | INT (多个) | (askOrderNums)多个字段,分别存放多档卖出委托笔数,档位由 *depth* 确定 |\n\n* 多个档位输出到一个列字段,该列的类型为数组向量。比如 bidsPrice 有10个档位,则会将这10个档位以数组向量的形式输出到一个字段:bidsPriceList。\n\n| 字段名 | 类型 | 说明 |\n| ------------- | --------- | ------------------------------ |\n| bidsPriceList | DOUBLE\\[] | 数组向量,存放多档买入价格,档位由 *depth* 确定 |\n| bidsQtyList | LONG\\[] | 数组向量,存放多档买入数量,档位由 *depth* 确定 |\n| bidsCountList | INT\\[] | 数组向量,存放多档买入委托笔数,档位由 *depth* 确定 |\n| asksPriceList | DOUBLE\\[] | 数组向量,存放多档卖出价格,档位由 *depth* 确定 |\n| asksQtyList | LONG\\[] | 数组向量,存放多档卖出数量,档位由 *depth* 确定 |\n| asksCountList | INT\\[] | 数组向量,存放多档卖出委托笔数,档位由 *depth* 确定 |\n\n**tradeDetail(成交明细)**\n\n| 基础衍生字段 | 类型 | 含义 |\n| ------------------------ | --------- | ------------------------------------- |\n| buyQty | LONG | 当前周期内的买入总量 = sum( BSFlag=1 的成交的量) |\n| sellQty | LONG | 当前周期内的卖出总量 = sum( BSFlag=2的成交的量) |\n| buyMoney | DOUBLE | 当前周期内的买入总金额 = sum( BSFlag=1的成交的量\\*价格) |\n| sellMoney | DOUBLE | 当前周期内的卖出总金额 = sum( BSFlag=2的成交的量\\*价格) |\n| tradePriceList | DOUBLE\\[] | 当前周期内成交价格列表 |\n| tradeQtyList | LONG\\[] | 当前周期内成交量列表 |\n| tradeTypeList | INT\\[] | 当前周期内成交类型列表 |\n| tradeBSFlagList | INT\\[] | 当前周期内成交方向列表 |\n| tradeMDTimeList | TIME\\[] | 当前周期内成交时间列表 |\n| tradeBuyNoList | LONG\\[] | 当前周期内买方委托序号列表 |\n| tradeSellNoList | LONG\\[] | 当前周期内卖方委托序号列表 |\n| tradeOrderBuyNoTimeList | TIME\\[] | 当前周期内的有效成交对应的委托的买单下单时间 |\n| tradeOrderSellNoTimeList | TIME\\[] | 当前周期内的有效成交对应的委托的卖单下单时间 |\n\n**orderDetail (委托明细)**\n\n| 基础衍生字段 | 类型 | 含义 |\n| --------------- | --------- | ----------- |\n| orderPriceList | DOUBLE\\[] | 当前周期内委托价格列表 |\n| orderQtyList | LONG\\[] | 当前周期内成交量列表 |\n| orderTypeList | INT\\[] | 当前周期内委托类型列表 |\n| orderBSFlagList | INT\\[] | 当前周期内委托方向列表 |\n| orderMDTimeList | TIME\\[] | 当前周期内委托时间列表 |\n| orderNoList | LONG\\[] | 当前周期内委托序号列表 |\n\n**withdrawDetail(撤单明细)**\n\n| 基础衍生字段 | 类型 | 含义 |\n| --------------------------- | --------- | ----------------------- |\n| withdrawBuyPriceList | DOUBLE\\[] | 当前周期内买方撤单的委托价格 |\n| withdrawBuyQtyList | LONG\\[] | 当前周期内买方撤单的委托量 |\n| withdrawBuyOrderTypeList | INT\\[] | 当前周期内买方撤单的委托的订单类型 |\n| withdrawBuyMDTimeList | TIME\\[] | 当前周期内买方撤单的订单时间 |\n| withdrawBuyOrderMDTimeList | TIME\\[] | 当前周期内买方撤单对应的委托下单时间 |\n| WithdrawBuyOrderQtyList | LONG\\[] | 当前周期内买方撤单对应的原始委托数据中的委托量 |\n| withdrawSellPriceList | DOUBLE\\[] | 当前周期内卖方撤单的委托价格 |\n| withdrawSellQtyList | LONG\\[] | 当前周期内卖方撤单的委托量 |\n| withdrawSellOrderTypeList | INT\\[] | 当前周期内卖方撤单的委托的订单类型 |\n| withdrawSellMDTimeList | TIME\\[] | 当前周期内卖方撤单的订单时间 |\n| withdrawSellOrderMDTimeList | TIME\\[] | 当前周期内卖方撤单对应的委托下单时间 |\n| WithdrawSellOrderQtyList | LONG\\[] | 当前周期内卖方撤单对应的原始委托数据中的委托量 |\n\n**prevDetail(上一笔交易明细)**\n\n| 基础衍生字段 | 类型 | 含义 |\n| ------------------------ | ------- | -------------------------------- |\n| prevBuyPrice1 | DOUBLE | 上一笔快照的 BuyPrice1 价格 |\n| prevSellPrice1 | DOUBLE | 上一笔快照的 SellPrice1 价格 |\n| prevBuyAddQtyList1 | LONG\\[] | 价格为上一笔快照的 BuyPrice1,在当前周期内的申购明细 |\n| prevSellAddQtyList1 | LONG\\[] | 价格为上一笔快照的 SellPrice1,在当前周期内的申购明细 |\n| prevBuyWithdrawQtyList1 | LONG\\[] | 价格为上一笔快照的 BuyPrice1,在当前周期内的撤单明细 |\n| prevSellWithdrawQtyList1 | LONG\\[] | 价格为上一笔快照的 SellPrice1,在当前周期内的撤单明细 |\n\n**orderBookDetailDepth( orderbook 明细档位)**\n\n每个档位输出一列,该列的类型是数组向量。比如 buyQtyList 有20个档位,则会输出20个 buyQtyList 字段:buyQtyList1、buyQtyList2、…、buyQtyList20。buyValueList,sellQtyList 和 sellValueList 同理。\n\n<table id=\"table_a2y_q2t_2bc\"><thead><tr><th>\n\n基础衍生字段\n\n</th><th>\n\n类型\n\n</th><th>\n\n含义\n\n</th></tr></thead><tbody><tr><td>\n\nbuyQtyList\n\n</td><td>\n\nLONG\\[](多个)\n\n</td><td>\n\n当前最新盘口各档位买入的每一笔委托的数量\n\n</td></tr><tr><td>\n\nbuyValueList\n\n</td><td>\n\nDOUBLE\\[](多个)\n\n</td><td>\n\n当前最新盘口各档位买入的每一笔委托的金额\n\n</td></tr><tr><td>\n\nsellQtyList\n\n</td><td>\n\nLONG\\[](多个)\n\n</td><td>\n\n前最新盘口各档位卖出的每一笔委托的数量\n\n</td></tr><tr><td>\n\nsellValueList\n\n</td><td>\n\nDOUBLE\\[](多个)\n\n</td><td>\n\n前最新盘口各档位卖出的每一笔委托的金额\n\n</td></tr></tbody>\n</table>**seqDetail(sequence 明细)**\n\n<table id=\"table_jyr_xmf_fcc\"><thead><tr><th>\n\n基础衍生字段\n\n</th><th>\n\n类型\n\n</th><th>\n\n含义\n\n</th></tr></thead><tbody><tr><td>\n\ntradeSeqList\n\n</td><td>\n\nLONG\\[]\n\n</td><td>\n\n当前周期内的成交序号列表\n\n</td></tr><tr><td>\n\norderSeqList\n\n</td><td>\n\nLONG\\[]\n\n</td><td>\n\n当前周期内的委托序号列表\n\n</td></tr><tr><td>\n\nwithdrawBuySeqList\n\n</td><td>\n\nLONG\\[]\n\n</td><td>\n\n当前周期内的买方撤单序号列表\n\n</td></tr><tr><td>\n\nwithdrawSellSeqList\n\n</td><td>\n\nLONG\\[]\n\n</td><td>\n\n当前周期内的卖方撤单序号列表\n\n</td></tr></tbody>\n</table>\n"
|
|
5065
|
+
"markdown": "### [createOrderBookSnapshotEngine](https://docs.dolphindb.cn/zh/funcs/c/createorderbooksnapshotengine.html)\n\n\n\n#### 语法\n\ncreateOrderBookSnapshotEngine(name, exchange, orderbookDepth, intervalInMilli, date, startTime, prevClose, dummyTable, outputTable, inputColMap, \\[outputColMap], \\[outputCodeMap], \\[snapshotDir], \\[snapshotIntervalInMsgCount], \\[raftGroup], \\[outputIntervalOffsetMap], \\[checkRestrict], \\[maxPrice], \\[minPrice], \\[userDefinedMetrics], \\[priceNullFill], \\[triggerType], \\[forceTriggerTime], \\[precision], \\[orderBySeq], \\[skipCrossedMarket=true], \\[orderBookDetailDepth=0], \\[orderBookAsArray=false], \\[useSystemTime=false])\n\n**Note:**\n\n社区版 License 暂不支持该引擎,如需使用此功能,请联系技术支持。\n\n#### 详情\n\n该函数基于一个包含了逐笔委托和逐笔交易数据表,实时合成指定频率(1秒,100ms,30ms 等)的全档位盘口信息、窗口内统计信息、全天累计统计信息等订单薄(或者叫快照)数据。也可通过历史逐笔数据来合成需要的订单薄数据。\n\n目前支持合成深交所股票、深交所可转债、深交所基金、上交所股票、上交所可转债、上交所基金的订单薄数据。请注意,可转债的规则遵循自2022年8月之后发布的新规定。\n\n##### 窗口规则\n\n由参数 *intervalInMilli*指定窗口的长度(以时间衡量),输出表中显示的时间为窗口的右边界。最后一个窗口的右边界最大值是 14:57:00.000,此时,窗口区间为左开右开,且输出窗口显示为右边界的时间戳(14:57:00.000),其余情况的窗口区间全部左开右闭。\n\n##### 触发规则\n\n第一条输出记录由输入表中第一条时间戳大于 startTime + intervalInMilli 的记录触发,此时输出表的时间戳为 startTime + intervalInMili。之后根据参数 *triggerType*的配置值,决定新收到任意一条逐笔数据,当其时间戳大于窗口右边界时,触发输出单个或所有证券代码的快照。\n\n**Note:**\n\n* 一个引擎至多只能输入某一天一个通道的全部股票数据。\n* 必须保证注入引擎的数据表内的数据按照交易所的逐笔序号排序。\n\n#### 参数\n\n**Note:** 传参时必须指定参数名。\n\n**name** 字符串标量,表示 orderbook 快照引擎的名称,可包含字母,数字和下划线,但必须以字母开头。\n\n**exchange** 字符串标量,表示证券的类型。可选参数:\n\n* “XSHE” 或 “XSHESTOCK”:深交所股票\n* “XSHEBOND”:深交所可转债\n* “XSHEFUND”:深交所基金\n* “XSHG” 或 “XSHGSTOCK”:上交所股票\n* “XSHGBOND”:上交所可转债\n* “XSHGFUND”:上交所基金\n\n**orderbookDepth** 正整数,表示 orderbook 中最多能够显示的买卖报价的档位。\n\n**intervalInMilli** 正整数,表示触发输出数据的时间间隔,即合成快照的时间频率,单位为毫秒。\n\n**date** DATE 类型标量,表示交易日期。该参数和窗口右边界组合成输出表的 TIMESTAMP 列。\n\n**startTime** TIME 类型标量,表示触发输出数据的起始时刻。引擎只会输出该参数指定时刻(规整后)之后的数据。\n\n**prevClose** 字典,其 key 为字符串标量或向量,表示股票代码;其 value 为数值类型,表示对应于股票代码的上一个交易日的收盘价格。\n\n**dummyTable** 一个表对象,和订阅的流数据表的 schema 一致,可以含有数据,亦可为空表。。\n\n**outputTable** 一个表对象。若指定 *userDefinedMetrics*,*outputTable* 根据 `genOutputColumnsForOBSnapshotEngine` 函数指定的 *basic*、*depth* 以及用户自定义的指标来确定表结构。否则,*outputTable* 根据 *outputColMap*的设置来确定表结构。\n\n**inputColMap** 字典,将输入表中列字段的名称映射为引擎计算所需要的列。其中:\n\n* key 为字符串类型,表示引擎所需要的固定的输入字段。具体字段名和含义见下表。注意,这些 key 区分大小写,必须全部指定,但顺序可以不固定。\n* value 为字符串类型,表示输入表中对应的列名称。\n\n<table id=\"table_s52_ghv_x1c\"><thead><tr><th>\n\nkey\n\n</th><th>\n\nvalue 对应的字段类型\n\n</th><th>\n\n含义\n\n</th></tr></thead><tbody><tr><td>\n\n“timeColumn”\n\n</td><td>\n\nTIME\n\n</td><td>\n\n交易时间\n\n</td></tr><tr><td>\n\n“typeColumn”\n\n</td><td>\n\nINT\n\n</td><td>\n\n交易类型:- 如果是逐笔委托单,则:1表示市价;2表示限价;3表示本方最优;10表示撤单(仅上交所);11市场状态(仅上交所)\n\n* 如果是逐笔成交单,则:0表示成交;1表示撤单(仅深交所)\n\n</td></tr><tr><td>\n\n“priceColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n价格,真实价格\\*10000\n\n</td></tr><tr><td>\n\n“qtyColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n数量(股数)\n\n</td></tr><tr><td>\n\n“buyOrderColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n* 逐笔成交:对应其原始成交中的买方委托序号。\n* 逐笔委托:\n * 上交所:填充原始委托中的原始订单号,即上交所在新增、删除订单时用以标识订单的唯一编号(OrderNo 字段)\n * 深交所:填充0。此字段为深交所为了补全上交所数据格式而增加的冗余列\n\n</td></tr><tr><td>\n\n“sellOrderColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n* 逐笔成交:对应其原始成交中的卖方委托序号。\n* 逐笔委托:\n * 上交所:填充原始委托中的原始订单号,即上交所在新增、删除订单时用以标识订单的唯一编号(OrderNo 字段)\n * 深交所:填充0。此字段深交所为了补全上交所数据格式而增加的冗余列\n\n</td></tr><tr><td>\n\n“sideColumn”\n\n</td><td>\n\nINT\n\n</td><td>\n\n买卖方向:1表示买单;2表示卖单说明:\n\n* 委托单的 BSFlag,必填\n* 撤单的 BSFlag 由原始委托单决定买卖方向,必填\n* 成交单的 BSFlag,不影响结果,非必填\n\n</td></tr><tr><td>\n\n“msgTypeColumn”\n\n</td><td>\n\nINT\n\n</td><td>\n\n数据类型:- 0表示逐笔委托;\n\n* 1表示逐笔成交;\n* -1表示产品状态。\n\n</td></tr><tr><td>\n\n“seqColumn”\n\n</td><td>\n\nLONG\n\n</td><td>\n\n一个通道内从 1 开始递增的逐笔数据序号。深交所为 appseqlnum 字段,若深交所数据中包含 index 字段,也可以使用 index;上交所为 bizIndex 字段。\n\n</td></tr><tr><td>\n\n“codeColumn”\n\n</td><td>\n\nSYMBOL\n\n</td><td>\n\n证券代码(如300010.SZ)\n\n</td></tr></tbody>\n</table>**Note:** 引擎规范了枚举类型中各枚举值的具体含义。输入表对应的枚举值必须遵守这个规范。比如枚举类型字段 sideColumn 所对应的输入表中的字段必须使用 1 代表买方向,2 代表卖方向。\n\n**outputColMap** 可选参数,字符串向量,用于指定需要输出的字段名称,不区分大小写。为方便指定 *outputColMap*,用户可通过 `genOutputColumnsForOBSnapshotEngine` 函数生成需要输出的字段名称,将返回值的第一个元素赋值给 *outputColMap* 即可。\n\n**outputCodeMap** 可选参数,字符串向量,表示股票代码,例如:“000803.SZ”。指定该参数后,将只输出指定股票对应的数据。\n\n**outputIntervalOffsetMap** 可选参数,向量或字典,用于指定输出表中股票被触发计算的时间偏移量。\n\n* 当为向量时,向量中的元素表示不同的时间偏移量,单位为毫秒。引擎将根据输入的股票数量自动将这些股票均匀分配到这些偏移量上。例如,outputIntervalOffsetMap = \\[400, 500],表示引擎将自动将输入的股票均匀分成两部分,经过intervalInMilli + 400(ms) 后触发其中一部分股票的数据输出;经过 intervalInMilli + 500(ms) 后触发另一部分股票的数据输出。\n* 当为字典时,其 key 为字符串类型,表示股票代码;其 value 为整型,表示时间偏移量,单位为毫秒。例如:outputIntervalOffsetMap =dict(\\[\"127053.sz\",\"123082.SZ\"],\\[400, 500]),表示经过 intervalInMilli + 400(ms) 后触发 127053.sz 股票的数据输出;经过 intervalInMilli + 500(ms) 后触发 123082.SZ 股票的数据输出。\n\n**checkRestrict** 可选参数,布尔值,默认值为 true,表示开启价格笼子机制;若设置为 false,则关闭笼子机制,此时会取消对股票交易的限制,创业板合成出的快照可能不正确。\n\n**Note:** 深交所对创业板证券(证券代码以 3 开头)设定了价格笼子。在 *checkRestrict*=true 时,引擎只会将证券代码的首字符是否为 3 作为是否执行价格笼子的判断标准。因此,在向引擎输入创业板数据时,证券代码必须以 3 开头。\n\n**maxPrice** 可选参数,字典。其 key 为字符串类型,表示证券代码;其 value 为 DOUBLE 类型,表示涨停价格。\n\n**minPrice** 可选参数,字典。其 key 为字符串类型,表示证券代码;其 value 为 DOUBLE 类型,表示跌停价格。\n\n**userDefinedMetrics** 可选参数,一元函数。\n\n* 函数的入参是一个表,表的每一行是一个标的,每一列是标的对应的快照。若指定 *outputColMap*,则表中数据为 *outputColMap*设置的字段;否则表中数据为基础字段和报价/询价的价格和数量。\n\n* 函数的返回值是一个元组,元组的每一个元素是一个常规向量,代表每个标的经对应指标计算后的结果。\n\n**priceNullFill** 一个数字。该参数值用于填充输出表中多档买/卖价格中缺失档位的价格。例如涨停后卖单的价格都为 NULL,此时如有指定卖单价格为 0 的需求,可以设置 priceNullFill=0。\n\n**triggerType** 可选参数,字符串标量,表示触发方式。可选值为:\n\n* “mutual”:新收到任意一条逐笔数据,当其时间戳大于窗口右边界时,就会触发所有股票未计算的快照合成输出。触发计算的数据并不会参与该次计算。\n* “independent”:新收到任意一条逐笔数据,当其时间戳大于窗口右边界时,只触发该条数据对应股票未计算的快照合成输出。触发计算的数据并不会参与该次计算。\n* “perRow”:每收到一行逐笔数据都会触发该条数据对应股票计算并输出,触发计算的数据并参与该次计算。\n\n**forceTriggerTime** 可选参数,是非负整数,单位为毫秒。除了正常触发合成快照外,有时会出现一些数据因乱序不能触发合成快照,而是被缓存在引擎中。在这种情况下,可通过该参数设置强制触发引擎中长时间未处理的逐笔数据合成快照。触发规则为:\n\n1. 最新收到的逐笔数据的时间戳(t )减去最后一条已经处理的交易数据的时间戳(t0 )大于或等于 *forceTriggerTime*,则触发未处理的数据中序号最小的那条数据合成快照,并更新已经处理的交易数据的时间戳(t1)。\n2. 重复上述操作,若判断 t-t1 >= *forceTriggerTime*,则触发未处理的数据中序号最小的那条数据合成快照,并更新已经处理的交易数据的时间戳(t2);直到两个时间戳的差值小于 *forceTriggerTime*时,停止触发快照合成。\n\n**precision** 可选参数,非负整数,表示小数位数,取值范围为\\[0,4]。若指定该参数,则输出表中所有的价格将按照指定的位数进行四舍五入。否则,按照原始结果输出。\n\n**orderBySeq** 可选参数,布尔值或元组\n\n* 指定该参数值为布尔值时,表示是否按照逐笔数据中的 seqColumn 列中值的大小顺序处理数据。\n * 当 *orderBySeq*=true(默认值) 时,会根据逐笔数据的序号有序处理数据,并计算输出。例如引擎先后收到序号为1,3的数据,因为缺少序号为2的数据,引擎先将1和3的数据缓存,待收到序号2的数据时,再进行计算输出。此时也可以指定 *forceTriggerTime*强制触发计算输出。\n * 当 *orderBySeq*=false 时,每接收到一条数据都会立即进行计算并输出,此时不可设置 *forceTriggerTime*。\n* 指定该参数值为元组时,以(BOOL, INTEGER, \\[STRING])的形式表示,其中:\n * 第一个元素为布尔值,表示是否按照逐笔数据的序号有序输出结果的布尔值,作用同上。\n * 第二个元素为正整数,表示记录缓存输入数据量的时间间隔,单位为毫秒(ms)。\n * 第三个元素为指定输出日志级别的字符串标量,可选参数,其可用值为 DEBUG (默认值)和 INFO,分别对应 Debug 和 Info 级别的日志输出。\n\n**skipCrossedMarket**可选参数, 布尔值,表示是否输出买一卖一价交叉的计算结果。\n\n* 当 *skipCrossedMarket*=true(默认值)时,若设置 *useSystemTime* = false,若出现买一卖一价交叉,即卖一价<=买一价,则不输出该条结果;若设置 *useSystemTime* = true,则出现买一卖一交叉时,暂时不输出该条快照,若接下来收到的数据不再有交叉,则立即触发该条快照输出。\n* 当 *skipCrossedMarket*=false 时,若出现买一卖一价交叉,仍然输出该条结果。\n\n**orderBookDetailDepth** 可选参数,整型标量,表示 orderbook 明细的深度。默认值为0,表示不输出。该参数必须和 *outputColMap* 中 orderBookDetailDepth 字段的值保持一致。\n\n**orderBookAsArray** 可选参数,布尔值,表示是否以数组向量形式输出报价/询价的价格和数量。默认值为 false,价格和数量将以多列形式输出。\n\n注意,若指定 *userDefinedMetrics*,价格和数量的输出形式由 *orderBookAsArray* 确定。否则,价格和数量的输出形式由 *outputColMap* 确定,该参数失效。\n\n**useSystemTime** 可选参数,布尔值,表示是否使用系统时间来触发快照输出。\n\n* 当 *useSystemTime* = true 时,引擎将基于当前的系统时间,按照 *intervalInMilli* 设置的时间间隔触发快照输出。此时,不能指定*skipCrossedMarket* 和 *forceTriggerTime*;可以不指定 *triggerType*,或者指定为 *triggerType*=“mutual”\n* 当 *useSystemTime* = false(缺省值)时,引擎根据事件时间来触发快照输出。\n\n#### 例子\n\n运行代码前,先下载 [../data/orderbookDemoInput.zip](https://docs.dolphindb.cn/zh/funcs/data/orderbookDemoInput.zip) 文件。\n\n```\n// 登录\nlogin(\"admin\", \"123456\")\n\n// 释放已有的引擎\ntry { dropStreamEngine(\"demo\") } catch(ex) { print(ex) }\n\n// 创建引擎参数 outputTable,即指定输出表\nsuffix = string(1..10)\ncolNames = `SecurityID`timestamp`lastAppSeqNum`tradingPhaseCode`modified`turnover`volume`tradeNum`totalTurnover`totalVolume`totalTradeNum`lastPx`highPx`lowPx`ask`bid`askVol`bidVol`preClosePx`invalid join (\"bids\" + suffix) join (\"bidVolumes\" + suffix) join (\"bidOrderNums\" + suffix) join (\"asks\" + suffix) join (\"askVolumes\" + suffix) join (\"askOrderNums\" + suffix) \ncolTypes = [SYMBOL,TIMESTAMP,LONG,INT,BOOL,DOUBLE,LONG,INT,DOUBLE,LONG,INT,DOUBLE,DOUBLE,DOUBLE,DOUBLE,DOUBLE,LONG,LONG,DOUBLE,BOOL] join take(DOUBLE, 10) join take(LONG, 10) join take(INT, 10) join take(DOUBLE, 10) join take(LONG, 10) join take(INT, 10) \nshare table(10000000:0, colNames, colTypes) as outTable\n\n// 创建引擎参数 dummyTable,即指定输入表的表结构\ncolNames = `SecurityID`Date`Time`SecurityIDSource`SecurityType`Index`SourceType`Type`Price`Qty`BSFlag`BuyNo`SellNo`ApplSeqNum`ChannelNo\ncolTypes = [SYMBOL, DATE, TIME, SYMBOL, SYMBOL, LONG, INT, INT, LONG, LONG, INT, LONG, LONG, LONG, INT]\ndummyOrderStream = table(1:0, colNames, colTypes)\n\n// 创建引擎参数 inputColMap,即指定输入表各字段的含义\ninputColMap = dict(`codeColumn`timeColumn`typeColumn`priceColumn`qtyColumn`buyOrderColumn`sellOrderColumn`sideColumn`msgTypeColumn`seqColumn, `SecurityID`Time`Type`Price`Qty`BuyNo`SellNo`BSFlag`SourceType`ApplSeqNum)\n\n// 创建引擎参数 prevClose,即昨日收盘价,prevClose 不影响最终的输出结果中除昨日收盘价以外的其他字段\nprevClose = dict(`000587.SZ`002694.SZ`002822.SZ`000683.SZ`301063.SZ`300459.SZ`300057.SZ`300593.SZ`301035.SZ`300765.SZ, [1.66, 6.56, 6.10, 8.47, 38.10, 5.34, 9.14, 48.81, 60.04, 16.52])\n\n// 定义引擎,每1s计算输出深交所股票10档买卖盘口\nengine = createOrderBookSnapshotEngine(name=\"demo\", exchange=\"XSHE\", orderbookDepth=10, intervalInMilli = 1000, date=2022.01.10, startTime=09:15:00.000, prevClose=prevClose, dummyTable=dummyOrderStream, outputTable=outTable, inputColMap=inputColMap)\n\nfilePath = \"./orderbookDemoInput.csv\"\ncolNames = `SecurityID`Date`Time`SecurityIDSource`SecurityType`Index`SourceType`Type`Price`Qty`BSFlag`BuyNo`SellNo`ApplSeqNum`ChannelNo\ncolTypes = [SYMBOL, DATE, TIME, SYMBOL, SYMBOL, LONG, INT, INT, LONG, LONG, INT, LONG, LONG, LONG, INT]\norderTrade = table(1:0, colNames, colTypes)\norderTrade.append!(select * from loadText(filePath) order by Time)\n\n// 10支股票的逐笔数据批量注入快照合成引擎\nengine.append!(orderTrade)\nselect count(*) from outTable where SecurityID=\"300593.SZ\", timestamp between 2022.01.10T13:15:01.000 and 2022.01.10T13:15:10.000\n\n//output: 10\n```\n\n通过 *outputColMap*指定需要输出的字段。`genOutputColumnsForOBSnapshotEngine` 函数返回值的第一个元素即为 *outputColMap*,返回值的第二个元素可以确定 *outputTable* 的 schema。\n\n```\ntry { dropStreamEngine(\"demo\") } catch(ex) { print(ex) }\n\nfilePath = \"./orderbookDemoInput.csv\"\n\n// 创建引擎参数 dummyTable,即指定输入表的表结构\ncolNames = `SecurityID`Date`Time`SecurityIDSource`SecurityType`Index`SourceType`Type`Price`Qty`BSFlag`BuyNo`SellNo`ApplSeqNum`ChannelNo\ncolTypes = [SYMBOL, DATE, TIME, SYMBOL, SYMBOL, LONG, INT, INT, LONG, LONG, INT, LONG, LONG, LONG, INT]\nshare table(1:0, colNames, colTypes) as dummyOrderStream\n\n// 创建引擎参数 inputColMap,即指定输入表各字段的含义\ninputColMap = dict(`codeColumn`timeColumn`typeColumn`priceColumn`qtyColumn`buyOrderColumn`sellOrderColumn`sideColumn`msgTypeColumn`seqColumn, `SecurityID`Time`Type`Price`Qty`BuyNo`SellNo`BSFlag`SourceType`ApplSeqNum)\n\n// 创建引擎参数 prevClose,即昨日收盘价,prevClose 不影响最终的输出结果中除昨日收盘价以外的其他字段\nprevClose = dict(`000587.SZ`002694.SZ`002822.SZ`000683.SZ`301063.SZ`300459.SZ`300057.SZ`300593.SZ`301035.SZ`300765.SZ, [1.66, 6.56, 6.10, 8.47, 38.10, 5.34, 9.14, 48.81, 60.04, 16.52])\n\n//创建使用 outputColMap 和 outputTableSch 接收 genOutputColumnsForOBSnapshotEngine 的返回值。它们分别用于确定 outputColMap 和 outputTable\noutputColMap, outputTableSch = genOutputColumnsForOBSnapshotEngine(basic=true, time=false, depth=(10, true), tradeDetail=true, orderDetail=false, withdrawDetail=false, orderBookDetailDepth=0, prevDetail=false)\n\nengine = createOrderBookSnapshotEngine(name=\"demo\", exchange=\"XSHE\", orderbookDepth=10, intervalInMilli = 1000, date=2022.01.10, startTime=09:15:00.000, prevClose=prevClose, dummyTable=dummyOrderStream, outputTable=outputTableSch, inputColMap=inputColMap, outputColMap=outputColMap, orderBookAsArray=true)\n\n// 10支股票的逐笔数据批量注入快照合成引擎\nengine.append!(select * from loadText(filePath) order by Time)\nselect top 10 * from outputTableSch where code=\"300593.SZ\", timestamp between 2022.01.10T13:15:01.000 and 2022.01.10T13:15:10.000\n```\n\n部分结果展示如下:\n\n\n\n```\ntry { dropStreamEngine(\"demo\") } catch(ex) { print(ex) }\n\nfilePath = \"./orderbookDemoInput.csv\"\n\n// 创建引擎参数 dummyTable,即指定输入表的表结构\ncolNames = `SecurityID`Date`Time`SecurityIDSource`SecurityType`Index`SourceType`Type`Price`Qty`BSFlag`BuyNo`SellNo`ApplSeqNum`ChannelNo\ncolTypes = [SYMBOL, DATE, TIME, SYMBOL, SYMBOL, LONG, INT, INT, LONG, LONG, INT, LONG, LONG, LONG, INT]\nshare table(1:0, colNames, colTypes) as dummyOrderStream\n\n// 创建引擎参数 inputColMap,即指定输入表各字段的含义\ninputColMap = dict(`codeColumn`timeColumn`typeColumn`priceColumn`qtyColumn`buyOrderColumn`sellOrderColumn`sideColumn`msgTypeColumn`seqColumn, `SecurityID`Time`Type`Price`Qty`BuyNo`SellNo`BSFlag`SourceType`ApplSeqNum)\n\n// 创建引擎参数 prevClose,即昨日收盘价,prevClose 不影响最终的输出结果中除昨日收盘价以外的其他字段\nprevClose = dict(`000587.SZ`002694.SZ`002822.SZ`000683.SZ`301063.SZ`300459.SZ`300057.SZ`300593.SZ`301035.SZ`300765.SZ, [1.66, 6.56, 6.10, 8.47, 38.10, 5.34, 9.14, 48.81, 60.04, 16.52])\n\n//此处只定义 outputColMap 接收 genOutputColumnsForOBSnapshotEngine 的第一个返回值。因 userDefinedMetrics 定义的指标中需要使用委托明细和回撤明细,因此 genOutputColumnsForOBSnapshotEngine 需要指定 orderDetail=false, withdrawDetail=true\noutputColMap = genOutputColumnsForOBSnapshotEngine(basic=true, time=false, depth=(10, true), tradeDetail=true, orderDetail=false, withdrawDetail=true, orderBookDetailDepth=0, prevDetail=false)[0]\n\n\n//// 定义用户自定义因子\ndef userDefinedFunc(t){\n AvgBuyDuration = rowAvg(t.TradeMDTimeList-t.TradeOrderBuyNoTimeList).int()\n AvgSellDuration = rowAvg(t.TradeMDTimeList-t.TradeOrderSellNoTimeList).int() \n BuyWithdrawQty = rowSum(t.WithdrawBuyQtyList)\n SellWithdrawQty = rowSum(t.WithdrawSellQtyList)\n return (AvgBuyDuration, AvgSellDuration, BuyWithdrawQty, SellWithdrawQty)\n}\n\n// 定义 orderbook 引擎的输出表,需要包含基础字段(basic),报价/询价的多档价格和数量(depth),userDefinedMetrics 自定义指标的输出结果\noutputTableSch = genOutputColumnsForOBSnapshotEngine(basic=true, time=false, depth=(10, true), tradeDetail=false, orderDetail=false, withdrawDetail=false, orderBookDetailDepth=0, prevDetail=false)[1]\ncolNames = outputTableSch.schema().colDefs.name join (`AvgBuyDuration`AvgSellDuration`BuyWithdrawQty`SellWithdrawQty)\ncolTypes = outputTableSch.schema().colDefs.typeString join (`INT`INT`INT`INT) \noutputTable = table(1:0, colNames, colTypes)\n\n// 创建引擎,每1s计算输出深交所股票10档 orderbook \n\nengine = createOrderBookSnapshotEngine(name=\"demo\", exchange=\"XSHE\", orderbookDepth=10, intervalInMilli = 1000, date=2022.01.10, startTime=09:30:00.000, prevClose=prevClose, dummyTable=dummyOrderStream, outputTable=outputTable, inputColMap=inputColMap, outputColMap=outputColMap, orderBookAsArray=true, userDefinedMetrics=userDefinedFunc)\n\n\nengine.append!(select * from loadText(filePath) order by Time)\nselect top 10 * from outputTable where code=\"300593.SZ\", timestamp between 2022.01.10T13:15:01.000 and 2022.01.10T13:15:10.000\n```\n\n部分结果展示如下:\n\n\n\n相关函数:[genOutputColumnsForOBSnapshotEngine](https://docs.dolphindb.cn/zh/funcs/g/genoutputcolumnsforobsnapshotengine.html)\n\n相关教程:[基于逐笔数据合成高频 Orderbook:DolphinDB Orderbook 引擎](https://docs.dolphindb.cn/zh/tutorials/orderBookSnapshotEngine.html)\n\n#### 附录\n\n**basic(基础字段)**\n\n不指定 *outputColMap* 和 *userDefinedMetrics* 时,输出除 openPrice,maxPrice,minPrice 外的字段。\n\n<table id=\"table_e13_h2b_bbc\"><thead><tr><th>\n\n字段名\n\n</th><th>\n\n类型\n\n</th><th>\n\n说明\n\n</th></tr></thead><tbody><tr><td>\n\ncode\n\n</td><td>\n\nSYMBOL\n\n</td><td>\n\n证券代码\n\n</td></tr><tr><td>\n\ntimestamp\n\n</td><td>\n\nTIMESTAMP\n\n</td><td>\n\n快照时间戳,如以1s间隔合成快照:2022.08.01T09:20:00.000,2022.08.01T09:20:01.000\n\n</td></tr><tr><td>\n\nlastSeq\n\n</td><td>\n\nLONG\n\n</td><td>\n\n最后一条逐笔数据的序号(lastAppSeqNum)\n\n</td></tr><tr><td>\n\ntradingPhaseCode\n\n</td><td>\n\nINT\n\n</td><td>\n\n交易阶段代码(tradingPhaseCode)。枚举值:0(开盘前,启动)、1(开盘集合竞价)、2(开盘集合竞价阶段结束至连续竞价阶段开始之前)、3(连续竞价)、4(中午午休)、5(收盘集合竞价)\n\n</td></tr><tr><td>\n\nmodified\n\n</td><td>\n\nBOOL\n\n</td><td>\n\n各证券代码当前周期无输入数据,则对应输出表中的该字段显示为 false,否则显示为 true。\n\n</td></tr><tr><td>\n\nturnover\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n当前周期内的成交金额\n\n</td></tr><tr><td>\n\nvolume\n\n</td><td>\n\nLONG\n\n</td><td>\n\n当前周期内的成交量\n\n</td></tr><tr><td>\n\ntradeNum\n\n</td><td>\n\nINT\n\n</td><td>\n\n当前周期内的成交笔数\n\n</td></tr><tr><td>\n\nttlTurnover\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(totalTurnover)开盘到现在的成交金额\n\n</td></tr><tr><td>\n\nttlVolume\n\n</td><td>\n\nLONG\n\n</td><td>\n\n(totalVolume)开盘到现在的成交量\n\n</td></tr><tr><td>\n\nttlTradeNum\n\n</td><td>\n\nINT\n\n</td><td>\n\n(totalTradeNum)开盘到现在的成交笔数\n\n</td></tr><tr><td>\n\nlastPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(lastPx)最近成交价\n\n</td></tr><tr><td>\n\nhighPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(highPx)开盘到现在的最高价\n\n</td></tr><tr><td>\n\nlowPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(lowPx)开盘到现在的最低价\n\n</td></tr><tr><td>\n\nopenPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(openPx)开盘价\n\n</td></tr><tr><td>\n\navgAskPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(ask)卖出加权平均价 = 卖单的每一档价格\\*量 / 卖单的总量\n\n</td></tr><tr><td>\n\navgBidPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(bid)买入加权平均价 = 买单的每一档价格\\*量 / 买单的总量\n\n</td></tr><tr><td>\n\naskQty\n\n</td><td>\n\nLONG\n\n</td><td>\n\n(askVol)当前卖盘加权挂单量\n\n</td></tr><tr><td>\n\nbidQty\n\n</td><td>\n\nLONG\n\n</td><td>\n\n(bidVol)当前买盘加权挂单量\n\n</td></tr><tr><td>\n\npreClosePrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n(preClosePx)昨收价。\n\n引擎外部定义昨收价,并以字典的方式传入引擎。\n\n</td></tr><tr><td>\n\nabnormal\n\n</td><td>\n\nBOOL\n\n</td><td>\n\n(invalid)输入数据是否异常:true 表示输入数据异常;false 表示输入数据正常。\n\n数据异常是指收到了逐笔成交或者撤单,却找不到对应的委托单。\n\n</td></tr><tr><td>\n\nmaxPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n涨停价。\n\n引擎外部定义涨停价,并以字典的方式传入引擎。\n\n</td></tr><tr><td>\n\nminPrice\n\n</td><td>\n\nDOUBLE\n\n</td><td>\n\n跌停价。\n\n引擎外部定义跌停价,并以字典的方式传入引擎。\n\n</td></tr></tbody>\n</table>**time(时间字段)**\n\n<table id=\"table_f13_h2b_bbc\"><thead><tr><th>\n\n字段名\n\n</th><th>\n\n类型\n\n</th><th>\n\n说明\n\n</th></tr></thead><tbody><tr><td>\n\nmdTime\n\n</td><td>\n\nTIME\n\n</td><td>\n\n快照时间戳,如以1s间隔合成快照:09:20:00.000,09:20:01.000\n\n</td></tr><tr><td>\n\nmdDate\n\n</td><td>\n\nDATE\n\n</td><td>\n\n快照日期。\n\n引擎外部定义快照日期,通过 date 参数传入引擎。\n\n</td></tr><tr><td>\n\nUpdateTime1\n\n</td><td>\n\nNANOTIMESTAMP\n\n</td><td>\n\n触发窗口关闭的那条输入数据的 receiveTime\n\n</td></tr><tr><td>\n\nUpdateTime2\n\n</td><td>\n\nNANOTIMESTAMP\n\n</td><td>\n\n触发窗口关闭后计算完成的系统时刻,即输出计算结果时的系统时间。\n\n</td></tr></tbody>\n</table>**depth(报价/询价档位)**\n\n不指定 *outputColMap* 和 *userDefinedMetrics* 时,会输出 depth 中的所有字段。提供两种方式存储 depth 数据。两种方式只能选其一:\n\n* 每个档位输出一列。比如 bidsPrice 有10个档位,则会输出10个 bidsPrice 字段:bidsPrice1、bidsPrice2、…、bidsPrice10。\n\n| 字段名 | 类型 | 说明 |\n| --------- | ----------- | ---------------------------------------------- |\n| bidsPrice | DOUBLE (多个) | (bids)多个字段,分别存放多档买入价格,档位由 *depth*确定 |\n| bidsQty | LONG (多个) | (bidVolumes)多个字段,分别存放多档买入数量,档位由 *depth* 确定 |\n| bidsCount | INT (多个) | (bidOrderNums)多个字段,分别存放多档买入委托笔数,档位由 *depth* 确定 |\n| asksPrice | DOUBLE (多个) | (asks)多个字段,分别存放多档卖出价格,档位由 *depth* 确定 |\n| asksQty | LONG (多个) | (askVolumes)多个字段,分别存放多档卖出数量,档位由 *depth* 确定 |\n| asksCount | INT (多个) | (askOrderNums)多个字段,分别存放多档卖出委托笔数,档位由 *depth* 确定 |\n\n* 多个档位输出到一个列字段,该列的类型为数组向量。比如 bidsPrice 有10个档位,则会将这10个档位以数组向量的形式输出到一个字段:bidsPriceList。\n\n| 字段名 | 类型 | 说明 |\n| ------------- | --------- | ------------------------------ |\n| bidsPriceList | DOUBLE\\[] | 数组向量,存放多档买入价格,档位由 *depth* 确定 |\n| bidsQtyList | LONG\\[] | 数组向量,存放多档买入数量,档位由 *depth* 确定 |\n| bidsCountList | INT\\[] | 数组向量,存放多档买入委托笔数,档位由 *depth* 确定 |\n| asksPriceList | DOUBLE\\[] | 数组向量,存放多档卖出价格,档位由 *depth* 确定 |\n| asksQtyList | LONG\\[] | 数组向量,存放多档卖出数量,档位由 *depth* 确定 |\n| asksCountList | INT\\[] | 数组向量,存放多档卖出委托笔数,档位由 *depth* 确定 |\n\n**tradeDetail(成交明细)**\n\n| 基础衍生字段 | 类型 | 含义 |\n| ------------------------ | --------- | ------------------------------------- |\n| buyQty | LONG | 当前周期内的买入总量 = sum( BSFlag=1 的成交的量) |\n| sellQty | LONG | 当前周期内的卖出总量 = sum( BSFlag=2的成交的量) |\n| buyMoney | DOUBLE | 当前周期内的买入总金额 = sum( BSFlag=1的成交的量\\*价格) |\n| sellMoney | DOUBLE | 当前周期内的卖出总金额 = sum( BSFlag=2的成交的量\\*价格) |\n| tradePriceList | DOUBLE\\[] | 当前周期内成交价格列表 |\n| tradeQtyList | LONG\\[] | 当前周期内成交量列表 |\n| tradeTypeList | INT\\[] | 当前周期内成交类型列表 |\n| tradeBSFlagList | INT\\[] | 当前周期内成交方向列表 |\n| tradeMDTimeList | TIME\\[] | 当前周期内成交时间列表 |\n| tradeBuyNoList | LONG\\[] | 当前周期内买方委托序号列表 |\n| tradeSellNoList | LONG\\[] | 当前周期内卖方委托序号列表 |\n| tradeOrderBuyNoTimeList | TIME\\[] | 当前周期内的有效成交对应的委托的买单下单时间 |\n| tradeOrderSellNoTimeList | TIME\\[] | 当前周期内的有效成交对应的委托的卖单下单时间 |\n\n**orderDetail (委托明细)**\n\n| 基础衍生字段 | 类型 | 含义 |\n| --------------- | --------- | ----------- |\n| orderPriceList | DOUBLE\\[] | 当前周期内委托价格列表 |\n| orderQtyList | LONG\\[] | 当前周期内成交量列表 |\n| orderTypeList | INT\\[] | 当前周期内委托类型列表 |\n| orderBSFlagList | INT\\[] | 当前周期内委托方向列表 |\n| orderMDTimeList | TIME\\[] | 当前周期内委托时间列表 |\n| orderNoList | LONG\\[] | 当前周期内委托序号列表 |\n\n**withdrawDetail(撤单明细)**\n\n| 基础衍生字段 | 类型 | 含义 |\n| --------------------------- | --------- | ----------------------- |\n| withdrawBuyPriceList | DOUBLE\\[] | 当前周期内买方撤单的委托价格 |\n| withdrawBuyQtyList | LONG\\[] | 当前周期内买方撤单的委托量 |\n| withdrawBuyOrderTypeList | INT\\[] | 当前周期内买方撤单的委托的订单类型 |\n| withdrawBuyMDTimeList | TIME\\[] | 当前周期内买方撤单的订单时间 |\n| withdrawBuyOrderMDTimeList | TIME\\[] | 当前周期内买方撤单对应的委托下单时间 |\n| WithdrawBuyOrderQtyList | LONG\\[] | 当前周期内买方撤单对应的原始委托数据中的委托量 |\n| withdrawSellPriceList | DOUBLE\\[] | 当前周期内卖方撤单的委托价格 |\n| withdrawSellQtyList | LONG\\[] | 当前周期内卖方撤单的委托量 |\n| withdrawSellOrderTypeList | INT\\[] | 当前周期内卖方撤单的委托的订单类型 |\n| withdrawSellMDTimeList | TIME\\[] | 当前周期内卖方撤单的订单时间 |\n| withdrawSellOrderMDTimeList | TIME\\[] | 当前周期内卖方撤单对应的委托下单时间 |\n| WithdrawSellOrderQtyList | LONG\\[] | 当前周期内卖方撤单对应的原始委托数据中的委托量 |\n\n**prevDetail(上一笔交易明细)**\n\n| 基础衍生字段 | 类型 | 含义 |\n| ------------------------ | ------- | -------------------------------- |\n| prevBuyPrice1 | DOUBLE | 上一笔快照的 BuyPrice1 价格 |\n| prevSellPrice1 | DOUBLE | 上一笔快照的 SellPrice1 价格 |\n| prevBuyAddQtyList1 | LONG\\[] | 价格为上一笔快照的 BuyPrice1,在当前周期内的申购明细 |\n| prevSellAddQtyList1 | LONG\\[] | 价格为上一笔快照的 SellPrice1,在当前周期内的申购明细 |\n| prevBuyWithdrawQtyList1 | LONG\\[] | 价格为上一笔快照的 BuyPrice1,在当前周期内的撤单明细 |\n| prevSellWithdrawQtyList1 | LONG\\[] | 价格为上一笔快照的 SellPrice1,在当前周期内的撤单明细 |\n\n**orderBookDetailDepth( orderbook 明细档位)**\n\n每个档位输出一列,该列的类型是数组向量。比如 buyQtyList 有20个档位,则会输出20个 buyQtyList 字段:buyQtyList1、buyQtyList2、…、buyQtyList20。buyValueList,sellQtyList 和 sellValueList 同理。\n\n<table id=\"table_a2y_q2t_2bc\"><thead><tr><th>\n\n基础衍生字段\n\n</th><th>\n\n类型\n\n</th><th>\n\n含义\n\n</th></tr></thead><tbody><tr><td>\n\nbuyQtyList\n\n</td><td>\n\nLONG\\[](多个)\n\n</td><td>\n\n当前最新盘口各档位买入的每一笔委托的数量\n\n</td></tr><tr><td>\n\nbuyValueList\n\n</td><td>\n\nDOUBLE\\[](多个)\n\n</td><td>\n\n当前最新盘口各档位买入的每一笔委托的金额\n\n</td></tr><tr><td>\n\nsellQtyList\n\n</td><td>\n\nLONG\\[](多个)\n\n</td><td>\n\n前最新盘口各档位卖出的每一笔委托的数量\n\n</td></tr><tr><td>\n\nsellValueList\n\n</td><td>\n\nDOUBLE\\[](多个)\n\n</td><td>\n\n前最新盘口各档位卖出的每一笔委托的金额\n\n</td></tr></tbody>\n</table>**seqDetail(sequence 明细)**\n\n<table id=\"table_jyr_xmf_fcc\"><thead><tr><th>\n\n基础衍生字段\n\n</th><th>\n\n类型\n\n</th><th>\n\n含义\n\n</th></tr></thead><tbody><tr><td>\n\ntradeSeqList\n\n</td><td>\n\nLONG\\[]\n\n</td><td>\n\n当前周期内的成交序号列表\n\n</td></tr><tr><td>\n\norderSeqList\n\n</td><td>\n\nLONG\\[]\n\n</td><td>\n\n当前周期内的委托序号列表\n\n</td></tr><tr><td>\n\nwithdrawBuySeqList\n\n</td><td>\n\nLONG\\[]\n\n</td><td>\n\n当前周期内的买方撤单序号列表\n\n</td></tr><tr><td>\n\nwithdrawSellSeqList\n\n</td><td>\n\nLONG\\[]\n\n</td><td>\n\n当前周期内的卖方撤单序号列表\n\n</td></tr></tbody>\n</table>\n"
|
|
5066
5066
|
},
|
|
5067
5067
|
"createPartitionedTable": {
|
|
5068
5068
|
"url": "https://docs.dolphindb.cn/zh/funcs/c/createPartitionedTable.html",
|
|
@@ -7614,7 +7614,7 @@
|
|
|
7614
7614
|
]
|
|
7615
7615
|
}
|
|
7616
7616
|
],
|
|
7617
|
-
"markdown": "### [deltas](https://docs.dolphindb.cn/zh/funcs/d/deltas.html)\n\n\n\n#### 语法\n\ndeltas(X,\\[n])\n\n#### 参数\n\n**X**
|
|
7617
|
+
"markdown": "### [deltas](https://docs.dolphindb.cn/zh/funcs/d/deltas.html)\n\n\n\n#### 语法\n\ndeltas(X,\\[n])\n\n#### 参数\n\n**X** 是一个向量、矩阵或表。\n\n**n** 可选参数,一个整数,用于减数相较于被减数的索引偏移。默认是1。\n\n#### 详情\n\n对于 *X* 中的每一个元素,计算 *X*i-*X*i-n,NULL 值不参与计算。\n\n* 若 *X* 是向量,返回一个包含 *X* 中两个元素之差的向量。\n\n* 若 *X* 是矩阵,在每列内进行上述计算,返回一个与 *X* 维度相同的矩阵。\n\n* 若 *X* 是表,在每列内进行上述计算,返回一个与 *X* 行数与列数都相同的表。\n\n#### 例子\n\n```\nx=7 4 5 8 9;\ndeltas(x);\n//output: [,-3,1,3,1]\n//等价于 [, 4-7, 5-4, 8-5, 9-8]\n\nx=NULL 1 2 NULL 3;\ndeltas(x);\n//output: [,,1,,]\n\nm=matrix(1 3 2 5 6, 0 8 NULL 7 6);\nm;\n```\n\n| #0 | #1 |\n| -- | -- |\n| 1 | 0 |\n| 3 | 8 |\n| 2 | |\n| 5 | 7 |\n| 6 | 6 |\n\n```\ndeltas(m);\n```\n\n| #0 | #1 |\n| -- | -- |\n| | |\n| 2 | 8 |\n| -1 | |\n| 3 | |\n| 1 | -1 |\n\n*n* 是正整数时:\n\n```\ndeltas(m,2)\n```\n\n| 0 | 1 |\n| - | -- |\n| | |\n| | |\n| 1 | |\n| 2 | -1 |\n| 4 | |\n\n*n* 为负整数时:\n\n```\ndeltas(m,-2)\n```\n\n| 0 | 1 |\n| -- | - |\n| -1 | |\n| -2 | 1 |\n| -4 | |\n| | |\n| | |\n"
|
|
7618
7618
|
},
|
|
7619
7619
|
"dema": {
|
|
7620
7620
|
"url": "https://docs.dolphindb.cn/zh/funcs/d/dema.html",
|
|
@@ -10351,7 +10351,7 @@
|
|
|
10351
10351
|
]
|
|
10352
10352
|
}
|
|
10353
10353
|
],
|
|
10354
|
-
"markdown": "### [fminSLSQP](https://docs.dolphindb.cn/zh/funcs/f/fminslsqp.html)\n\n\n\n#### 语法\n\nfminSLSQP(func, X0, \\[fprime], \\[constraints], \\[bounds], \\[ftol=1e-6], \\[epsilon], \\[maxIter=100])\n\n#### 详情\n\n使用顺序最小二乘编程方法(Sequential Least Squares Programming, SLSQP)找到目标函数的最小值。\n\n#### 参数\n\n**func** 函数名,表示需要最小化的目标函数。注意:函数返回值须是数值标量类型。\n\n**X0** 数值类型的标量或向量,表示使目标函数最小化的参数的初始猜测。\n\n**fprime** 可选参数,函数名,表示计算 *func* 梯度的函数。如果为空,则使用数值微分方法来获取函数梯度。\n\n**constraints** 可选参数,字典向量,表示待优化参数需满足的约束条件,每个字典应包含下列成员:\n\n* type:字符串标量,表示约束类型。有两个可选值:'eq'
|
|
10354
|
+
"markdown": "### [fminSLSQP](https://docs.dolphindb.cn/zh/funcs/f/fminslsqp.html)\n\n\n\n#### 语法\n\nfminSLSQP(func, X0, \\[fprime], \\[constraints], \\[bounds], \\[ftol=1e-6], \\[epsilon], \\[maxIter=100])\n\n#### 详情\n\n使用顺序最小二乘编程方法(Sequential Least Squares Programming, SLSQP)找到目标函数的最小值。\n\n#### 参数\n\n**func** 函数名,表示需要最小化的目标函数。注意:函数返回值须是数值标量类型。\n\n**X0** 数值类型的标量或向量,表示使目标函数最小化的参数的初始猜测。\n\n**fprime** 可选参数,函数名,表示计算 *func* 梯度的函数。如果为空,则使用数值微分方法来获取函数梯度。\n\n**constraints** 可选参数,字典向量,表示待优化参数需满足的约束条件,每个字典应包含下列成员:\n\n* type:字符串标量,表示约束类型。有两个可选值:'eq'表示等式约束,'ineq'表示不等式约束。\n\n* fun:函数名,表示约束函数。\n\n* jac:函数名,表示约束函数 fun 的梯度函数。\n\n**bounds** 可选参数,数值矩阵,形状为(N,2),其中 N 为需要优化的参数数量,即 N=size(X0)。每一行的两个值(min, max),定义了对应参数的边界。\n\n**ftol** 可选参数,数值标量,正数,表示算法停止时对目标函数值的精度要求,默认值为 1e-6。\n\n**epsilon** 可选参数,数值标量,正数,表示当使用数值近似方法来求解函数梯度时使用的步长。默认值为 1.4901161193847656e-08。\n\n**maxIter** 可选参数,非负整数标量,表示最大迭代次数,默认值为 100。\n\n#### 返回值\n\n返回一个字典,字典有以下成员:\n\n* xopt:浮点数向量,使目标函数最小化的参数值。\n\n* fopt:浮点数标量,目标函数最小值。fopt=func(xopt)。\n\n* iterations:整数标量,优化过程中执行的总迭代数。\n\n* mode:整数标量,表示算法退出时的状态。mode=0 时表示成功进行优化,取其他值表示算法异常退出。\n\n#### 例子\n\n本例自定义条件,传入参数 *f*, *X0*, *fargs*, *fprime*, *constraints*, *bounds*,使用 SLSQP 算法找到目标函数 `rosen` 的最小值。\n\n```\ndef rosen(x) { \n\tN = size(x);\n\treturn sum(100.0*power(x[1:N]-power(x[0:(N-1)], 2.0), 2.0)+power(1-x[0:(N-1)], 2.0));\n}\n\ndef rosen_der(x) {\n\tN = size(x);\n\txm = x[1:(N-1)]\n\txm_m1 = x[0:(N-2)]\n\txm_p1 = x[2:N]\n\tder = array(double, N)\n\tder[1:(N-1)] = (200 * (xm - xm_m1*xm_m1) - 400 * (xm_p1 - xm*xm) * xm - 2 * (1 - xm))\n\tder[0] = -400 * x[0] * (x[1] - x[0]*x[0]) - 2 * (1 - x[0])\n\tder[N-1] = 200 * (x[N-1] - x[N-2]*x[N-2])\n\treturn der\n}\n\ndef eq_fun(x) {\n\treturn 2*x[0] + x[1] - 1\n}\n\ndef eq_jac(x) {\n\treturn [2.0, 1.0]\n}\n\ndef ieq_fun(x) {\n\treturn [1 - x[0] - 2*x[1], 1 - x[0]*x[0] - x[1], 1 - x[0]*x[0] + x[1]]\n}\n\ndef ieq_jac(x) {\n\tret = matrix(DOUBLE, 2, 3)\n\tret[0,:] = [-1.0, -2*x[0], -2*x[0]]\n\tret[1,:] = [-2.0, -1.0, 1.0]\n\treturn ret\n}\n\neqCons=dict(STRING, ANY)\neqCons[`type]=`eq\neqCons[`fun]=eq_fun\neqCons[`jac]=eq_jac\n\nineqCons=dict(STRING, ANY)\nineqCons[`type]=`ineq\nineqCons[`fun]=ieq_fun\nineqCons[`jac]=ieq_jac\n\ncons = [eqCons, ineqCons]\n\nX0 = [0.5, 0]\nbounds = matrix([0 -0.5, 1.0 2.0])\nres = fminSLSQP(rosen, X0, rosen_der, cons, bounds, 1e-9)\nres;\n/* Ouput:\nmode->0\nxopt->[0.414944749170,0.170110501659]\nfopt->0.342717574994\niterations->4\n*/\n```\n"
|
|
10355
10355
|
},
|
|
10356
10356
|
"form": {
|
|
10357
10357
|
"url": "https://docs.dolphindb.cn/zh/funcs/f/form.html",
|
|
@@ -14503,46 +14503,6 @@
|
|
|
14503
14503
|
],
|
|
14504
14504
|
"markdown": "### [withNullFill](https://docs.dolphindb.cn/zh/funcs/ho_funcs/withNullFill.html)\n\n#### 语法\n\nwithNullFill(func, x, y, fillValue)\n\n#### 详情\n\n* 如果 x 与 y 中相同位置的元素只有一个为NULL,使用 fillValue 替换 NULL 值参与计算。\n* 如果 x 和 y 相同位置的元素均为 NULL,返回 NULL。\n\n#### 参数\n\n* **func** 是一个DolphinDB内置函数,须为双目运算符,例如+, -, \\*, /, , %, pow, and, or 等。\n* **x** 与 **y** 是向量或矩阵。\n* **fillValue** 是一个标量。\n\n#### 例子\n\n```\nx = 0 1 NULL NULL 2\ny = 1 NULL 2 NULL 3;\nadd(x,y);\n// output\n[1,,,,5]\n\nwithNullFill(add, x, y, 0);\n// output\n[1,1,2,,5]\n\nm=matrix(1..5, y);\nm;\n```\n\n| col1 | col2 |\n| ---- | ---- |\n| 1 | 1 |\n| 2 | |\n| 3 | 2 |\n| 4 | |\n| 5 | 3 |\n\n```\nadd(x, m);\n```\n\n| col1 | col2 |\n| ---- | ---- |\n| 1 | 1 |\n| 3 | |\n| | |\n| | |\n| 7 | 5 |\n\n```\nwithNullFill(add, x, m, 0);\n```\n\n| col1 | col2 |\n| ---- | ---- |\n| 1 | 1 |\n| 3 | 1 |\n| 3 | 2 |\n| 4 | |\n| 7 | 5 |\n\n"
|
|
14505
14505
|
},
|
|
14506
|
-
"join!": {
|
|
14507
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/j/join!.html",
|
|
14508
|
-
"signatures": [
|
|
14509
|
-
{
|
|
14510
|
-
"full": "join!(X, Y)",
|
|
14511
|
-
"name": "join!",
|
|
14512
|
-
"parameters": [
|
|
14513
|
-
{
|
|
14514
|
-
"full": "X",
|
|
14515
|
-
"name": "X"
|
|
14516
|
-
},
|
|
14517
|
-
{
|
|
14518
|
-
"full": "Y",
|
|
14519
|
-
"name": "Y"
|
|
14520
|
-
}
|
|
14521
|
-
]
|
|
14522
|
-
}
|
|
14523
|
-
],
|
|
14524
|
-
"markdown": "### [join!](https://docs.dolphindb.cn/zh/funcs/j/join!.html)\n\n\n\n#### 语法\n\njoin!(X, Y)\n\n#### 参数\n\n**X** 可以是向量、元组、矩阵或表。\n\n**Y** 可以是标量、向量、元组、矩阵或表。\n\n如果 *X* 是向量或元组,*Y* 可以是标量、向量或元组。如果 *X* 是矩阵,*Y* 可以是向量或矩阵。如果 *X* 是表,*Y* 可以是向量或表。\n\n#### 详情\n\n把 *Y* 合并到 *X* 中,`join!` 函数会改变 *X* 的值。\n\n#### 例子\n\n如果 *X* 是向量,*Y* 可以是标量、向量或数据类型与 X 相同的元组。返回结果是长度更长的向量。\n\n```\nx=[1,2,3]\nx.join!(4)\nx;\n```\n\n输出返回:\\[1,2,3,4]\n\n```\nx.join!(5 6 7)\nx;\n```\n\n输出返回:\\[1,2,3,4,5,6,7]\n\n```\nx.join!((8,9))\nx;\n```\n\n输出返回:\\[1,2,3,4,5,6,7,8,9]\n\n如果 *X* 是元组,*Y* 可以是标量、向量或元组。返回结果是长度更长的元组。\n\n```\nx = (1,\"A\")\nx.join!(2)\nx;\n```\n\n返回:(1,\"A\",2)\n\n```\nx.join!([3,4,5])\nx;\n```\n\n返回:(1,\"A\",2,\\[3,4,5])\n\n如果配置项 appendTupleAsAWhole 设置为 true,运行以下脚本:\n\n```\nx.join!((\"B\",\"C\")) // 配置参数 appendTupleAsAWhole=true 时\nx;\n```\n\n返回:(1,\"A\",2,\\[3,4,5],(\"B\",\"C\"))\n\n如果配置项 appendTupleAsAWhole 设置为 false,运行以上脚本后,返回:(1,\"A\",2,\\[3,4,5],\"B\",\"C\")\n\n如果 *X* 是矩阵,*Y* 可以是向量或者是与 *X* 行数相同的矩阵。返回结果是与 *X* 行数相同的矩阵。\n\n```\nx=1..6$2:3\njoin!(x, [7,8])\nx;\n```\n\n输出返回:\n\n| #0 | #1 | #2 | #3 |\n| -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 |\n| 2 | 4 | 6 | 8 |\n\n```\nx.join!(9..12$2:2)\nx;\n```\n\n输出返回:\n\n| #0 | #1 | #2 | #3 | #4 | #5 |\n| -- | -- | -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 | 9 | 11 |\n| 2 | 4 | 6 | 8 | 10 | 12 |\n\n如果 *X* 是表,*Y* 必须是和 *X* 行数相同的表或向量。返回结果是与 *X* 行数相同的表。\n\n```\na=table(1..3 as x, 4.5 6.7 8.5 as y);\na;\n```\n\n输出返回:\n\n| x | y |\n| - | --- |\n| 1 | 4.5 |\n| 2 | 6.7 |\n| 3 | 8.5 |\n\n```\nb=table(700 500 800 as z);\nb;\n```\n\n输出返回:\n\n| z |\n| --- |\n| 700 |\n| 500 |\n| 800 |\n\n```\njoin!(a,b);\na;\n```\n\n输出返回:\n\n| x | y | z |\n| - | --- | --- |\n| 1 | 4.5 | 700 |\n| 2 | 6.7 | 500 |\n| 3 | 8.5 | 800 |\n\n```\na=table(1..3 as x, `IBM`C`AAPL as y);\nb=table(172.3 25 106.5 as z);\na.join!(b);\na;\n```\n\n输出返回:\n\n| x | y | z |\n| - | ---- | ----- |\n| 1 | IBM | 172.3 |\n| 2 | C | 25 |\n| 3 | AAPL | 106.5 |\n"
|
|
14525
|
-
},
|
|
14526
|
-
"join": {
|
|
14527
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/j/join.html",
|
|
14528
|
-
"signatures": [
|
|
14529
|
-
{
|
|
14530
|
-
"full": "join(X,Y)",
|
|
14531
|
-
"name": "join",
|
|
14532
|
-
"parameters": [
|
|
14533
|
-
{
|
|
14534
|
-
"full": "X",
|
|
14535
|
-
"name": "X"
|
|
14536
|
-
},
|
|
14537
|
-
{
|
|
14538
|
-
"full": "Y",
|
|
14539
|
-
"name": "Y"
|
|
14540
|
-
}
|
|
14541
|
-
]
|
|
14542
|
-
}
|
|
14543
|
-
],
|
|
14544
|
-
"markdown": "### [join](https://docs.dolphindb.cn/zh/funcs/j/join.html)\n\n\n\n#### 语法\n\njoin(X,Y) 或 X<-Y\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、向量、元组、矩阵或表。\n\n#### 详情\n\n合并 *X* 和 *Y*。\n\n#### 例子\n\n如果 *X* 是标量,*Y* 可以是标量或向量,结果是一个向量;*Y* 可以是元组,结果是一个元组\n\n```\n1 <- 3;\n// output\n[1,3]\n\n4<-1 2 3;\n// output\n[4,1,2,3]\n\n1 <- (2,\"A\")\n// 配置参数 appendTupleAsAWhole=true 时\n// output\n(1,(2,\"A\"))\n// 配置参数 appendTupleAsAWhole=false 时\n// output\n(1,2,\"A\")\n```\n\n如果 *X* 是向量,*Y* 可以是标量、向量或元素类型与 X 相同的元组。它将产生一个更长的向量。\n\n```\n[1,2,3] <- 4;\n// output\n[1,2,3,4]\n\n[1,2,3] <- [4,5,6];\n// output\n[1,2,3,4,5,6]\n```\n\n如果 X 是元组,Y可以是标量、向量或元组。它将产生一个更长的元组。\n\n```\nx = (1,\"A\")\ny = 2\nx <- y\n(1,\"A\",2)\n\ny = [2,3]\n(1,\"A\",[2,3])\n\ny = (2,\"B\")\n// 配置参数 appendTupleAsAWhole=true 时\n// output\n(1,\"A\",(2,\"B\"))\n// 配置参数 appendTupleAsAWhole=false 时\n// output\n(1,\"A\",2,\"B\")\n```\n\n如果 *X* 是矩阵,*Y* 必须是和 *X* 具有相同行数的向量或矩阵。结果是一个和 *X* 具有相同行数的矩阵。\n\n```\n1..6$2:3 <- [7,8];\n```\n\n| #0 | #1 | #2 | #3 |\n| -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 |\n| 2 | 4 | 6 | 8 |\n\n```\n(1..6$2:3) <- (7..12$2:3);\n```\n\n| #0 | #1 | #2 | #3 | #4 | #5 |\n| -- | -- | -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 | 9 | 11 |\n| 2 | 4 | 6 | 8 | 10 | 12 |\n\n如果 *X* 是一个表,*Y* 必须是一个和 *X* 具有相同行数的向量或表。结果是一个和 *X* 具有相同行数的表。\n\n```\na=table(1..3 as x, 4.5 6.7 8.5 as y);\na;\n```\n\n| x | y |\n| - | --- |\n| 1 | 4.5 |\n| 2 | 6.7 |\n| 3 | 8.5 |\n\n```\nb=table(700 500 800 as z);\nb\n```\n\n| z |\n| --- |\n| 700 |\n| 500 |\n| 800 |\n\n```\nc=join(a,b);\nc;\n```\n\n| x | y | z |\n| - | --- | --- |\n| 1 | 4.5 | 700 |\n| 2 | 6.7 | 500 |\n| 3 | 8.5 | 800 |\n\n```\na=table(1..3 as x, `IBM`C`AAPL as y);\nb=table(172.3 25 106.5 as z);\nc=a<-b;\nc\n```\n\n| x | y | z |\n| - | ---- | ----- |\n| 1 | IBM | 172.3 |\n| 2 | C | 25 |\n| 3 | AAPL | 106.5 |\n\n相关函数:[cj (cross\\_join)](https://docs.dolphindb.cn/zh/funcs/c/cj.html)\n"
|
|
14545
|
-
},
|
|
14546
14506
|
"ifirstHit": {
|
|
14547
14507
|
"url": "https://docs.dolphindb.cn/zh/funcs/i/ifirstHit.html",
|
|
14548
14508
|
"signatures": [
|
|
@@ -16101,6 +16061,46 @@
|
|
|
16101
16061
|
],
|
|
16102
16062
|
"markdown": "### [iterate](https://docs.dolphindb.cn/zh/funcs/i/iterate.html)\n\n\n\n#### 语法\n\niterate(init, coeffs, input)\n\n#### 参数\n\n**init** 是初始值。\n\n**coeffs** 是迭代系数。*init* 和 *coeffs* 的长度必须相同。\n\n**input** 是整型标量,或者是向量。如果 *input* 是整型标量,表示迭代的次数;如果 *input* 是向量,其长度表示迭代的次数,每个元素在每次迭代后都添加到结果中。\n\n#### 详情\n\n* 若 *init*、*coeffs* 与 *input* 均为标量,返回等比数列\\[ *init* \\* *coeffs* , *init* \\* *coeffs* 2, *init* \\* *coeffs*3, ...],其长度为 *input*。\n\n* 若 *init*、*coeffs* 为标量,*input* 为向量,返回数列x,满足以下条件:x\\[0]= *init* \\* *coeffs* + *input* \\[0],x\\[n]=x\\[n-1]\\* *coeffs* + *input* \\[n]。数列x的长度为 *input* 的长度。\n\n* 若 *init*、*coeffs* 为向量,*input* 为标量,返回数列x,满足以下条件:x\\[n]=y(n)\\*\\* *coeffs* , y(n)=y(n-1)\\[1:].append!(x\\[n-1]), y(0)= *init*, x的长度为 *input* 。其中\\*\\*表示点乘,返回两个向量的内积。\n\n* 若 *init*、*coeffs* 与 *input* 均为向量,返回数列x,满足以下条件:x\\[n]=y(n)\\*\\* *coeffs* + *input* \\[n], y(n)=y(n-1)\\[1:].append!(x\\[n-1]), y(0)= *init*。其中\\*\\*表示点乘,返回两个向量的内积。\n\n#### 例子\n\n```\niterate(1, 0.8, 3);\n// output\n[0.8,0.64,0.512]\n// 1*0.8=0.8, 0.8*0.8=0.64, 0.64*0.8=0.512\n\niterate(1, 0.8, 0.1 0.2 0.3);\n// output\n[0.9,0.92,1.036]\n// 1*0.8+0.1=0.9, 0.9*0.8+0.2=0.92, 0.92*0.8+0.3=1.036\n\niterate(1 1, 1 1, 10);\n// output\n[2,3,5,8,13,21,34,55,89,144]\n// 斐波那契数列: 1*1+1*1=2; 1*1+2*1=3; 2*1+3*1=5; 3*1+5*1=8; ... ; 55*1+89*1=144.\n\niterate(1 1, 1 1, 1 2 3 4 5);\n// output\n[3,6,12,22,39]\n// 1*1+1*1+1=3; 1*1+3*1+2=6; 3*1+6*1+3=12; 6*1+12*1+4=22; 12*1+22*1+5=39.\n```\n"
|
|
16103
16063
|
},
|
|
16064
|
+
"join!": {
|
|
16065
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/j/join!.html",
|
|
16066
|
+
"signatures": [
|
|
16067
|
+
{
|
|
16068
|
+
"full": "join!(X, Y)",
|
|
16069
|
+
"name": "join!",
|
|
16070
|
+
"parameters": [
|
|
16071
|
+
{
|
|
16072
|
+
"full": "X",
|
|
16073
|
+
"name": "X"
|
|
16074
|
+
},
|
|
16075
|
+
{
|
|
16076
|
+
"full": "Y",
|
|
16077
|
+
"name": "Y"
|
|
16078
|
+
}
|
|
16079
|
+
]
|
|
16080
|
+
}
|
|
16081
|
+
],
|
|
16082
|
+
"markdown": "### [join!](https://docs.dolphindb.cn/zh/funcs/j/join!.html)\n\n\n\n#### 语法\n\njoin!(X, Y)\n\n#### 参数\n\n**X** 可以是向量、元组、矩阵或表。\n\n**Y** 可以是标量、向量、元组、矩阵或表。\n\n如果 *X* 是向量或元组,*Y* 可以是标量、向量或元组。如果 *X* 是矩阵,*Y* 可以是向量或矩阵。如果 *X* 是表,*Y* 可以是向量或表。\n\n#### 详情\n\n把 *Y* 合并到 *X* 中,`join!` 函数会改变 *X* 的值。\n\n#### 例子\n\n如果 *X* 是向量,*Y* 可以是标量、向量或数据类型与 X 相同的元组。返回结果是长度更长的向量。\n\n```\nx=[1,2,3]\nx.join!(4)\nx;\n```\n\n输出返回:\\[1,2,3,4]\n\n```\nx.join!(5 6 7)\nx;\n```\n\n输出返回:\\[1,2,3,4,5,6,7]\n\n```\nx.join!((8,9))\nx;\n```\n\n输出返回:\\[1,2,3,4,5,6,7,8,9]\n\n如果 *X* 是元组,*Y* 可以是标量、向量或元组。返回结果是长度更长的元组。\n\n```\nx = (1,\"A\")\nx.join!(2)\nx;\n```\n\n返回:(1,\"A\",2)\n\n```\nx.join!([3,4,5])\nx;\n```\n\n返回:(1,\"A\",2,\\[3,4,5])\n\n如果配置项 appendTupleAsAWhole 设置为 true,运行以下脚本:\n\n```\nx.join!((\"B\",\"C\")) // 配置参数 appendTupleAsAWhole=true 时\nx;\n```\n\n返回:(1,\"A\",2,\\[3,4,5],(\"B\",\"C\"))\n\n如果配置项 appendTupleAsAWhole 设置为 false,运行以上脚本后,返回:(1,\"A\",2,\\[3,4,5],\"B\",\"C\")\n\n如果 *X* 是矩阵,*Y* 可以是向量或者是与 *X* 行数相同的矩阵。返回结果是与 *X* 行数相同的矩阵。\n\n```\nx=1..6$2:3\njoin!(x, [7,8])\nx;\n```\n\n输出返回:\n\n| #0 | #1 | #2 | #3 |\n| -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 |\n| 2 | 4 | 6 | 8 |\n\n```\nx.join!(9..12$2:2)\nx;\n```\n\n输出返回:\n\n| #0 | #1 | #2 | #3 | #4 | #5 |\n| -- | -- | -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 | 9 | 11 |\n| 2 | 4 | 6 | 8 | 10 | 12 |\n\n如果 *X* 是表,*Y* 必须是和 *X* 行数相同的表或向量。返回结果是与 *X* 行数相同的表。\n\n```\na=table(1..3 as x, 4.5 6.7 8.5 as y);\na;\n```\n\n输出返回:\n\n| x | y |\n| - | --- |\n| 1 | 4.5 |\n| 2 | 6.7 |\n| 3 | 8.5 |\n\n```\nb=table(700 500 800 as z);\nb;\n```\n\n输出返回:\n\n| z |\n| --- |\n| 700 |\n| 500 |\n| 800 |\n\n```\njoin!(a,b);\na;\n```\n\n输出返回:\n\n| x | y | z |\n| - | --- | --- |\n| 1 | 4.5 | 700 |\n| 2 | 6.7 | 500 |\n| 3 | 8.5 | 800 |\n\n```\na=table(1..3 as x, `IBM`C`AAPL as y);\nb=table(172.3 25 106.5 as z);\na.join!(b);\na;\n```\n\n输出返回:\n\n| x | y | z |\n| - | ---- | ----- |\n| 1 | IBM | 172.3 |\n| 2 | C | 25 |\n| 3 | AAPL | 106.5 |\n"
|
|
16083
|
+
},
|
|
16084
|
+
"join": {
|
|
16085
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/j/join.html",
|
|
16086
|
+
"signatures": [
|
|
16087
|
+
{
|
|
16088
|
+
"full": "join(X,Y)",
|
|
16089
|
+
"name": "join",
|
|
16090
|
+
"parameters": [
|
|
16091
|
+
{
|
|
16092
|
+
"full": "X",
|
|
16093
|
+
"name": "X"
|
|
16094
|
+
},
|
|
16095
|
+
{
|
|
16096
|
+
"full": "Y",
|
|
16097
|
+
"name": "Y"
|
|
16098
|
+
}
|
|
16099
|
+
]
|
|
16100
|
+
}
|
|
16101
|
+
],
|
|
16102
|
+
"markdown": "### [join](https://docs.dolphindb.cn/zh/funcs/j/join.html)\n\n\n\n#### 语法\n\njoin(X,Y) 或 X<-Y\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、向量、元组、矩阵或表。\n\n#### 详情\n\n合并 *X* 和 *Y*。\n\n#### 例子\n\n如果 *X* 是标量,*Y* 可以是标量或向量,结果是一个向量;*Y* 可以是元组,结果是一个元组\n\n```\n1 <- 3;\n// output\n[1,3]\n\n4<-1 2 3;\n// output\n[4,1,2,3]\n\n1 <- (2,\"A\")\n// 配置参数 appendTupleAsAWhole=true 时\n// output\n(1,(2,\"A\"))\n// 配置参数 appendTupleAsAWhole=false 时\n// output\n(1,2,\"A\")\n```\n\n如果 *X* 是向量,*Y* 可以是标量、向量或元素类型与 X 相同的元组。它将产生一个更长的向量。\n\n```\n[1,2,3] <- 4;\n// output\n[1,2,3,4]\n\n[1,2,3] <- [4,5,6];\n// output\n[1,2,3,4,5,6]\n```\n\n如果 X 是元组,Y可以是标量、向量或元组。它将产生一个更长的元组。\n\n```\nx = (1,\"A\")\ny = 2\nx <- y\n(1,\"A\",2)\n\ny = [2,3]\n(1,\"A\",[2,3])\n\ny = (2,\"B\")\n// 配置参数 appendTupleAsAWhole=true 时\n// output\n(1,\"A\",(2,\"B\"))\n// 配置参数 appendTupleAsAWhole=false 时\n// output\n(1,\"A\",2,\"B\")\n```\n\n如果 *X* 是矩阵,*Y* 必须是和 *X* 具有相同行数的向量或矩阵。结果是一个和 *X* 具有相同行数的矩阵。\n\n```\n1..6$2:3 <- [7,8];\n```\n\n| #0 | #1 | #2 | #3 |\n| -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 |\n| 2 | 4 | 6 | 8 |\n\n```\n(1..6$2:3) <- (7..12$2:3);\n```\n\n| #0 | #1 | #2 | #3 | #4 | #5 |\n| -- | -- | -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 | 9 | 11 |\n| 2 | 4 | 6 | 8 | 10 | 12 |\n\n如果 *X* 是一个表,*Y* 必须是一个和 *X* 具有相同行数的向量或表。结果是一个和 *X* 具有相同行数的表。\n\n```\na=table(1..3 as x, 4.5 6.7 8.5 as y);\na;\n```\n\n| x | y |\n| - | --- |\n| 1 | 4.5 |\n| 2 | 6.7 |\n| 3 | 8.5 |\n\n```\nb=table(700 500 800 as z);\nb\n```\n\n| z |\n| --- |\n| 700 |\n| 500 |\n| 800 |\n\n```\nc=join(a,b);\nc;\n```\n\n| x | y | z |\n| - | --- | --- |\n| 1 | 4.5 | 700 |\n| 2 | 6.7 | 500 |\n| 3 | 8.5 | 800 |\n\n```\na=table(1..3 as x, `IBM`C`AAPL as y);\nb=table(172.3 25 106.5 as z);\nc=a<-b;\nc\n```\n\n| x | y | z |\n| - | ---- | ----- |\n| 1 | IBM | 172.3 |\n| 2 | C | 25 |\n| 3 | AAPL | 106.5 |\n\n相关函数:[cj (cross\\_join)](https://docs.dolphindb.cn/zh/funcs/c/cj.html)\n"
|
|
16103
|
+
},
|
|
16104
16104
|
"kama": {
|
|
16105
16105
|
"url": "https://docs.dolphindb.cn/zh/funcs/k/kama.html",
|
|
16106
16106
|
"signatures": [
|
|
@@ -17292,7 +17292,7 @@
|
|
|
17292
17292
|
]
|
|
17293
17293
|
}
|
|
17294
17294
|
],
|
|
17295
|
-
"markdown": "### [loadPlugin](https://docs.dolphindb.cn/zh/funcs/l/loadPlugin.html)\n\n#### 语法\n\nloadPlugin(filepath)\n\n#### 参数\n\n**filepath** 是文本文件的绝对路径。例如:`/home/DolphinDB_Linux64_V2.00.10/server/plugins/mysql/PluginMySQL.txt`。\n\n自2.00.11版本起,可以将其指定为插件名(大小写敏感)。系统会根据插件名称和配置项 *pluginDir* 拼接出插件的加载路径。\n\n#### 详情\n\n加载 DolphinDB 插件。该函数必须要用户登录后才能执行。\n\n**Note:**\n\n* 在产品体验阶段,如果未自行创建用户或管理员账号,可以使用 DolphinDB 提供的初始管理员账号(admin)及密码(123456)。在生产环境中,务必使用具备中等以上安全强度的用户或管理员密码。\n\n
|
|
17295
|
+
"markdown": "### [loadPlugin](https://docs.dolphindb.cn/zh/funcs/l/loadPlugin.html)\n\n#### 语法\n\nloadPlugin(filepath)\n\n#### 参数\n\n**filepath** 是文本文件的绝对路径。例如:`/home/DolphinDB_Linux64_V2.00.10/server/plugins/mysql/PluginMySQL.txt`。\n\n自2.00.11版本起,可以将其指定为插件名(大小写敏感)。系统会根据插件名称和配置项 *pluginDir* 拼接出插件的加载路径。\n\n#### 详情\n\n加载 DolphinDB 插件。该函数必须要用户登录后才能执行。\n\n**Note:**\n\n* 在产品体验阶段,如果未自行创建用户或管理员账号,可以使用 DolphinDB 提供的初始管理员账号(admin)及密码(123456)。在生产环境中,务必使用具备中等以上安全强度的用户或管理员密码。\n\n来自 DolphinDB 插件市场的插件在使用 [installPlugin](https://docs.dolphindb.cn/zh/funcs/i/installPlugin.html) 命令安装后,会在`<server路径>/plugins/<插件名称>`路径下生成一个命名方式为 \"Plugin\" + \"插件名称\"的 txt 格式的插件描述文件和相关的二进制文件(Windows 版本下为 .dll,Linux 版本下为 .so)。例如,安装在 Windows 版本 DolphinDB server 2.00.10 的 odbc 插件描述文件存储于:\n\n```\n../DolphinDB_Win64_V2.00.10/server/plugins/odbc/PluginODBC.txt\n```\n\n该文件包含以下内容:\n\n```\nodbc,libPluginODBC.dll,2.00.10\nodbcQuery,query,system,2,5,0\nodbcConnect,connect,system,1,2,0\nodbcClose,close,system,1,1,0\nodbcExecute,execute,system,2,2,0\nodbcAppend,append,system,3,5,0\n```\n\n该文件格式如下:\n\n* 第一行:插件名称、lib 文件、版本号,用 “,” 分隔;\n* 其他行用于描述该插件提供的函数,依次包含以下信息:lib 文件中的某个函数的名称、对应的 DolphinDB 函数的名称、函数的类型(operator 表示运算符,system 表示系统函数)、函数所需的最小参数个数、函数所需的最大参数个数、是否为聚合函数(1 表示聚合函数,0 表示非聚合函数)、是否为序列函数(1表示序列函数,0表示非序列函数)。\n\n#### 例子\n\n**加载来自插件市场的插件**\n\n以在 Windows 操作系统上安装 MQTT 插件为例,加载方法有两种:\n\n* 使用插件描述文件的绝对路径加载插件:\n\n ```\n installPlugin(\"mqtt\") \n loadPlugin(\"D:/TEST/DolphinDB_Win64_V2.00.10/server/plugins/mqtt/PluginMQTT.txt\")\n ```\n\n **Note:** 在 Windows 操作系统中使用绝对路径加载插件时,务必确保路径中使用\"/\"代替\"\\\\\"。\n\n* 或指定插件名称:\n\n ```\n installPlugin(\"mqtt\") \n loadPlugin(\"mqtt\")\n ```\n\n**加载自行编译的插件**\n\n以 DolphinDB Linux 版本的 odbc 插件为例,其描述文件 odbc.txt 内容如下:\n\n```\nodbc,libPluginODBC.so,2.00.10\nodbcQuery,query,system,2,5,0\nodbcConnect,connect,system,1,2,0\nodbcClose,close,system,1,1,0\nodbcExecute,execute,system,2,2,0\nodbcAppend,append,system,3,5,0\n\n```\n\nodbc 插件提供了 5 个函数:`query`, `connect`, `close`, `execute` 和 `append`,需要加载插件后才能使用。下面的例子介绍了如何加载 odbc 插件,并调用 odbc 插件提供的函数。\n\n```\nloadPlugin(\"/home/DolphinDB/server/plugins/odbc/odbc.txt\")\n//或者通过插件名进行加载\nloadPlugin(\"odbc\")\nuse odbc\nConnStr=\"Driver=MySQL;Data Source=odbc_test;Server=127.0.0.1;Uid=root;Pwd=123456;Database=odbc_test\"\nconn=connect(connStr) // 创建 MySQL 连接\n\nt=query(conn,\"select * from test\")\nclose(conn)\n```\n\n\n\n**Related information**\n\n[installPlugin](https://docs.dolphindb.cn/zh/funcs/i/installPlugin.html)\n\n[listRemotePlugins](https://docs.dolphindb.cn/zh/funcs/l/listRemotePlugins.html)\n"
|
|
17296
17296
|
},
|
|
17297
17297
|
"loadRecord": {
|
|
17298
17298
|
"url": "https://docs.dolphindb.cn/zh/funcs/l/loadRecord.html",
|
|
@@ -19256,7 +19256,7 @@
|
|
|
19256
19256
|
]
|
|
19257
19257
|
}
|
|
19258
19258
|
],
|
|
19259
|
-
"markdown": "### [mLowRange](https://docs.dolphindb.cn/zh/funcs/m/mlowrange.html)\n\n#### 语法\n\nmLowRange(X, window, \\[minPeriods])\n\n参数说明和窗口计算规则请参考:[mFunctions](https://docs.dolphindb.cn/zh/funcs/themes/mFunctions.html)\n\n#### 详情\n\n在给定长度(以元素个数或时间长度衡量)的滑动窗口内,统计每个元素 Xi 左侧相邻且连续大于它的元素个数。NULL 被视为最小值。\n\n若 *X* 是矩阵,在每列内进行上述计算。\n\n#### 例子\n\n```\nx = [NULL, 3.1, NULL, 3.0, 2.9, 2.8, 3.1, NULL, 3.2]\nmLowRange(x, window=3) \n// output: [,,1,0,1,2,0,2,0]\n\nmLowRange(x, window=3, minPeriods=1) \n// output: [,0,1,0,1,2,0,2,0]\n\nmLowRange(x, window=3, minPeriods=2) \n// output: [,,,0,1,2,0,2,0]\n\ndate = [0, 1, 2, 3, 7, 8, 9, 10, 11] + 2020.01.01\nX = indexedSeries(date, x)\nmLowRange(X, 3d)\n```\n\n| | #0 |\n| ---------- | -- |\n| 2020.01.01 | |\n| 2020.01.02 | 0 |\n| 2020.01.03 | 1 |\n| 2020.01.04 | 0 |\n| 2020.01.08 | 0 |\n| 2020.01.09 | 1 |\n| 2020.01.10 | 0 |\n| 2020.01.11 | 2 |\n| 2020.01.12 | 0 |\n\n```\nm = matrix(1 2 3 NULL, 1 2 NULL 3, 1 3 NULL NULL, 1 2 3 4)\nmLowRange(m, 2)\n```\n\n| #0 | #1 | #2 | #3 |\n| -- | -- | -- | -- |\n| | | | |\n| 0 | 0 | 0 | 0 |\n| 0 | 1 | 1 | 0 |\n| 1 | 0 | | 0 |\n\n
|
|
19259
|
+
"markdown": "### [mLowRange](https://docs.dolphindb.cn/zh/funcs/m/mlowrange.html)\n\n#### 语法\n\nmLowRange(X, window, \\[minPeriods])\n\n参数说明和窗口计算规则请参考:[mFunctions](https://docs.dolphindb.cn/zh/funcs/themes/mFunctions.html)\n\n#### 详情\n\n在给定长度(以元素个数或时间长度衡量)的滑动窗口内,统计每个元素 Xi 左侧相邻且连续大于它的元素个数。NULL 被视为最小值。\n\n若 *X* 是矩阵,在每列内进行上述计算。\n\n#### 例子\n\n```\nx = [NULL, 3.1, NULL, 3.0, 2.9, 2.8, 3.1, NULL, 3.2]\nmLowRange(x, window=3) \n// output: [,,1,0,1,2,0,2,0]\n\nmLowRange(x, window=3, minPeriods=1) \n// output: [,0,1,0,1,2,0,2,0]\n\nmLowRange(x, window=3, minPeriods=2) \n// output: [,,,0,1,2,0,2,0]\n\ndate = [0, 1, 2, 3, 7, 8, 9, 10, 11] + 2020.01.01\nX = indexedSeries(date, x)\nmLowRange(X, 3d)\n```\n\n| | #0 |\n| ---------- | -- |\n| 2020.01.01 | |\n| 2020.01.02 | 0 |\n| 2020.01.03 | 1 |\n| 2020.01.04 | 0 |\n| 2020.01.08 | 0 |\n| 2020.01.09 | 1 |\n| 2020.01.10 | 0 |\n| 2020.01.11 | 2 |\n| 2020.01.12 | 0 |\n\n```\nm = matrix(1 2 3 NULL, 1 2 NULL 3, 1 3 NULL NULL, 1 2 3 4)\nmLowRange(m, 2)\n```\n\n| #0 | #1 | #2 | #3 |\n| -- | -- | -- | -- |\n| | | | |\n| 0 | 0 | 0 | 0 |\n| 0 | 1 | 1 | 0 |\n| 1 | 0 | | 0 |\n\n"
|
|
19260
19260
|
},
|
|
19261
19261
|
"mmad": {
|
|
19262
19262
|
"url": "https://docs.dolphindb.cn/zh/funcs/m/mmad.html",
|
|
@@ -20260,7 +20260,7 @@
|
|
|
20260
20260
|
]
|
|
20261
20261
|
}
|
|
20262
20262
|
],
|
|
20263
|
-
"markdown": "### [mTopRange](https://docs.dolphindb.cn/zh/funcs/m/mtoprange.html)\n\n#### 语法\n\nmTopRange(X, window, \\[minPeriods])\n\n参数说明和窗口计算规则请参考:[mFunctions](https://docs.dolphindb.cn/zh/funcs/themes/mFunctions.html)\n\n#### 详情\n\n在给定长度(以元素个数或时间长度衡量)的滑动窗口内,统计每个元素 Xi 左侧相邻且连续小于它的元素个数。NULL 被视为最小值。\n\n若 *X* 是矩阵,在每列内进行上述计算。\n\n#### 例子\n\n```\nx = [NULL, 3.1, NULL, 3.0, 2.9, 2.8, 3.1, NULL, 3.2]\nmTopRange(x, window=3)\n// output: [,,0,1,0,0,2,0,2]\n\nmTopRange(x, window=3, minPeriods=1)\n// output: [,1,0,1,0,0,2,0,2]\n\nx = [NULL, NULL, NULL, NULL, NULL, 2, NULL, NULL, 3.2]\ndate = [0, 1, 2, 3, 7, 8, 9, 10, 11] + 2020.01.01\nX = indexedSeries(date, x) \nmTopRange(X, 3d)\n```\n\n| | #0 |\n| ---------- | -- |\n| 2020.01.01 | |\n| 2020.01.02 | |\n| 2020.01.03 | |\n| 2020.01.04 | |\n| 2020.01.08 | |\n| 2020.01.09 | 1 |\n| 2020.01.10 | 0 |\n| 2020.01.11 | 0 |\n| 2020.01.12 | 2 |\n\n```\nm = matrix(1 2 3 NULL, 1 2 NULL 3, 1 3 NULL NULL, 1 2 3 4)\nmTopRange(m, 2)\n```\n\n| #0 | #1 | #2 | #3 |\n| -- | -- | -- | -- |\n| | | | |\n| 1 | 1 | 1 | 1 |\n| 1 | 0 | 0 | 1 |\n| 0 | 1 | | 1 |\n\n
|
|
20263
|
+
"markdown": "### [mTopRange](https://docs.dolphindb.cn/zh/funcs/m/mtoprange.html)\n\n#### 语法\n\nmTopRange(X, window, \\[minPeriods])\n\n参数说明和窗口计算规则请参考:[mFunctions](https://docs.dolphindb.cn/zh/funcs/themes/mFunctions.html)\n\n#### 详情\n\n在给定长度(以元素个数或时间长度衡量)的滑动窗口内,统计每个元素 Xi 左侧相邻且连续小于它的元素个数。NULL 被视为最小值。\n\n若 *X* 是矩阵,在每列内进行上述计算。\n\n#### 例子\n\n```\nx = [NULL, 3.1, NULL, 3.0, 2.9, 2.8, 3.1, NULL, 3.2]\nmTopRange(x, window=3)\n// output: [,,0,1,0,0,2,0,2]\n\nmTopRange(x, window=3, minPeriods=1)\n// output: [,1,0,1,0,0,2,0,2]\n\nx = [NULL, NULL, NULL, NULL, NULL, 2, NULL, NULL, 3.2]\ndate = [0, 1, 2, 3, 7, 8, 9, 10, 11] + 2020.01.01\nX = indexedSeries(date, x) \nmTopRange(X, 3d)\n```\n\n| | #0 |\n| ---------- | -- |\n| 2020.01.01 | |\n| 2020.01.02 | |\n| 2020.01.03 | |\n| 2020.01.04 | |\n| 2020.01.08 | |\n| 2020.01.09 | 1 |\n| 2020.01.10 | 0 |\n| 2020.01.11 | 0 |\n| 2020.01.12 | 2 |\n\n```\nm = matrix(1 2 3 NULL, 1 2 NULL 3, 1 3 NULL NULL, 1 2 3 4)\nmTopRange(m, 2)\n```\n\n| #0 | #1 | #2 | #3 |\n| -- | -- | -- | -- |\n| | | | |\n| 1 | 1 | 1 | 1 |\n| 1 | 0 | 0 | 1 |\n| 0 | 1 | | 1 |\n\n"
|
|
20264
20264
|
},
|
|
20265
20265
|
"mul": {
|
|
20266
20266
|
"url": "https://docs.dolphindb.cn/zh/funcs/m/mul.html",
|
|
@@ -20665,222 +20665,6 @@
|
|
|
20665
20665
|
],
|
|
20666
20666
|
"markdown": "### [mwsumTopN](https://docs.dolphindb.cn/zh/funcs/m/mwsumTopN.html)\n\n\n\n#### 语法\n\nmwsumTopN(X, Y, S, window, top, \\[ascending=true], \\[tiesMethod='oldest'])\n\n参数说明和窗口计算规则请参考:[mTopN](https://docs.dolphindb.cn/zh/funcs/themes/TopN.html)\n\n#### 详情\n\n在给定长度(以元素个数衡量)的滑动窗口内,根据 *ascending* 指定的排序方式将 *X* 和 *Y* 按照 *S* 进行稳定排序后,取前 *top* 个元素,然后计算 *Y* 和 *X* 的内积。\n\n#### 例子\n\n```\nx = NULL 3 8 4 0 7 4\ny = 2 3 1 7 3 6 1\ns = 5 NULL 8 9 9 4 4\n\nmwsumTopN(x, y, s, 4, 3)\n// output\n[,,8,36,36,78,74]\n\ns2=2021.01.01 2021.02.03 2021.01.23 2021.04.06 2021.12.29 2021.04.16 2021.10.29\nmwsumTopN(x, y, s2, 3, 2)\n// output\n[ , 9, 8, 17, 36, 70, 46]\n\nx1 = matrix(x, 4 3 6 2 3 1 3)\ny1=matrix(3 7 9 3 2 4 6, y)\ns1=matrix(2 3 1 7 3 NULL 1, s)\n\nmwsumTopN(x1,y1,s1,4,3)\n```\n\n| #1 | #2 |\n| -- | -- |\n| | 8 |\n| 21 | 8 |\n| 93 | 14 |\n| 93 | 28 |\n| 93 | 29 |\n| 84 | 26 |\n| 36 | 23 |\n\n```\nmwsumTopN(x1, y1, s, 4, 3)\n```\n\n| #1 | #2 |\n| --- | -- |\n| | 8 |\n| | 8 |\n| 72 | 14 |\n| 84 | 28 |\n| 84 | 29 |\n| 112 | 26 |\n| 64 | 23 |\n\n```\nn = 3000\nids = 1..3000\ndates = take(2021.01.01..2021.10.01,n)\nprices = rand(1000,n)\nvals = rand(1000,n)\nt = table(ids as id,dates as date,prices as price,vals as val)\ndbName = \"dfs://test_mwsumTopN_2\"\nif(existsDatabase(dbName))dropDB(dbName)\ndb = database(dbName,VALUE,1..5000)\npt = db.createPartitionedTable(t,\"pt\",`id).append!(t)\nselect mwsumTopN(price, val, id, 10, 5, true) from pt where date>2021.05.01\n```\n\n相关函数:[mwsum](https://docs.dolphindb.cn/zh/funcs/m/mwsum.html)\n"
|
|
20667
20667
|
},
|
|
20668
|
-
"objByName": {
|
|
20669
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/o/objByName.html",
|
|
20670
|
-
"signatures": [
|
|
20671
|
-
{
|
|
20672
|
-
"full": "objByName(name, [sharedVar])",
|
|
20673
|
-
"name": "objByName",
|
|
20674
|
-
"parameters": [
|
|
20675
|
-
{
|
|
20676
|
-
"full": "name",
|
|
20677
|
-
"name": "name"
|
|
20678
|
-
},
|
|
20679
|
-
{
|
|
20680
|
-
"full": "[sharedVar]",
|
|
20681
|
-
"name": "sharedVar",
|
|
20682
|
-
"optional": true
|
|
20683
|
-
}
|
|
20684
|
-
]
|
|
20685
|
-
}
|
|
20686
|
-
],
|
|
20687
|
-
"markdown": "### [objByName](https://docs.dolphindb.cn/zh/funcs/o/objByName.html)\n\n\n\n#### 语法\n\nobjByName(name, \\[sharedVar])\n\n#### 参数\n\n**name** 是一个字符串,表示表名。\n\n**sharedVar** 是一个布尔值。\n\n#### 详情\n\nDolphinDB 在执行脚本之前先解析脚本。解析脚本的过程是检查变量是否在本地定义。如果没有在本地定义,则抛出异常。\n\n假设我们在本地定义一个函数,然后在远程节点上执行。这个函数会查询共享表。但是,共享表在远程节点上而不在本地节点上。如果在函数的 SQL 语句中直接调用表名,系统将不能解析脚本。\n\n为了解决这个问题,系统函数 `objByName` 在执行时会根据名称返回对象。\n\n如果没有指定 *sharedVar* 参数,系统首先搜索会话中的局部变量,再搜索共享变量。如果 *sharedVar* 为true,表示只搜索共享变量。如果 *sharedVar* 为false,表示只搜索局部变量。\n\n#### 例子\n\n假设在本地节点上有一个表 EarningsDates,它包含两列:Ticker 和 date。主机名为localhost 服务器的 8081 端口上的远程节点有一个表 USPrices。它包含所有美国股票的每日价格。我们想要从远程节点取得 EarningsDates 表中所有股票在公布收益后一周的价格。\n\n在远程节点,导入数据文件创建表 USPrices,然后在所有节点间共享。\n\n```\nUSPrices = loadText(\"c:/DolphinDB/Data/USPrices.csv\")\nshare USPrices as sharedUSPrices;\n```\n\n在本地节点,创建表 EarningsDates,然后把表和脚本发送到远程节点。执行完成后,结果会发送回本地节点。\n\n```\nEarningsDates=table(`XOM`AAPL`IBM as TICKER, 2006.10.26 2006.10.19 2006.10.17 as date)\ndef loadDailyPrice(data){\n dateDict = dict(data.TICKER, data.date)\n return select date, TICKER, PRC from objByName(\"sharedUSPrices\") where dateDict[TICKER]<date<=dateDict[TICKER]+7\n}\nconn = xdb(\"localhost\",8081)\nprices = conn(loadDailyPrice, EarningsDates);\n\nprices;\n```\n\n| date | TICKER | PRC |\n| ---------- | ------ | ----- |\n| 2006.10.27 | XOM | 71.46 |\n| 2006.10.30 | XOM | 70.84 |\n| 2006.10.31 | XOM | 71.42 |\n| 2006.11.01 | XOM | 71.06 |\n| 2006.11.02 | XOM | 71.19 |\n| 2006.10.18 | IBM | 89.82 |\n| 2006.10.19 | IBM | 89.86 |\n| 2006.10.20 | IBM | 90.48 |\n| 2006.10.23 | IBM | 91.56 |\n| 2006.10.24 | IBM | 91.49 |\n| 2006.10.20 | AAPL | 79.95 |\n| 2006.10.23 | AAPL | 81.46 |\n| 2006.10.24 | AAPL | 81.05 |\n| 2006.10.25 | AAPL | 81.68 |\n| 2006.10.26 | AAPL | 82.19 |\n"
|
|
20688
|
-
},
|
|
20689
|
-
"objectChecksum": {
|
|
20690
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/o/objectChecksum.html",
|
|
20691
|
-
"signatures": [
|
|
20692
|
-
{
|
|
20693
|
-
"full": "objectChecksum(vector, [prev])",
|
|
20694
|
-
"name": "objectChecksum",
|
|
20695
|
-
"parameters": [
|
|
20696
|
-
{
|
|
20697
|
-
"full": "vector",
|
|
20698
|
-
"name": "vector"
|
|
20699
|
-
},
|
|
20700
|
-
{
|
|
20701
|
-
"full": "[prev]",
|
|
20702
|
-
"name": "prev",
|
|
20703
|
-
"optional": true
|
|
20704
|
-
}
|
|
20705
|
-
]
|
|
20706
|
-
}
|
|
20707
|
-
],
|
|
20708
|
-
"markdown": "### [objectChecksum](https://docs.dolphindb.cn/zh/funcs/o/objectChecksum.html)\n\n\n\n#### 语法\n\nobjectChecksum(vector, \\[prev])\n\n#### 参数\n\n**vector** 向量。用于进行校验和(checksum)计算。\n\n**prev** 整数。当 *vector* 过长时,可以通过指定 *prev* 分段迭代求完整的校验和,*prev* 表示迭代时前一段数据的校验和。\n\n#### 详情\n\n计算向量的校验和,返回一个整数。通常用于校验数据的完整性。\n\n#### 例子\n\n```\nprint objectChecksum(take(`A`B`C, 10))\n// output\n-268298654\n\nprint objectChecksum(2.3 6.5 7.8)\n// output\n-430996932\n\n// 分段计算校验和\nprint objectChecksum(1..15)\n// output\n-1877567753\n\nt0 = objectChecksum(1..5)\nt1 = objectChecksum(6..10, t0)\nt2 = objectChecksum(11..15, t1)\nprint t2\n// output\n-1877567753\n```\n"
|
|
20709
|
-
},
|
|
20710
|
-
"objs": {
|
|
20711
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/o/objs.html",
|
|
20712
|
-
"signatures": [
|
|
20713
|
-
{
|
|
20714
|
-
"full": "objs([shared=false])",
|
|
20715
|
-
"name": "objs",
|
|
20716
|
-
"parameters": [
|
|
20717
|
-
{
|
|
20718
|
-
"full": "[shared=false]",
|
|
20719
|
-
"name": "shared",
|
|
20720
|
-
"optional": true,
|
|
20721
|
-
"default": "false"
|
|
20722
|
-
}
|
|
20723
|
-
]
|
|
20724
|
-
}
|
|
20725
|
-
],
|
|
20726
|
-
"markdown": "### [objs](https://docs.dolphindb.cn/zh/funcs/o/objs.html)\n\n\n\n#### 语法\n\nobjs(\\[shared=false])\n\n#### 参数\n\n**shared** 布尔值,默认为 false。\n\n* false:返回当前会话中所有变量的信息;\n\n* true:返回当前会话中所有变量的信息以及所有会话共享的变量信息;\n\n#### 详情\n\n用于获取内存中缓存的各变量的内存占用情况等信息。返回一个表,它具有以下几列:\n\n* name: 变量名。\n\n* type: 变量的数据类型。\n\n* form: 变量的数据形式。\n\n* rows:\n\n * 若 form 为向量/字典/集合,则返回所有元素(包含 NULL)的个数\n\n * 若 form 为矩阵/表,则返回它们的行数\n\n* columns:\n\n * 若 form 为向量/字典/集合,则返回 1\n\n * 若 form 为矩阵/表,则返回它们的列数\n\n* bytes: 变量占用的内存大小,单位为字节\n\n* shared: 是否为共享变量\n\n* extra: 分布式表的逻辑路径,格式为 `\"dfs://dbName/tableName\"`\n\n* owner:共享变量的创建者。只有设置 shared=true 时才会显示该字段。对于本地变量,此字段值为空。\n\n注意,该函数不返回函数定义。我们应该用 defs 检查函数定义,或通过 [memSize](https://docs.dolphindb.cn/zh/funcs/m/memSize.html) 查看函数定义的内存占用。\n\n#### 例子\n\n```\n// 创建分布式数据库\nif(existsDatabase(\"dfs://listdb\")){\n dropDatabase(\"dfs://listdb\")\n}\nn=1000000\nticker = rand(`MSFT`GOOG`FB`ORCL`IBM,n);\nticker[0..5]\nx=rand(1.0, n)\nt=table(ticker, x)\ndb=database(directory=\"dfs://listdb\", partitionType=HASH, partitionScheme=[STRING, 5])\npt=db.createPartitionedTable(t, `pt, `ticker)\npt.append!(t)\n\n// 共享内存表\ntime = take(2021.08.20 00:00:00..2021.08.30 00:00:00, 40);\nid = 0..39;\nvalue = rand(100, 40);\ntmp = table(time, id, value);\nshare tmp as st\n\n// 创建 set\ns = set([1,2,3,4,5])\n\n// 创建 dict\nx=1 2 3\ny=4.5 7.8 4.3\nz=dict(x,y);\n\n// 创建 matrix\nm = matrix(1 2 3, 4 5 6)\n\n// 创建 pair\np = 1:2\n```\n\n```\nobjs(true)\n```\n\n| name | type | form | rows | columns | bytes | shared | extra | owner |\n| ------ | -------- | ---------- | --------- | ------- | ---------- | ------ | ---------------- | ----- |\n| n | INT | SCALAR | 1 | 1 | 16 | false | | |\n| ticker | SYMBOL | VECTOR | 1,000,000 | 1 | 4,000,000 | false | | |\n| x | INT | VECTOR | 3 | 1 | 12 | false | | |\n| t | BASIC | TABLE | 1,000,000 | 2 | 12,000,312 | false | | |\n| db | HANDLE | SCALAR | 1 | 1 | 24 | false | | |\n| pt | ALIAS | TABLE | 0 | 2 | 12,000,000 | false | dfs\\://listdb/pt | |\n| time | DATETIME | VECTOR | 40 | 1 | 160 | false | | |\n| id | INT | VECTOR | 40 | 1 | 160 | false | | |\n| value | INT | VECTOR | 40 | 1 | 160 | false | | |\n| tmp | BASIC | TABLE | 40 | 3 | 832 | false | | |\n| s | INT | SET | 5 | 1 | 28 | false | | |\n| y | DOUBLE | VECTOR | 3 | 1 | 24 | false | | |\n| z | DOUBLE | DICTIONARY | 3 | 1 | 199 | false | | |\n| m | INT | MATRIX | 3 | 2 | 24 | false | | |\n| p | INT | PAIR | 2 | 1 | 8 | false | | |\n| st | BASIC | TABLE | 40 | 3 | 832 | true | | admin |\n"
|
|
20727
|
-
},
|
|
20728
|
-
"ols": {
|
|
20729
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/o/ols.html",
|
|
20730
|
-
"signatures": [
|
|
20731
|
-
{
|
|
20732
|
-
"full": "ols(Y, X, [intercept=true], [mode=0], [method=\"default\"], [usePinv=true])",
|
|
20733
|
-
"name": "ols",
|
|
20734
|
-
"parameters": [
|
|
20735
|
-
{
|
|
20736
|
-
"full": "Y",
|
|
20737
|
-
"name": "Y"
|
|
20738
|
-
},
|
|
20739
|
-
{
|
|
20740
|
-
"full": "X",
|
|
20741
|
-
"name": "X"
|
|
20742
|
-
},
|
|
20743
|
-
{
|
|
20744
|
-
"full": "[intercept=true]",
|
|
20745
|
-
"name": "intercept",
|
|
20746
|
-
"optional": true,
|
|
20747
|
-
"default": "true"
|
|
20748
|
-
},
|
|
20749
|
-
{
|
|
20750
|
-
"full": "[mode=0]",
|
|
20751
|
-
"name": "mode",
|
|
20752
|
-
"optional": true,
|
|
20753
|
-
"default": "0"
|
|
20754
|
-
},
|
|
20755
|
-
{
|
|
20756
|
-
"full": "[method=\"default\"]",
|
|
20757
|
-
"name": "method",
|
|
20758
|
-
"optional": true,
|
|
20759
|
-
"default": "\"default\""
|
|
20760
|
-
},
|
|
20761
|
-
{
|
|
20762
|
-
"full": "[usePinv=true]",
|
|
20763
|
-
"name": "usePinv",
|
|
20764
|
-
"optional": true,
|
|
20765
|
-
"default": "true"
|
|
20766
|
-
}
|
|
20767
|
-
]
|
|
20768
|
-
}
|
|
20769
|
-
],
|
|
20770
|
-
"markdown": "### [ols](https://docs.dolphindb.cn/zh/funcs/o/ols.html)\n\n\n\n#### 语法\n\nols(Y, X, \\[intercept=true], \\[mode=0], \\[method=\"default\"], \\[usePinv=true])\n\n#### 参数\n\n**Y** 是因变量;**X** 是自变量。\n\n**Y** 是一个向量;**X** 是一个向量、元组、矩阵或表。当 *X* 是矩阵时,如果行数等于 *Y* 的长度,*X* 的每一列都是一个因子;如果行数不等于 *Y* 的长度,并且如果列数等于 *Y* 的长度,*X* 的每一行都是一个因子。\n\n**intercept** 是一个布尔变量,表示是否包含回归中的截距。默认值是 true。当它为 true 时,系统自动给 *X* 添加一列 \"1\" 以生成截距。\n\n**mode** 是一个整数,默认值为 0,可取以下 3 个值\n\n* 0:输出一个系数估计向量\n\n* 1:输出一个具有系数估计,标准差,t 统计量和 p 值的表\n\n* 2:输出一个具有 ANOVA(方差分析)、RegressionStat(回归统计)、Cofficient(系数))和 Residual(残差))的字典,具体含义见下表:\n\n键 ANOVA 对应值:\n\n| Source of Variance | 自由度(Degree of freedom) | 平方和(Sum of Square) | 均方差(Mean of square) | F统计量 | Significance |\n| ------------------ | ---------------------- | ------------------ | ------------------- | ------------- | ------------- |\n| Regression(回归) | 变量个数(p) | 回归平方和(SSR) | 回归均方差(MSR=SSR/R) | MSR 对 MSE 的比值 | 显著性,即统计出的 P 值 |\n| Residual(残差) | 残差自由度(n-p-1) | 残差平方和(SSE) | 残差均方差(MSE=MSE/E) | | |\n| Total | 样本自由度 | | | | |\n| 不包括常数项(n-1) | 总离差平方和(SST) | | | | |\n\n键 RegressionStat 对应值:\n\n| item | 统计值 |\n| ------------ | ---------------------------------------------------------------- |\n| R2 | R 决定系数,描述回归曲线对真实数据点拟合程度的统计量。范围在 \\[0,1]之间,越接近1 ,说明对y的解释能力越强,拟合越好。 |\n| AdjustedR2 | 经自由度修正后的决定系数,通过样本数量与模型数量对 R-squared 进行修正。 |\n| StdError | 回归残差标准误差,残差经自由度修正后的标准差。 |\n| Observations | 观察样本个数。 |\n\n键 Coefficient 对应值:\n\n| 元素 | 说明 |\n| -------- | ---------------- |\n| factor | 自变量名称 |\n| beta | 回归系数估计值 |\n| stdError | 回归系数标准误差。 |\n| tstat | T统计值,衡量系数的统计显著性。 |\n\n键 Residual 对应每一个预测值和实际值之间的残差。\n\n**method**是一个字符串,表示求解最小二乘问题采用的方法。\n\n* 默认值为“default”,表示采用构造系数矩阵和逆矩阵的方式求解;\n\n* 设置为“svd”,采用奇异值分解的方式。\n\n**usePinv**一个布尔值,表示计算过程中求矩阵的逆时,是否求矩阵的伪逆。\n\n* 默认值为 true,表示求矩阵的伪逆,奇异矩阵必须指定为 true。\n\n* 若为 false,表示求矩阵的逆,只适用于非奇异矩阵。\n\n#### 详情\n\n返回对 *X* 和 *Y* 计算普通最小二乘回归的结果。需要注意的是,该函数会将 *X* 和 *Y* 中的空值替换为0后进行计算。\n\n#### 例子\n\n```\nx1=1 3 5 7 11 16 23\nx2=2 8 11 34 56 54 100\ny=0.1 4.2 5.6 8.8 22.1 35.6 77.2;\n\nols(y, x1);\n// output\n[-9.912821,3.378632]\n\nols(y, (x1,x2));\n// output\n[-9.494813,2.806426,0.13147]\n```\n\n```\nols(y, (x1,x2), 1, 1);\n```\n\n| factor | beta | stdError | tstat | pvalue |\n| --------- | --------- | -------- | --------- | -------- |\n| intercept | -9.494813 | 5.233168 | -1.814353 | 0.143818 |\n| x1 | 2.806426 | 1.830782 | 1.532911 | 0.20007 |\n| x2 | 0.13147 | 0.409081 | 0.321379 | 0.764015 |\n\n```\nols(y, (x1,x2), 1, 2);\n// output\nCoefficient->\nfactor beta stdError tstat pvalue\n--------- --------- -------- --------- --------\nintercept -9.494813 5.233168 -1.814353 0.143818\nx1 2.806426 1.830782 1.532911 0.20007\nx2 0.13147 0.409081 0.321379 0.764015\n\nResidual->[6.525447,4.223774,-0.383487,-5.820153,-6.638199,-6.907387,9.000005]\nRegressionStat->\nitem statistics\n------------ ----------\nR2 0.940241\nAdjustedR2 0.910361\nStdError 8.173444\nObservations 7\n\nANOVA->\nBreakdown DF SS MS F Significance\n---------- -- ----------- ----------- --------- ------------\nRegression 2 4204.416396 2102.208198 31.467739 0.003571\nResidual 4 267.220747 66.805187\nTotal 6 4471.637143\n```\n\n```\nx=matrix(1 4 8 2 3, 1 4 2 3 8, 1 5 1 1 5);\nx;\n```\n\n| #0 | #1 | #2 |\n| -- | -- | -- |\n| 1 | 1 | 1 |\n| 4 | 4 | 5 |\n| 8 | 2 | 1 |\n| 2 | 3 | 1 |\n| 3 | 8 | 5 |\n\n```\nols(1..5, x);\n// output\n[1.156537,0.105505,0.91055,-0.697821]\n\nols(1..5, x.transpose());\n// output\n[1.156537,0.105505,0.91055,-0.697821]\n// 系统会调整因变量和自变量的维数,以便进行回归\n```\n\n```\nx = table([13.9782,13.4688,13.4336,12.9642,12.7905,13.4771,13.0423,12.6588,13.8933,13.9006] as col0, [195.3904,181.4090,180.4627,168.0723,163.5973,181.6342,170.1017,160.2477,193.0241,193.2270] as col1, [2731.2089,2443.3656,2424.2715,2178.9356,2092.4947,2447.9167,2218.5185,2028.5594,2681.7456,2685.9754] as col2)\ny = [-0.4002,-0.8004,-0.2002,-1.0002,-0.2001,-0.5001,-0.2501,0.0000,0.0000,0.0000]\n\nols(y, x, true, 0, \"default\")\n[2.968166,13.023638,-2.016390,0.076485]\n\nols(y, x, true, 0, \"svd\")\n[3266.457957,-722.195120,53.157806,-1.302769]\n```\n\n```\nx1=1 1 1\nx2=2 2 2\ny = 1 1 1\nols(y, (x1, x2))\n// output:[0.16666666666666669\t0.16666666666666669\t0.33333333333333326]\nols(y, (x1, x2), usePinv=false) \n// ERR: The input matrix is singular and cannot be inverted.\n```\n\n由于在求解过程中,参与求逆的矩阵是奇异的,因此 usePinv=false 时报错。\n"
|
|
20771
|
-
},
|
|
20772
|
-
"olsEx": {
|
|
20773
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/o/olsEx.html",
|
|
20774
|
-
"signatures": [
|
|
20775
|
-
{
|
|
20776
|
-
"full": "olsEx(ds, Y, X, [intercept=true], [mode=0])",
|
|
20777
|
-
"name": "olsEx",
|
|
20778
|
-
"parameters": [
|
|
20779
|
-
{
|
|
20780
|
-
"full": "ds",
|
|
20781
|
-
"name": "ds"
|
|
20782
|
-
},
|
|
20783
|
-
{
|
|
20784
|
-
"full": "Y",
|
|
20785
|
-
"name": "Y"
|
|
20786
|
-
},
|
|
20787
|
-
{
|
|
20788
|
-
"full": "X",
|
|
20789
|
-
"name": "X"
|
|
20790
|
-
},
|
|
20791
|
-
{
|
|
20792
|
-
"full": "[intercept=true]",
|
|
20793
|
-
"name": "intercept",
|
|
20794
|
-
"optional": true,
|
|
20795
|
-
"default": "true"
|
|
20796
|
-
},
|
|
20797
|
-
{
|
|
20798
|
-
"full": "[mode=0]",
|
|
20799
|
-
"name": "mode",
|
|
20800
|
-
"optional": true,
|
|
20801
|
-
"default": "0"
|
|
20802
|
-
}
|
|
20803
|
-
]
|
|
20804
|
-
}
|
|
20805
|
-
],
|
|
20806
|
-
"markdown": "### [olsEx](https://docs.dolphindb.cn/zh/funcs/o/olsEx.html)\n\n\n\n#### 语法\n\nolsEx(ds, Y, X, \\[intercept=true], \\[mode=0])\n\n#### 参数\n\n**ds** 是存储在元组中的数据源集合。它通常是由 [sqlDS](https://docs.dolphindb.cn/zh/funcs/s/sqlDS.html) 函数生成。\n\n**Y** 是一个字符串,表示 *ds* 表中因变量的列名。\n\n**X** 是字符串标量或向量,表示 *ds* 表中自变量的列名。\n\n**intercept** 是一个布尔变量,指示是否包含回归中的截距。默认值是 true。当它为 true 时,系统自动给 *X* 添加一列 \"1\" 以生成截距。\n\n**mode** 是一个整数,默认值为 0,取以下 3 个值之一\n\n* 0:输出一个系数估计向量\n\n* 1:输出一个具有系数估计,标准差,t统计量和p值的表\n\n* 2:输出一个具有 ANOVA(方差分析)、RegressionStat(回归统计)和 Cofficient(系数)的字典,具体含义见下表:\n\n键 ANOVA 对应值:\n\n| Source of Variance | 自由度(Degree of freedom) | 平方和(Sum of Square) | 均方差(Mean of square) | F 统计量 | Significance |\n| ------------------ | ---------------------- | ------------------ | ------------------- | ------------- | ------------ |\n| Regression(回归) | 变量个数(p) | 回归平方和(SSR) | 回归均方差(MSR=SSR/R) | MSR 对 MSE 的比值 | 显著性,即统计出的P值 |\n| Residual(残差) | 残差自由度(n-p-1) | 残差平方和(SSE) | 残差均方差(MSE=MSE/E) | | |\n| Total | 样本自由度 | | | | |\n| 不包括常数项(n-1) | 总离差平方和(SST) | | | | |\n\n键RegressionStat对应值:\n\n| item | 统计值 |\n| ------------ | ---------------------------------------------------------------- |\n| R2 | R 决定系数,描述回归曲线对真实数据点拟合程度的统计量。范围在 \\[0,1]之间,越接近1 ,说明对y的解释能力越强,拟合越好。 |\n| AdjustedR2 | 经自由度修正后的决定系数,通过样本数量与模型数量对 R-squared 进行修正。 |\n| StdError | 回归残差标准误差,残差经自由度修正后的标准差。 |\n| Observations | 观察样本个数。 |\n\n键Coefficient对应值:\n\n| 元素 | 说明 |\n| -------- | ---------------------------- |\n| factor | 自变量名称 |\n| beta | 回归系数估计值 |\n| stdError | 回归系数标准误差。标准差越大,回归系数的估计值越不靠谱。 |\n| tstat | T 统计值,衡量系数的统计显著性。 |\n\n#### 详情\n\n返回对 *X* 和 *Y* 计算普通最小二乘回归的结果。*X* 和 *Y* 是分布式表中的列。\n\n**Note:**\n\n* 该函数会将 *X* 和 *Y* 中的空值替换为0后进行计算。\n\n* 因为`olsEX` 不支持输出残差,可以通过 [residual](https://docs.dolphindb.cn/zh/funcs/r/residual.html) 获取残差。\n\n#### 例子\n\n```\nn=10000\nID=rand(100, n)\ndates=2017.08.07..2017.08.11\ndate=rand(dates, n)\nvol=rand(1..10 join int(), n)\nprice=rand(100,n)\nt=table(ID, date, vol,price)\nsaveText(t, \"/home/DolphinDB/Data/t.txt\");\nif(existsDatabase(\"dfs://rangedb\")){\n dropDatabase(\"dfs://rangedb\")\n}\ndb = database(directory=\"dfs://rangedb\", partitionType=RANGE, partitionScheme=0 51 101)\nUSPrices=loadTextEx(dbHandle=db,tableName=`USPrices, partitionColumns=`ID, filename=\"/home/DolphinDB/Data/t.txt\");\n\nds=sqlDS(<select vol as VS, price as SBA from USPrices where vol>5>)\nrs=olsEx(ds, `VS, `SBA, true, 2)\nrs;\n\n// output\nRegressionStat->\nitem statistics\n------------ ----------\nR2 0.000848\nAdjustedR2 0.000628\nStdError 1.404645\nObservations 4535\n\nANOVA->\nBreakdown DF SS MS F Significance\n---------- ---- ----------- -------- -------- ------------\nRegression 1 7.592565 7.592565 3.848178 0.049861\nResidual 4533 8943.739298 1.973029\nTotal 4534 8951.331863\n\nCoefficient->\nfactor beta stdError tstat pvalue\n--------- -------- -------- ---------- --------\nintercept 7.953084 0.04185 190.039423 0\nSBA 0.001422 0.000725 1.961677 0.049861\n```\n"
|
|
20807
|
-
},
|
|
20808
|
-
"oneHot": {
|
|
20809
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/o/oneHot.html",
|
|
20810
|
-
"signatures": [
|
|
20811
|
-
{
|
|
20812
|
-
"full": "oneHot(obj, encodingColumns)",
|
|
20813
|
-
"name": "oneHot",
|
|
20814
|
-
"parameters": [
|
|
20815
|
-
{
|
|
20816
|
-
"full": "obj",
|
|
20817
|
-
"name": "obj"
|
|
20818
|
-
},
|
|
20819
|
-
{
|
|
20820
|
-
"full": "encodingColumns",
|
|
20821
|
-
"name": "encodingColumns"
|
|
20822
|
-
}
|
|
20823
|
-
]
|
|
20824
|
-
}
|
|
20825
|
-
],
|
|
20826
|
-
"markdown": "### [oneHot](https://docs.dolphindb.cn/zh/funcs/o/oneHot.html)\n\n\n\n#### 语法\n\noneHot(obj, encodingColumns)\n\n#### 参数\n\n**obj** 是一个内存表。\n\n**encodingColumns** 是一个字符串或者字符串向量,指定用于编码的列名。\n\n#### 详情\n\n对指定的列进行独热编码(one-hot),返回编码后的表,列的顺序为编码列,非编码列。其中,编码列的列名格式为:原字段名\\_值。\n\n#### 例子\n\n```\nt = table( take(`Tom`Lily`Jim, 10) as name, take(true false, 10) as gender, take(21..23,10) as age);\noneHot(t, `name`gender);\n```\n\n输出返回:\n\n| name\\_Tom | name\\_Lily | name\\_Jim | gender\\_1 | gender\\_0 | age |\n| --------- | ---------- | --------- | --------- | --------- | --- |\n| 1 | 0 | 0 | 1 | 0 | 21 |\n| 0 | 1 | 0 | 0 | 1 | 22 |\n| 0 | 0 | 1 | 1 | 0 | 23 |\n| 1 | 0 | 0 | 0 | 1 | 21 |\n| 0 | 1 | 0 | 1 | 0 | 22 |\n| 0 | 0 | 1 | 0 | 1 | 23 |\n| 1 | 0 | 0 | 1 | 0 | 21 |\n| 0 | 1 | 0 | 0 | 1 | 22 |\n| 0 | 0 | 1 | 1 | 0 | 23 |\n| 1 | 0 | 0 | 0 | 1 | 21 |\n"
|
|
20827
|
-
},
|
|
20828
|
-
"or": {
|
|
20829
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/o/or.html",
|
|
20830
|
-
"signatures": [
|
|
20831
|
-
{
|
|
20832
|
-
"full": "or(X, Y)",
|
|
20833
|
-
"name": "or",
|
|
20834
|
-
"parameters": [
|
|
20835
|
-
{
|
|
20836
|
-
"full": "X",
|
|
20837
|
-
"name": "X"
|
|
20838
|
-
},
|
|
20839
|
-
{
|
|
20840
|
-
"full": "Y",
|
|
20841
|
-
"name": "Y"
|
|
20842
|
-
}
|
|
20843
|
-
]
|
|
20844
|
-
}
|
|
20845
|
-
],
|
|
20846
|
-
"markdown": "### [or](https://docs.dolphindb.cn/zh/funcs/o/or.html)\n\n\n\n#### 语法\n\nor(X, Y) 或 X||Y\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、数据对、向量或矩阵。\n\n#### 详情\n\n按元素逐个返回 *X* 逻辑或 `(OR)Y`的结果。\n\n注意:若 `or` 或 `||` 的操作数包含 NULL 时,|| 返回的对应结果为 NULL,而 `or` 针对不同 server 版本,返回的结果不同。\n\n* 对于小于 2.00.9.4 的版本,`or` 返回的对应结果为 NULL。\n\n* 对于 2.00.9.4 及以上版本,`or` 返回的结果由配置项 *logicOrIgnoreNull* 控制,见下表:\n\n| 操作数 | 操作数 | 返回值(*logicOrIgnoreNull*= true 时) | 返回值(*logicOrIgnoreNull*= false 时) |\n| ---- | ---- | -------------------------------- | --------------------------------- |\n| 非零 | NULL | true | NULL |\n| 零 | NULL | true | NULL |\n| NULL | NULL | true | NULL |\n\n#### 例子\n\n```\n1 || 0;\n```\n\n输出返回:true\n\n```\nx=1 0 1;\nx || 0;\n```\n\n输出返回:\\[true,false,true]\n\n```\ny=0 1 0;\nx or y;\n```\n\n输出返回:\\[true,true,true]\n\n```\nt=table(1..3 as id, 4..6 as value);\nt;\n```\n\n输出返回:\n\n| id | value |\n| -- | ----- |\n| 1 | 4 |\n| 2 | 5 |\n| 3 | 6 |\n\n```\nselect id, value from t where id=2 or id=3;\n```\n\n输出返回:\n\n| id | value |\n| -- | ----- |\n| 2 | 5 |\n| 3 | 6 |\n\n相关函数:[and](https://docs.dolphindb.cn/zh/funcs/a/and.html), [not](https://docs.dolphindb.cn/zh/funcs/n/not.html)\n"
|
|
20847
|
-
},
|
|
20848
|
-
"osqp": {
|
|
20849
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/o/osqp.html",
|
|
20850
|
-
"signatures": [
|
|
20851
|
-
{
|
|
20852
|
-
"full": "osqp(q, [P], [A], [lb], [ub])",
|
|
20853
|
-
"name": "osqp",
|
|
20854
|
-
"parameters": [
|
|
20855
|
-
{
|
|
20856
|
-
"full": "q",
|
|
20857
|
-
"name": "q"
|
|
20858
|
-
},
|
|
20859
|
-
{
|
|
20860
|
-
"full": "[P]",
|
|
20861
|
-
"name": "P",
|
|
20862
|
-
"optional": true
|
|
20863
|
-
},
|
|
20864
|
-
{
|
|
20865
|
-
"full": "[A]",
|
|
20866
|
-
"name": "A",
|
|
20867
|
-
"optional": true
|
|
20868
|
-
},
|
|
20869
|
-
{
|
|
20870
|
-
"full": "[lb]",
|
|
20871
|
-
"name": "lb",
|
|
20872
|
-
"optional": true
|
|
20873
|
-
},
|
|
20874
|
-
{
|
|
20875
|
-
"full": "[ub]",
|
|
20876
|
-
"name": "ub",
|
|
20877
|
-
"optional": true
|
|
20878
|
-
}
|
|
20879
|
-
]
|
|
20880
|
-
}
|
|
20881
|
-
],
|
|
20882
|
-
"markdown": "### [osqp](https://docs.dolphindb.cn/zh/funcs/o/osqp.html)\n\n#### 语法\n\nosqp(q, \\[P], \\[A], \\[lb], \\[ub])\n\n#### 详情\n\n求二元目标函数在线性约束条件下的最优解。具体模型如下:\n\n\n\n返回一个元组:\n\n* 第一个元素是字符串,表示求解状态:\n * solved :已解决\n * solved inaccurate:已解决,但结果不精准\n * primal infeasible:原问题无可行解\n * dual infeasible:对偶问题无可行解\n * maximum iterations reached:达到最大迭代次数\n * run time limit reached:运行超时\n * problem non convex:问题非凸\n * interrupted:求解被中断\n * unsolved:未解决\n* 第二个元素是数值型向量,表示目标函数取到最小值时的数值解。\n\n#### 参数\n\n* **q** 是目标函数一次项向量。\n* **P** 是目标函数的二次项矩阵,且必须是半正定矩阵。\n* **A** 是不等式约束的系数矩阵。\n* **lb** 是不等式约束的左端向量。\n* **ub** 是不等式约束的右端向量。\n\n**Note:**\n\n* *A*、*lb*、*ub* 必须同时指定或同时省略。\n* *lb* 和 *ub* 可以包含空值(NULL),但其长度必须和A的行数匹配。 *ub/lb* 为空值时,视为正/负无穷,在计算时对应值为 ±1030。\n\n#### 例子\n\n```\nP = matrix(4e-2 6e-3 -4e-3 0.0, 6e-3 1e-2 0.0 0.0, -4e-3 0.0 2.5e-3 0.0, 0.0 0.0 0.0 0.0)\nq = [-2, -4, 2, 3]\nA = [1,3,3,-2,2,-1,1,-4,1,2,-1,-5,1,1,1,1]$4:4\nl = [,,,1.0]\nu = [3.0,2.0,-1.0,1.0]\nres = osqp(q, P, newA, l, u)\nprint(res)\n```\n\n返回:(\"solved\",\\[-64.364818313795097,368.910318139716082,-548.041799338347459,244.496302999333039])\n\n"
|
|
20883
|
-
},
|
|
20884
20668
|
"nanInfFill": {
|
|
20885
20669
|
"url": "https://docs.dolphindb.cn/zh/funcs/n/nanInfFill.html",
|
|
20886
20670
|
"signatures": [
|
|
@@ -21134,65 +20918,287 @@
|
|
|
21134
20918
|
"full": "[nanoSecond=false]",
|
|
21135
20919
|
"name": "nanoSecond",
|
|
21136
20920
|
"optional": true,
|
|
21137
|
-
"default": "false"
|
|
20921
|
+
"default": "false"
|
|
20922
|
+
}
|
|
20923
|
+
]
|
|
20924
|
+
}
|
|
20925
|
+
],
|
|
20926
|
+
"markdown": "### [now](https://docs.dolphindb.cn/zh/funcs/n/now.html)\n\n\n\n#### 语法\n\nnow(\\[nanoSecond=false])\n\n#### 参数\n\n**nanoSecond** 是布尔值,表示是否精确到纳秒。它是可选参数,默认值为 false,表示精确到毫秒。\n\n#### 详情\n\n返回当前的时间戳。\n\n#### 例子\n\n```\nnow();\n// output\n2016.05.12T19:32:49.613\n\nnow(true);\n// output\n2016.05.12T19:32:49.614243000\n```\n"
|
|
20927
|
+
},
|
|
20928
|
+
"nss": {
|
|
20929
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/n/nss.html",
|
|
20930
|
+
"signatures": [
|
|
20931
|
+
{
|
|
20932
|
+
"full": "nss(maturity, yield, [method=\"nss\"])",
|
|
20933
|
+
"name": "nss",
|
|
20934
|
+
"parameters": [
|
|
20935
|
+
{
|
|
20936
|
+
"full": "maturity",
|
|
20937
|
+
"name": "maturity"
|
|
20938
|
+
},
|
|
20939
|
+
{
|
|
20940
|
+
"full": "yield",
|
|
20941
|
+
"name": "yield"
|
|
20942
|
+
},
|
|
20943
|
+
{
|
|
20944
|
+
"full": "[method=\"nss\"]",
|
|
20945
|
+
"name": "method",
|
|
20946
|
+
"optional": true,
|
|
20947
|
+
"default": "\"nss\""
|
|
20948
|
+
}
|
|
20949
|
+
]
|
|
20950
|
+
}
|
|
20951
|
+
],
|
|
20952
|
+
"markdown": "### [nss](https://docs.dolphindb.cn/zh/funcs/n/nss.html)\n\n\n\n#### 语法\n\nnss(maturity, yield, \\[method=\"nss\"])\n\n#### 参数\n\n**maturity**值大于 0 的数值型向量,表示历史债券的到期时间,单位是年。\n\n**yield**与 *maturity*等长的数值型向量,表示历史债券的收益率。\n\n**method**可选参数,字符串类型,表示使用的模型。可选值为:\n\n* \"ns\" 使用 Nelson-Siegel(NS) 模型。\n\n* \"nss\" 默认值,使用 Nelson-Siegel-Svensson(NSS) 模型。\n\n#### 详情\n\n使用 NS 模型或 NSS 模型和 Nelder-Mead 优化方法,拟合债券的收益率曲线。\n\n返回一个字典,包含以下键值对:\n\n**modelName**表示拟合所用模型的名称。\n\n**params**表示拟合后的模型参数:\n\n* 对于 NS 模型,向量长度为 4,依次为 β0, β1, β2, λ 。\n\n* 对于 NSS 模型,向量长度为 6,依次为 β0, β1, β2, β3, λ0, λ1。\n\n**fminResult** 表示 Nelder-Mead 方法的优化结果,详情见 [函数 fmin 文档](https://docs.dolphindb.cn/zh/funcs/f/fmin.html)。\n\n**predict** 模型的预测函数。其使用方法为 `model.predict(T)`,T 表示需要预测的到期时间,单位是年。返回此模型对到期时间 T 的预测收益率。\n\n#### 例子\n\n```\nmaturity = [1,2,3,4,5,8,10,15,20,25,30]\nyield = [0.0039,0.0061,NULL,NULL,0.0166,NULL,0.0258,NULL,NULL,0.0332,NULL]\nmodel = nss(maturity, yield)\n\nmodel.modelName \n//output: nss\n\nmodel.params \n//output:[0.038184469794996,-0.048575389082029,-0.022287414169806,0.047523360012739,1.873046195772644,0.161159907274023]\n\nmodel.fminResult\n/* Output:\nxopt->[0.038184469794996,-0.048575389082029,-0.022287414169806,0.047523360012739,1.873046195772644,0.161159907274023]\nfopt->5.456415848001168E-9\niterations->541\nfcalls->860\nwarnFlag->0\n*/\n\n// 调用预测函数进行预测\nmodel.predict([3,1])\n/* Output:\n[0.009904201306001,0.003891991292041]\n*/\n```\n\n相关函数:[nsspredict](https://docs.dolphindb.cn/zh/funcs/n/nsspredict.html)\n"
|
|
20953
|
+
},
|
|
20954
|
+
"nsspredict": {
|
|
20955
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/n/nsspredict.html",
|
|
20956
|
+
"signatures": [
|
|
20957
|
+
{
|
|
20958
|
+
"full": "nssPredict(model, maturity)",
|
|
20959
|
+
"name": "nssPredict",
|
|
20960
|
+
"parameters": [
|
|
20961
|
+
{
|
|
20962
|
+
"full": "model",
|
|
20963
|
+
"name": "model"
|
|
20964
|
+
},
|
|
20965
|
+
{
|
|
20966
|
+
"full": "maturity",
|
|
20967
|
+
"name": "maturity"
|
|
20968
|
+
}
|
|
20969
|
+
]
|
|
20970
|
+
}
|
|
20971
|
+
],
|
|
20972
|
+
"markdown": "### [nsspredict](https://docs.dolphindb.cn/zh/funcs/n/nsspredict.html)\n\n\n\n#### 语法\n\nnssPredict(model, maturity)\n\n#### 参数\n\n**model**字典类型,表示 Nelson-Siegel(NS) 模型或 Nelson-Siegel-Svensson(NSS)模型。字典中应至少包含 *modelName*和 *params*两个成员:\n\n* modelName 字符串类型,必须为 “ns” 或 “nss” 。\n\n* params 数值型向量,表示模型的参数:\n\n * 对于 NS 模型,向量长度为 4,依次为 β0, β1, β2, λ 。\n\n * 对于 NSS 模型,向量长度为 6,依次为 β0, β1, β2, β3, λ0, λ1。\n\n**maturity**值大于 0 的数值型向量,表示历史债券的到期时间,单位是年。\n\n#### 详情\n\n根据指定的 NS 模型或 NSS 模型,预测债券的收益率。\n\n#### 例子\n\n```\nmodel = dict(STRING, ANY)\nmodel[`modelName] = `nss\nmodel[`params] = [0.038184469794996,-0.048575389082029,-0.022287414169806,0.047523360012739,1.873046195772644,0.161159907274023]\nmaturity = [3,1]\nnssPredict(model, maturity)\n//output: [0.009904201306,0.003891991292041]\n```\n\n相关函数:[nss](https://docs.dolphindb.cn/zh/funcs/n/nss.html)\n"
|
|
20973
|
+
},
|
|
20974
|
+
"nullFill": {
|
|
20975
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/n/nullFill.html",
|
|
20976
|
+
"signatures": [
|
|
20977
|
+
{
|
|
20978
|
+
"full": "nullFill(X, Y)",
|
|
20979
|
+
"name": "nullFill",
|
|
20980
|
+
"parameters": [
|
|
20981
|
+
{
|
|
20982
|
+
"full": "X",
|
|
20983
|
+
"name": "X"
|
|
20984
|
+
},
|
|
20985
|
+
{
|
|
20986
|
+
"full": "Y",
|
|
20987
|
+
"name": "Y"
|
|
20988
|
+
}
|
|
20989
|
+
]
|
|
20990
|
+
}
|
|
20991
|
+
],
|
|
20992
|
+
"markdown": "### [nullFill](https://docs.dolphindb.cn/zh/funcs/n/nullFill.html)\n\n\n\n#### 语法\n\nnullFill(X, Y)\n\n#### 参数\n\n**X** 可以是向量、矩阵或表。\n\n**Y** 可以是一个标量,也可以是与 *X* 长度相同的向量或矩阵。\n\n#### 详情\n\n如果 *X* 是一个向量或矩阵:\n\n* 如果 *Y* 是标量,使用 *Y* 填充 *X* 中的 NULL 值。\n\n* 如果 *Y* 是一个与 *X* 等长的向量或矩阵,使用 *Y* 中与 *X* 的 NULL 值对应位置的元素替换 *X* 中的 NULL 值。\n\n如果 *X* 是一个表,那么 *Y* 只能是一个标量,使用 *Y* 填充表中的 NULL 值。注意,填充 NULL 值时,系统会尝试将 *Y* 进行类型转换。如果 *Y* 不能转换为表中某列的类型,系统会抛出异常。\n\n`nullFill` 不改变输入对象的值;`nullFill!` 会改变输入对象的值。\n\n#### 例子\n\n例1.向量\n\n```\nx=1 NULL NULL 6 NULL 7;\nnullFill(x,0);\n// output\n[1,0,0,6,0,7]\n\ny=1..6\nnullFill(x,y);\n// output\n[1,2,3,6,5,7]\n```\n\n在 SQL 语句中对表中的一列使用 `nullFill` 函数:\n\n```\nID=take(1,6) join take(2,6)\ndate=take(2018.01.01..2018.01.06, 12)\nx=3.2 5.2 NULL 7.4 NULL NULL NULL NULL 8 NULL NULL 11\nt=table(ID, date, x)\nt;\n```\n\n| ID | date | x |\n| -- | ---------- | --- |\n| 1 | 2018.01.01 | 3.2 |\n| 1 | 2018.01.02 | 5.2 |\n| 1 | 2018.01.03 | |\n| 1 | 2018.01.04 | 7.4 |\n| 1 | 2018.01.05 | |\n| 1 | 2018.01.06 | |\n| 2 | 2018.01.01 | |\n| 2 | 2018.01.02 | |\n| 2 | 2018.01.03 | 8 |\n| 2 | 2018.01.04 | |\n| 2 | 2018.01.05 | |\n| 2 | 2018.01.06 | 11 |\n\n```\nupdate t set x=x.nullFill(avg(x)) context by id;\nt;\n```\n\n| ID | date | x |\n| -- | ---------- | -------- |\n| 1 | 2018.01.01 | 3.2 |\n| 1 | 2018.01.02 | 5.2 |\n| 1 | 2018.01.03 | 5.266667 |\n| 1 | 2018.01.04 | 7.4 |\n| 1 | 2018.01.05 | 5.266667 |\n| 1 | 2018.01.06 | 5.266667 |\n| 2 | 2018.01.01 | 9.5 |\n| 2 | 2018.01.02 | 9.5 |\n| 2 | 2018.01.03 | 8 |\n| 2 | 2018.01.04 | 9.5 |\n| 2 | 2018.01.05 | 9.5 |\n| 2 | 2018.01.06 | 11 |\n\n例2.矩阵\n\n```\nx=1 NULL 2 NULL 3 4 $ 3:2;\nx;\n```\n\n| #0 | #1 |\n| -- | -- |\n| 1 | |\n| | 3 |\n| 2 | 4 |\n\n```\nx.nullFill(0);\n```\n\n| #0 | #1 |\n| -- | -- |\n| 1 | 0 |\n| 0 | 3 |\n| 2 | 4 |\n\n例3.表\n\n```\nt=table(1..6 as id, 2.1 2.2 NULL NULL 2.4 2.6 as x, 4.3 NULL 3.6 6.7 8.8 NULL as y);\nnullFill(t, -999999);\n```\n\n| id | x | y |\n| -- | ------- | ------- |\n| 1 | 2.1 | 4.3 |\n| 2 | 2.2 | -999999 |\n| 3 | -999999 | 3.6 |\n| 4 | -999999 | 6.7 |\n| 5 | 2.4 | 8.8 |\n| 6 | 2.6 | -999999 |\n\n相关函数:[isNull](https://docs.dolphindb.cn/zh/funcs/i/isNull.html), [hasNull](https://docs.dolphindb.cn/zh/funcs/h/hasNull.html), [bfill](https://docs.dolphindb.cn/zh/funcs/b/bfill.html), [ffill](https://docs.dolphindb.cn/zh/funcs/f/ffill.html), [lfill](https://docs.dolphindb.cn/zh/funcs/l/lfill.html)\n"
|
|
20993
|
+
},
|
|
20994
|
+
"nullFill!": {
|
|
20995
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/n/nullFill_.html",
|
|
20996
|
+
"signatures": [
|
|
20997
|
+
{
|
|
20998
|
+
"full": "nullFill(X, Y)",
|
|
20999
|
+
"name": "nullFill",
|
|
21000
|
+
"parameters": [
|
|
21001
|
+
{
|
|
21002
|
+
"full": "X",
|
|
21003
|
+
"name": "X"
|
|
21004
|
+
},
|
|
21005
|
+
{
|
|
21006
|
+
"full": "Y",
|
|
21007
|
+
"name": "Y"
|
|
21008
|
+
}
|
|
21009
|
+
]
|
|
21010
|
+
}
|
|
21011
|
+
],
|
|
21012
|
+
"markdown": "### [nullFill!](https://docs.dolphindb.cn/zh/funcs/n/nullFill_.html)\n\n是 [nullFill](https://docs.dolphindb.cn/zh/funcs/n/nullFill.html) 的别名。\n\nnullFill! 是 函数原地修改版本,它会改变输入对象的值。\n\n\n以下是 `nullFill` 函数的文档:\n### [nullFill](https://docs.dolphindb.cn/zh/funcs/n/nullFill.html)\n\n\n\n#### 语法\n\nnullFill(X, Y)\n\n#### 参数\n\n**X** 可以是向量、矩阵或表。\n\n**Y** 可以是一个标量,也可以是与 *X* 长度相同的向量或矩阵。\n\n#### 详情\n\n如果 *X* 是一个向量或矩阵:\n\n* 如果 *Y* 是标量,使用 *Y* 填充 *X* 中的 NULL 值。\n\n* 如果 *Y* 是一个与 *X* 等长的向量或矩阵,使用 *Y* 中与 *X* 的 NULL 值对应位置的元素替换 *X* 中的 NULL 值。\n\n如果 *X* 是一个表,那么 *Y* 只能是一个标量,使用 *Y* 填充表中的 NULL 值。注意,填充 NULL 值时,系统会尝试将 *Y* 进行类型转换。如果 *Y* 不能转换为表中某列的类型,系统会抛出异常。\n\n`nullFill` 不改变输入对象的值;`nullFill!` 会改变输入对象的值。\n\n#### 例子\n\n例1.向量\n\n```\nx=1 NULL NULL 6 NULL 7;\nnullFill(x,0);\n// output\n[1,0,0,6,0,7]\n\ny=1..6\nnullFill(x,y);\n// output\n[1,2,3,6,5,7]\n```\n\n在 SQL 语句中对表中的一列使用 `nullFill` 函数:\n\n```\nID=take(1,6) join take(2,6)\ndate=take(2018.01.01..2018.01.06, 12)\nx=3.2 5.2 NULL 7.4 NULL NULL NULL NULL 8 NULL NULL 11\nt=table(ID, date, x)\nt;\n```\n\n| ID | date | x |\n| -- | ---------- | --- |\n| 1 | 2018.01.01 | 3.2 |\n| 1 | 2018.01.02 | 5.2 |\n| 1 | 2018.01.03 | |\n| 1 | 2018.01.04 | 7.4 |\n| 1 | 2018.01.05 | |\n| 1 | 2018.01.06 | |\n| 2 | 2018.01.01 | |\n| 2 | 2018.01.02 | |\n| 2 | 2018.01.03 | 8 |\n| 2 | 2018.01.04 | |\n| 2 | 2018.01.05 | |\n| 2 | 2018.01.06 | 11 |\n\n```\nupdate t set x=x.nullFill(avg(x)) context by id;\nt;\n```\n\n| ID | date | x |\n| -- | ---------- | -------- |\n| 1 | 2018.01.01 | 3.2 |\n| 1 | 2018.01.02 | 5.2 |\n| 1 | 2018.01.03 | 5.266667 |\n| 1 | 2018.01.04 | 7.4 |\n| 1 | 2018.01.05 | 5.266667 |\n| 1 | 2018.01.06 | 5.266667 |\n| 2 | 2018.01.01 | 9.5 |\n| 2 | 2018.01.02 | 9.5 |\n| 2 | 2018.01.03 | 8 |\n| 2 | 2018.01.04 | 9.5 |\n| 2 | 2018.01.05 | 9.5 |\n| 2 | 2018.01.06 | 11 |\n\n例2.矩阵\n\n```\nx=1 NULL 2 NULL 3 4 $ 3:2;\nx;\n```\n\n| #0 | #1 |\n| -- | -- |\n| 1 | |\n| | 3 |\n| 2 | 4 |\n\n```\nx.nullFill(0);\n```\n\n| #0 | #1 |\n| -- | -- |\n| 1 | 0 |\n| 0 | 3 |\n| 2 | 4 |\n\n例3.表\n\n```\nt=table(1..6 as id, 2.1 2.2 NULL NULL 2.4 2.6 as x, 4.3 NULL 3.6 6.7 8.8 NULL as y);\nnullFill(t, -999999);\n```\n\n| id | x | y |\n| -- | ------- | ------- |\n| 1 | 2.1 | 4.3 |\n| 2 | 2.2 | -999999 |\n| 3 | -999999 | 3.6 |\n| 4 | -999999 | 6.7 |\n| 5 | 2.4 | 8.8 |\n| 6 | 2.6 | -999999 |\n\n相关函数:[isNull](https://docs.dolphindb.cn/zh/funcs/i/isNull.html), [hasNull](https://docs.dolphindb.cn/zh/funcs/h/hasNull.html), [bfill](https://docs.dolphindb.cn/zh/funcs/b/bfill.html), [ffill](https://docs.dolphindb.cn/zh/funcs/f/ffill.html), [lfill](https://docs.dolphindb.cn/zh/funcs/l/lfill.html)\n"
|
|
21013
|
+
},
|
|
21014
|
+
"nunique": {
|
|
21015
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/n/nunique.html",
|
|
21016
|
+
"signatures": [
|
|
21017
|
+
{
|
|
21018
|
+
"full": "nunique(X, [ignoreNull=false])",
|
|
21019
|
+
"name": "nunique",
|
|
21020
|
+
"parameters": [
|
|
21021
|
+
{
|
|
21022
|
+
"full": "X",
|
|
21023
|
+
"name": "X"
|
|
21024
|
+
},
|
|
21025
|
+
{
|
|
21026
|
+
"full": "[ignoreNull=false]",
|
|
21027
|
+
"name": "ignoreNull",
|
|
21028
|
+
"optional": true,
|
|
21029
|
+
"default": "false"
|
|
21030
|
+
}
|
|
21031
|
+
]
|
|
21032
|
+
}
|
|
21033
|
+
],
|
|
21034
|
+
"markdown": "### [nunique](https://docs.dolphindb.cn/zh/funcs/n/nunique.html)\n\n\n\n#### 语法\n\nnunique(X, \\[ignoreNull=false])\n\n#### 参数\n\n**X** 是一个向量/数组向量,或包含多个等长向量的元组。\n\n**ignoreNull** 是一个布尔值,表示是否忽略 *X*中 NULL 值。若指定 *ignoreNull*=true,则统计唯一值时将不考虑 NULL 值;否则将会统计 NULL 值。默认值为 false。请注意,当 *X* 是元组或数组向量时,不可指定 *ignoreNull*=true。\n\n#### 详情\n\n*X* 是向量/数组向量时,计算 *X* 中唯一值的数量。\n\n*X* 是元组时,其内每个向量位于相同位置的元素组成一个 key,计算唯一 key 的数量。\n\n#### 例子\n\n```\nv = [1,3,1,-6,NULL,2,NULL,1];\nnunique(v);\n// output: 5\n\n//指定 ignorNull = true,统计唯一值时将不考虑 NULL 值\nnunique(v,true);\n// output: 4\n\na = array\\(INT\\[\\], 0, 10\\).append!\\(\\[1 2 3, 3 5, 6 8 8, 9 10\\]\\)\nnunique\\(a\\)\n// output: 8\n```\n\n```\nt=table(1 2 4 8 4 2 7 1 as id, 10 20 40 80 40 20 70 10 as val);\nselect nunique([id,val]) from t;\n```\n\n| nunique |\n| ------- |\n| 5 |\n\n```\ndbName = \"dfs://testdb\"\nif(existsDatabase(dbName)){\n dropDatabase(dbName)\n}\n\ndb=database(\"dfs://testdb\", VALUE, 2012.01.11..2012.01.29)\n\nn=100\nt=table(take(2012.01.11..2012.01.29, n) as date, symbol(take(\"A\"+string(21..60), n)) as sym, take(100, n) as val)\n\npt=db.createPartitionedTable(t, `pt, `date).append!(t)\nselect nunique(date) from pt group by sym\n```\n"
|
|
21035
|
+
},
|
|
21036
|
+
"objByName": {
|
|
21037
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/o/objByName.html",
|
|
21038
|
+
"signatures": [
|
|
21039
|
+
{
|
|
21040
|
+
"full": "objByName(name, [sharedVar])",
|
|
21041
|
+
"name": "objByName",
|
|
21042
|
+
"parameters": [
|
|
21043
|
+
{
|
|
21044
|
+
"full": "name",
|
|
21045
|
+
"name": "name"
|
|
21046
|
+
},
|
|
21047
|
+
{
|
|
21048
|
+
"full": "[sharedVar]",
|
|
21049
|
+
"name": "sharedVar",
|
|
21050
|
+
"optional": true
|
|
21051
|
+
}
|
|
21052
|
+
]
|
|
21053
|
+
}
|
|
21054
|
+
],
|
|
21055
|
+
"markdown": "### [objByName](https://docs.dolphindb.cn/zh/funcs/o/objByName.html)\n\n\n\n#### 语法\n\nobjByName(name, \\[sharedVar])\n\n#### 参数\n\n**name** 是一个字符串,表示表名。\n\n**sharedVar** 是一个布尔值。\n\n#### 详情\n\nDolphinDB 在执行脚本之前先解析脚本。解析脚本的过程是检查变量是否在本地定义。如果没有在本地定义,则抛出异常。\n\n假设我们在本地定义一个函数,然后在远程节点上执行。这个函数会查询共享表。但是,共享表在远程节点上而不在本地节点上。如果在函数的 SQL 语句中直接调用表名,系统将不能解析脚本。\n\n为了解决这个问题,系统函数 `objByName` 在执行时会根据名称返回对象。\n\n如果没有指定 *sharedVar* 参数,系统首先搜索会话中的局部变量,再搜索共享变量。如果 *sharedVar* 为true,表示只搜索共享变量。如果 *sharedVar* 为false,表示只搜索局部变量。\n\n#### 例子\n\n假设在本地节点上有一个表 EarningsDates,它包含两列:Ticker 和 date。主机名为localhost 服务器的 8081 端口上的远程节点有一个表 USPrices。它包含所有美国股票的每日价格。我们想要从远程节点取得 EarningsDates 表中所有股票在公布收益后一周的价格。\n\n在远程节点,导入数据文件创建表 USPrices,然后在所有节点间共享。\n\n```\nUSPrices = loadText(\"c:/DolphinDB/Data/USPrices.csv\")\nshare USPrices as sharedUSPrices;\n```\n\n在本地节点,创建表 EarningsDates,然后把表和脚本发送到远程节点。执行完成后,结果会发送回本地节点。\n\n```\nEarningsDates=table(`XOM`AAPL`IBM as TICKER, 2006.10.26 2006.10.19 2006.10.17 as date)\ndef loadDailyPrice(data){\n dateDict = dict(data.TICKER, data.date)\n return select date, TICKER, PRC from objByName(\"sharedUSPrices\") where dateDict[TICKER]<date<=dateDict[TICKER]+7\n}\nconn = xdb(\"localhost\",8081)\nprices = conn(loadDailyPrice, EarningsDates);\n\nprices;\n```\n\n| date | TICKER | PRC |\n| ---------- | ------ | ----- |\n| 2006.10.27 | XOM | 71.46 |\n| 2006.10.30 | XOM | 70.84 |\n| 2006.10.31 | XOM | 71.42 |\n| 2006.11.01 | XOM | 71.06 |\n| 2006.11.02 | XOM | 71.19 |\n| 2006.10.18 | IBM | 89.82 |\n| 2006.10.19 | IBM | 89.86 |\n| 2006.10.20 | IBM | 90.48 |\n| 2006.10.23 | IBM | 91.56 |\n| 2006.10.24 | IBM | 91.49 |\n| 2006.10.20 | AAPL | 79.95 |\n| 2006.10.23 | AAPL | 81.46 |\n| 2006.10.24 | AAPL | 81.05 |\n| 2006.10.25 | AAPL | 81.68 |\n| 2006.10.26 | AAPL | 82.19 |\n"
|
|
21056
|
+
},
|
|
21057
|
+
"objectChecksum": {
|
|
21058
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/o/objectChecksum.html",
|
|
21059
|
+
"signatures": [
|
|
21060
|
+
{
|
|
21061
|
+
"full": "objectChecksum(vector, [prev])",
|
|
21062
|
+
"name": "objectChecksum",
|
|
21063
|
+
"parameters": [
|
|
21064
|
+
{
|
|
21065
|
+
"full": "vector",
|
|
21066
|
+
"name": "vector"
|
|
21067
|
+
},
|
|
21068
|
+
{
|
|
21069
|
+
"full": "[prev]",
|
|
21070
|
+
"name": "prev",
|
|
21071
|
+
"optional": true
|
|
21072
|
+
}
|
|
21073
|
+
]
|
|
21074
|
+
}
|
|
21075
|
+
],
|
|
21076
|
+
"markdown": "### [objectChecksum](https://docs.dolphindb.cn/zh/funcs/o/objectChecksum.html)\n\n\n\n#### 语法\n\nobjectChecksum(vector, \\[prev])\n\n#### 参数\n\n**vector** 向量。用于进行校验和(checksum)计算。\n\n**prev** 整数。当 *vector* 过长时,可以通过指定 *prev* 分段迭代求完整的校验和,*prev* 表示迭代时前一段数据的校验和。\n\n#### 详情\n\n计算向量的校验和,返回一个整数。通常用于校验数据的完整性。\n\n#### 例子\n\n```\nprint objectChecksum(take(`A`B`C, 10))\n// output\n-268298654\n\nprint objectChecksum(2.3 6.5 7.8)\n// output\n-430996932\n\n// 分段计算校验和\nprint objectChecksum(1..15)\n// output\n-1877567753\n\nt0 = objectChecksum(1..5)\nt1 = objectChecksum(6..10, t0)\nt2 = objectChecksum(11..15, t1)\nprint t2\n// output\n-1877567753\n```\n"
|
|
21077
|
+
},
|
|
21078
|
+
"objs": {
|
|
21079
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/o/objs.html",
|
|
21080
|
+
"signatures": [
|
|
21081
|
+
{
|
|
21082
|
+
"full": "objs([shared=false])",
|
|
21083
|
+
"name": "objs",
|
|
21084
|
+
"parameters": [
|
|
21085
|
+
{
|
|
21086
|
+
"full": "[shared=false]",
|
|
21087
|
+
"name": "shared",
|
|
21088
|
+
"optional": true,
|
|
21089
|
+
"default": "false"
|
|
21090
|
+
}
|
|
21091
|
+
]
|
|
21092
|
+
}
|
|
21093
|
+
],
|
|
21094
|
+
"markdown": "### [objs](https://docs.dolphindb.cn/zh/funcs/o/objs.html)\n\n\n\n#### 语法\n\nobjs(\\[shared=false])\n\n#### 参数\n\n**shared** 布尔值,默认为 false。\n\n* false:返回当前会话中所有变量的信息;\n\n* true:返回当前会话中所有变量的信息以及所有会话共享的变量信息;\n\n#### 详情\n\n用于获取内存中缓存的各变量的内存占用情况等信息。返回一个表,它具有以下几列:\n\n* name: 变量名。\n\n* type: 变量的数据类型。\n\n* form: 变量的数据形式。\n\n* rows:\n\n * 若 form 为向量/字典/集合,则返回所有元素(包含 NULL)的个数\n\n * 若 form 为矩阵/表,则返回它们的行数\n\n* columns:\n\n * 若 form 为向量/字典/集合,则返回 1\n\n * 若 form 为矩阵/表,则返回它们的列数\n\n* bytes: 变量占用的内存大小,单位为字节\n\n* shared: 是否为共享变量\n\n* extra: 分布式表的逻辑路径,格式为 `\"dfs://dbName/tableName\"`\n\n* owner:共享变量的创建者。只有设置 shared=true 时才会显示该字段。对于本地变量,此字段值为空。\n\n注意,该函数不返回函数定义。我们应该用 defs 检查函数定义,或通过 [memSize](https://docs.dolphindb.cn/zh/funcs/m/memSize.html) 查看函数定义的内存占用。\n\n#### 例子\n\n```\n// 创建分布式数据库\nif(existsDatabase(\"dfs://listdb\")){\n dropDatabase(\"dfs://listdb\")\n}\nn=1000000\nticker = rand(`MSFT`GOOG`FB`ORCL`IBM,n);\nticker[0..5]\nx=rand(1.0, n)\nt=table(ticker, x)\ndb=database(directory=\"dfs://listdb\", partitionType=HASH, partitionScheme=[STRING, 5])\npt=db.createPartitionedTable(t, `pt, `ticker)\npt.append!(t)\n\n// 共享内存表\ntime = take(2021.08.20 00:00:00..2021.08.30 00:00:00, 40);\nid = 0..39;\nvalue = rand(100, 40);\ntmp = table(time, id, value);\nshare tmp as st\n\n// 创建 set\ns = set([1,2,3,4,5])\n\n// 创建 dict\nx=1 2 3\ny=4.5 7.8 4.3\nz=dict(x,y);\n\n// 创建 matrix\nm = matrix(1 2 3, 4 5 6)\n\n// 创建 pair\np = 1:2\n```\n\n```\nobjs(true)\n```\n\n| name | type | form | rows | columns | bytes | shared | extra | owner |\n| ------ | -------- | ---------- | --------- | ------- | ---------- | ------ | ---------------- | ----- |\n| n | INT | SCALAR | 1 | 1 | 16 | false | | |\n| ticker | SYMBOL | VECTOR | 1,000,000 | 1 | 4,000,000 | false | | |\n| x | INT | VECTOR | 3 | 1 | 12 | false | | |\n| t | BASIC | TABLE | 1,000,000 | 2 | 12,000,312 | false | | |\n| db | HANDLE | SCALAR | 1 | 1 | 24 | false | | |\n| pt | ALIAS | TABLE | 0 | 2 | 12,000,000 | false | dfs\\://listdb/pt | |\n| time | DATETIME | VECTOR | 40 | 1 | 160 | false | | |\n| id | INT | VECTOR | 40 | 1 | 160 | false | | |\n| value | INT | VECTOR | 40 | 1 | 160 | false | | |\n| tmp | BASIC | TABLE | 40 | 3 | 832 | false | | |\n| s | INT | SET | 5 | 1 | 28 | false | | |\n| y | DOUBLE | VECTOR | 3 | 1 | 24 | false | | |\n| z | DOUBLE | DICTIONARY | 3 | 1 | 199 | false | | |\n| m | INT | MATRIX | 3 | 2 | 24 | false | | |\n| p | INT | PAIR | 2 | 1 | 8 | false | | |\n| st | BASIC | TABLE | 40 | 3 | 832 | true | | admin |\n"
|
|
21095
|
+
},
|
|
21096
|
+
"ols": {
|
|
21097
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/o/ols.html",
|
|
21098
|
+
"signatures": [
|
|
21099
|
+
{
|
|
21100
|
+
"full": "ols(Y, X, [intercept=true], [mode=0], [method=\"default\"], [usePinv=true])",
|
|
21101
|
+
"name": "ols",
|
|
21102
|
+
"parameters": [
|
|
21103
|
+
{
|
|
21104
|
+
"full": "Y",
|
|
21105
|
+
"name": "Y"
|
|
21106
|
+
},
|
|
21107
|
+
{
|
|
21108
|
+
"full": "X",
|
|
21109
|
+
"name": "X"
|
|
21110
|
+
},
|
|
21111
|
+
{
|
|
21112
|
+
"full": "[intercept=true]",
|
|
21113
|
+
"name": "intercept",
|
|
21114
|
+
"optional": true,
|
|
21115
|
+
"default": "true"
|
|
21116
|
+
},
|
|
21117
|
+
{
|
|
21118
|
+
"full": "[mode=0]",
|
|
21119
|
+
"name": "mode",
|
|
21120
|
+
"optional": true,
|
|
21121
|
+
"default": "0"
|
|
21122
|
+
},
|
|
21123
|
+
{
|
|
21124
|
+
"full": "[method=\"default\"]",
|
|
21125
|
+
"name": "method",
|
|
21126
|
+
"optional": true,
|
|
21127
|
+
"default": "\"default\""
|
|
21128
|
+
},
|
|
21129
|
+
{
|
|
21130
|
+
"full": "[usePinv=true]",
|
|
21131
|
+
"name": "usePinv",
|
|
21132
|
+
"optional": true,
|
|
21133
|
+
"default": "true"
|
|
21138
21134
|
}
|
|
21139
21135
|
]
|
|
21140
21136
|
}
|
|
21141
21137
|
],
|
|
21142
|
-
"markdown": "### [
|
|
21138
|
+
"markdown": "### [ols](https://docs.dolphindb.cn/zh/funcs/o/ols.html)\n\n\n\n#### 语法\n\nols(Y, X, \\[intercept=true], \\[mode=0], \\[method=\"default\"], \\[usePinv=true])\n\n#### 参数\n\n**Y** 是因变量;**X** 是自变量。\n\n**Y** 是一个向量;**X** 是一个向量、元组、矩阵或表。当 *X* 是矩阵时,如果行数等于 *Y* 的长度,*X* 的每一列都是一个因子;如果行数不等于 *Y* 的长度,并且如果列数等于 *Y* 的长度,*X* 的每一行都是一个因子。\n\n**intercept** 是一个布尔变量,表示是否包含回归中的截距。默认值是 true。当它为 true 时,系统自动给 *X* 添加一列 \"1\" 以生成截距。\n\n**mode** 是一个整数,默认值为 0,可取以下 3 个值\n\n* 0:输出一个系数估计向量\n\n* 1:输出一个具有系数估计,标准差,t 统计量和 p 值的表\n\n* 2:输出一个具有 ANOVA(方差分析)、RegressionStat(回归统计)、Cofficient(系数))和 Residual(残差))的字典,具体含义见下表:\n\n键 ANOVA 对应值:\n\n| Source of Variance | 自由度(Degree of freedom) | 平方和(Sum of Square) | 均方差(Mean of square) | F统计量 | Significance |\n| ------------------ | ---------------------- | ------------------ | ------------------- | ------------- | ------------- |\n| Regression(回归) | 变量个数(p) | 回归平方和(SSR) | 回归均方差(MSR=SSR/R) | MSR 对 MSE 的比值 | 显著性,即统计出的 P 值 |\n| Residual(残差) | 残差自由度(n-p-1) | 残差平方和(SSE) | 残差均方差(MSE=MSE/E) | | |\n| Total | 样本自由度 | | | | |\n| 不包括常数项(n-1) | 总离差平方和(SST) | | | | |\n\n键 RegressionStat 对应值:\n\n| item | 统计值 |\n| ------------ | ---------------------------------------------------------------- |\n| R2 | R 决定系数,描述回归曲线对真实数据点拟合程度的统计量。范围在 \\[0,1]之间,越接近1 ,说明对y的解释能力越强,拟合越好。 |\n| AdjustedR2 | 经自由度修正后的决定系数,通过样本数量与模型数量对 R-squared 进行修正。 |\n| StdError | 回归残差标准误差,残差经自由度修正后的标准差。 |\n| Observations | 观察样本个数。 |\n\n键 Coefficient 对应值:\n\n| 元素 | 说明 |\n| -------- | ---------------- |\n| factor | 自变量名称 |\n| beta | 回归系数估计值 |\n| stdError | 回归系数标准误差。 |\n| tstat | T统计值,衡量系数的统计显著性。 |\n\n键 Residual 对应每一个预测值和实际值之间的残差。\n\n**method**是一个字符串,表示求解最小二乘问题采用的方法。\n\n* 默认值为“default”,表示采用构造系数矩阵和逆矩阵的方式求解;\n\n* 设置为“svd”,采用奇异值分解的方式。\n\n**usePinv**一个布尔值,表示计算过程中求矩阵的逆时,是否求矩阵的伪逆。\n\n* 默认值为 true,表示求矩阵的伪逆,奇异矩阵必须指定为 true。\n\n* 若为 false,表示求矩阵的逆,只适用于非奇异矩阵。\n\n#### 详情\n\n返回对 *X* 和 *Y* 计算普通最小二乘回归的结果。需要注意的是,该函数会将 *X* 和 *Y* 中的空值替换为0后进行计算。\n\n#### 例子\n\n```\nx1=1 3 5 7 11 16 23\nx2=2 8 11 34 56 54 100\ny=0.1 4.2 5.6 8.8 22.1 35.6 77.2;\n\nols(y, x1);\n// output\n[-9.912821,3.378632]\n\nols(y, (x1,x2));\n// output\n[-9.494813,2.806426,0.13147]\n```\n\n```\nols(y, (x1,x2), 1, 1);\n```\n\n| factor | beta | stdError | tstat | pvalue |\n| --------- | --------- | -------- | --------- | -------- |\n| intercept | -9.494813 | 5.233168 | -1.814353 | 0.143818 |\n| x1 | 2.806426 | 1.830782 | 1.532911 | 0.20007 |\n| x2 | 0.13147 | 0.409081 | 0.321379 | 0.764015 |\n\n```\nols(y, (x1,x2), 1, 2);\n// output\nCoefficient->\nfactor beta stdError tstat pvalue\n--------- --------- -------- --------- --------\nintercept -9.494813 5.233168 -1.814353 0.143818\nx1 2.806426 1.830782 1.532911 0.20007\nx2 0.13147 0.409081 0.321379 0.764015\n\nResidual->[6.525447,4.223774,-0.383487,-5.820153,-6.638199,-6.907387,9.000005]\nRegressionStat->\nitem statistics\n------------ ----------\nR2 0.940241\nAdjustedR2 0.910361\nStdError 8.173444\nObservations 7\n\nANOVA->\nBreakdown DF SS MS F Significance\n---------- -- ----------- ----------- --------- ------------\nRegression 2 4204.416396 2102.208198 31.467739 0.003571\nResidual 4 267.220747 66.805187\nTotal 6 4471.637143\n```\n\n```\nx=matrix(1 4 8 2 3, 1 4 2 3 8, 1 5 1 1 5);\nx;\n```\n\n| #0 | #1 | #2 |\n| -- | -- | -- |\n| 1 | 1 | 1 |\n| 4 | 4 | 5 |\n| 8 | 2 | 1 |\n| 2 | 3 | 1 |\n| 3 | 8 | 5 |\n\n```\nols(1..5, x);\n// output\n[1.156537,0.105505,0.91055,-0.697821]\n\nols(1..5, x.transpose());\n// output\n[1.156537,0.105505,0.91055,-0.697821]\n// 系统会调整因变量和自变量的维数,以便进行回归\n```\n\n```\nx = table([13.9782,13.4688,13.4336,12.9642,12.7905,13.4771,13.0423,12.6588,13.8933,13.9006] as col0, [195.3904,181.4090,180.4627,168.0723,163.5973,181.6342,170.1017,160.2477,193.0241,193.2270] as col1, [2731.2089,2443.3656,2424.2715,2178.9356,2092.4947,2447.9167,2218.5185,2028.5594,2681.7456,2685.9754] as col2)\ny = [-0.4002,-0.8004,-0.2002,-1.0002,-0.2001,-0.5001,-0.2501,0.0000,0.0000,0.0000]\n\nols(y, x, true, 0, \"default\")\n[2.968166,13.023638,-2.016390,0.076485]\n\nols(y, x, true, 0, \"svd\")\n[3266.457957,-722.195120,53.157806,-1.302769]\n```\n\n```\nx1=1 1 1\nx2=2 2 2\ny = 1 1 1\nols(y, (x1, x2))\n// output:[0.16666666666666669\t0.16666666666666669\t0.33333333333333326]\nols(y, (x1, x2), usePinv=false) \n// ERR: The input matrix is singular and cannot be inverted.\n```\n\n由于在求解过程中,参与求逆的矩阵是奇异的,因此 usePinv=false 时报错。\n"
|
|
21143
21139
|
},
|
|
21144
|
-
"
|
|
21145
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/
|
|
21140
|
+
"olsEx": {
|
|
21141
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/o/olsEx.html",
|
|
21146
21142
|
"signatures": [
|
|
21147
21143
|
{
|
|
21148
|
-
"full": "
|
|
21149
|
-
"name": "
|
|
21144
|
+
"full": "olsEx(ds, Y, X, [intercept=true], [mode=0])",
|
|
21145
|
+
"name": "olsEx",
|
|
21150
21146
|
"parameters": [
|
|
21151
21147
|
{
|
|
21152
|
-
"full": "
|
|
21153
|
-
"name": "
|
|
21148
|
+
"full": "ds",
|
|
21149
|
+
"name": "ds"
|
|
21154
21150
|
},
|
|
21155
21151
|
{
|
|
21156
|
-
"full": "
|
|
21157
|
-
"name": "
|
|
21152
|
+
"full": "Y",
|
|
21153
|
+
"name": "Y"
|
|
21158
21154
|
},
|
|
21159
21155
|
{
|
|
21160
|
-
"full": "
|
|
21161
|
-
"name": "
|
|
21156
|
+
"full": "X",
|
|
21157
|
+
"name": "X"
|
|
21158
|
+
},
|
|
21159
|
+
{
|
|
21160
|
+
"full": "[intercept=true]",
|
|
21161
|
+
"name": "intercept",
|
|
21162
21162
|
"optional": true,
|
|
21163
|
-
"default": "
|
|
21163
|
+
"default": "true"
|
|
21164
|
+
},
|
|
21165
|
+
{
|
|
21166
|
+
"full": "[mode=0]",
|
|
21167
|
+
"name": "mode",
|
|
21168
|
+
"optional": true,
|
|
21169
|
+
"default": "0"
|
|
21164
21170
|
}
|
|
21165
21171
|
]
|
|
21166
21172
|
}
|
|
21167
21173
|
],
|
|
21168
|
-
"markdown": "### [
|
|
21174
|
+
"markdown": "### [olsEx](https://docs.dolphindb.cn/zh/funcs/o/olsEx.html)\n\n\n\n#### 语法\n\nolsEx(ds, Y, X, \\[intercept=true], \\[mode=0])\n\n#### 参数\n\n**ds** 是存储在元组中的数据源集合。它通常是由 [sqlDS](https://docs.dolphindb.cn/zh/funcs/s/sqlDS.html) 函数生成。\n\n**Y** 是一个字符串,表示 *ds* 表中因变量的列名。\n\n**X** 是字符串标量或向量,表示 *ds* 表中自变量的列名。\n\n**intercept** 是一个布尔变量,指示是否包含回归中的截距。默认值是 true。当它为 true 时,系统自动给 *X* 添加一列 \"1\" 以生成截距。\n\n**mode** 是一个整数,默认值为 0,取以下 3 个值之一\n\n* 0:输出一个系数估计向量\n\n* 1:输出一个具有系数估计,标准差,t统计量和p值的表\n\n* 2:输出一个具有 ANOVA(方差分析)、RegressionStat(回归统计)和 Cofficient(系数)的字典,具体含义见下表:\n\n键 ANOVA 对应值:\n\n| Source of Variance | 自由度(Degree of freedom) | 平方和(Sum of Square) | 均方差(Mean of square) | F 统计量 | Significance |\n| ------------------ | ---------------------- | ------------------ | ------------------- | ------------- | ------------ |\n| Regression(回归) | 变量个数(p) | 回归平方和(SSR) | 回归均方差(MSR=SSR/R) | MSR 对 MSE 的比值 | 显著性,即统计出的P值 |\n| Residual(残差) | 残差自由度(n-p-1) | 残差平方和(SSE) | 残差均方差(MSE=MSE/E) | | |\n| Total | 样本自由度 | | | | |\n| 不包括常数项(n-1) | 总离差平方和(SST) | | | | |\n\n键RegressionStat对应值:\n\n| item | 统计值 |\n| ------------ | ---------------------------------------------------------------- |\n| R2 | R 决定系数,描述回归曲线对真实数据点拟合程度的统计量。范围在 \\[0,1]之间,越接近1 ,说明对y的解释能力越强,拟合越好。 |\n| AdjustedR2 | 经自由度修正后的决定系数,通过样本数量与模型数量对 R-squared 进行修正。 |\n| StdError | 回归残差标准误差,残差经自由度修正后的标准差。 |\n| Observations | 观察样本个数。 |\n\n键Coefficient对应值:\n\n| 元素 | 说明 |\n| -------- | ---------------------------- |\n| factor | 自变量名称 |\n| beta | 回归系数估计值 |\n| stdError | 回归系数标准误差。标准差越大,回归系数的估计值越不靠谱。 |\n| tstat | T 统计值,衡量系数的统计显著性。 |\n\n#### 详情\n\n返回对 *X* 和 *Y* 计算普通最小二乘回归的结果。*X* 和 *Y* 是分布式表中的列。\n\n**Note:**\n\n* 该函数会将 *X* 和 *Y* 中的空值替换为0后进行计算。\n\n* 因为`olsEX` 不支持输出残差,可以通过 [residual](https://docs.dolphindb.cn/zh/funcs/r/residual.html) 获取残差。\n\n#### 例子\n\n```\nn=10000\nID=rand(100, n)\ndates=2017.08.07..2017.08.11\ndate=rand(dates, n)\nvol=rand(1..10 join int(), n)\nprice=rand(100,n)\nt=table(ID, date, vol,price)\nsaveText(t, \"/home/DolphinDB/Data/t.txt\");\nif(existsDatabase(\"dfs://rangedb\")){\n dropDatabase(\"dfs://rangedb\")\n}\ndb = database(directory=\"dfs://rangedb\", partitionType=RANGE, partitionScheme=0 51 101)\nUSPrices=loadTextEx(dbHandle=db,tableName=`USPrices, partitionColumns=`ID, filename=\"/home/DolphinDB/Data/t.txt\");\n\nds=sqlDS(<select vol as VS, price as SBA from USPrices where vol>5>)\nrs=olsEx(ds, `VS, `SBA, true, 2)\nrs;\n\n// output\nRegressionStat->\nitem statistics\n------------ ----------\nR2 0.000848\nAdjustedR2 0.000628\nStdError 1.404645\nObservations 4535\n\nANOVA->\nBreakdown DF SS MS F Significance\n---------- ---- ----------- -------- -------- ------------\nRegression 1 7.592565 7.592565 3.848178 0.049861\nResidual 4533 8943.739298 1.973029\nTotal 4534 8951.331863\n\nCoefficient->\nfactor beta stdError tstat pvalue\n--------- -------- -------- ---------- --------\nintercept 7.953084 0.04185 190.039423 0\nSBA 0.001422 0.000725 1.961677 0.049861\n```\n"
|
|
21169
21175
|
},
|
|
21170
|
-
"
|
|
21171
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/
|
|
21176
|
+
"oneHot": {
|
|
21177
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/o/oneHot.html",
|
|
21172
21178
|
"signatures": [
|
|
21173
21179
|
{
|
|
21174
|
-
"full": "
|
|
21175
|
-
"name": "
|
|
21180
|
+
"full": "oneHot(obj, encodingColumns)",
|
|
21181
|
+
"name": "oneHot",
|
|
21176
21182
|
"parameters": [
|
|
21177
21183
|
{
|
|
21178
|
-
"full": "
|
|
21179
|
-
"name": "
|
|
21184
|
+
"full": "obj",
|
|
21185
|
+
"name": "obj"
|
|
21180
21186
|
},
|
|
21181
21187
|
{
|
|
21182
|
-
"full": "
|
|
21183
|
-
"name": "
|
|
21188
|
+
"full": "encodingColumns",
|
|
21189
|
+
"name": "encodingColumns"
|
|
21184
21190
|
}
|
|
21185
21191
|
]
|
|
21186
21192
|
}
|
|
21187
21193
|
],
|
|
21188
|
-
"markdown": "### [
|
|
21194
|
+
"markdown": "### [oneHot](https://docs.dolphindb.cn/zh/funcs/o/oneHot.html)\n\n\n\n#### 语法\n\noneHot(obj, encodingColumns)\n\n#### 参数\n\n**obj** 是一个内存表。\n\n**encodingColumns** 是一个字符串或者字符串向量,指定用于编码的列名。\n\n#### 详情\n\n对指定的列进行独热编码(one-hot),返回编码后的表,列的顺序为编码列,非编码列。其中,编码列的列名格式为:原字段名\\_值。\n\n#### 例子\n\n```\nt = table( take(`Tom`Lily`Jim, 10) as name, take(true false, 10) as gender, take(21..23,10) as age);\noneHot(t, `name`gender);\n```\n\n输出返回:\n\n| name\\_Tom | name\\_Lily | name\\_Jim | gender\\_1 | gender\\_0 | age |\n| --------- | ---------- | --------- | --------- | --------- | --- |\n| 1 | 0 | 0 | 1 | 0 | 21 |\n| 0 | 1 | 0 | 0 | 1 | 22 |\n| 0 | 0 | 1 | 1 | 0 | 23 |\n| 1 | 0 | 0 | 0 | 1 | 21 |\n| 0 | 1 | 0 | 1 | 0 | 22 |\n| 0 | 0 | 1 | 0 | 1 | 23 |\n| 1 | 0 | 0 | 1 | 0 | 21 |\n| 0 | 1 | 0 | 0 | 1 | 22 |\n| 0 | 0 | 1 | 1 | 0 | 23 |\n| 1 | 0 | 0 | 0 | 1 | 21 |\n"
|
|
21189
21195
|
},
|
|
21190
|
-
"
|
|
21191
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/
|
|
21196
|
+
"or": {
|
|
21197
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/o/or.html",
|
|
21192
21198
|
"signatures": [
|
|
21193
21199
|
{
|
|
21194
|
-
"full": "
|
|
21195
|
-
"name": "
|
|
21200
|
+
"full": "or(X, Y)",
|
|
21201
|
+
"name": "or",
|
|
21196
21202
|
"parameters": [
|
|
21197
21203
|
{
|
|
21198
21204
|
"full": "X",
|
|
@@ -21205,49 +21211,43 @@
|
|
|
21205
21211
|
]
|
|
21206
21212
|
}
|
|
21207
21213
|
],
|
|
21208
|
-
"markdown": "### [
|
|
21214
|
+
"markdown": "### [or](https://docs.dolphindb.cn/zh/funcs/o/or.html)\n\n\n\n#### 语法\n\nor(X, Y) 或 X||Y\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、数据对、向量或矩阵。\n\n#### 详情\n\n按元素逐个返回 *X* 逻辑或 `(OR)Y`的结果。\n\n注意:若 `or` 或 `||` 的操作数包含 NULL 时,|| 返回的对应结果为 NULL,而 `or` 针对不同 server 版本,返回的结果不同。\n\n* 对于小于 2.00.9.4 的版本,`or` 返回的对应结果为 NULL。\n\n* 对于 2.00.9.4 及以上版本,`or` 返回的结果由配置项 *logicOrIgnoreNull* 控制,见下表:\n\n| 操作数 | 操作数 | 返回值(*logicOrIgnoreNull*= true 时) | 返回值(*logicOrIgnoreNull*= false 时) |\n| ---- | ---- | -------------------------------- | --------------------------------- |\n| 非零 | NULL | true | NULL |\n| 零 | NULL | true | NULL |\n| NULL | NULL | true | NULL |\n\n#### 例子\n\n```\n1 || 0;\n```\n\n输出返回:true\n\n```\nx=1 0 1;\nx || 0;\n```\n\n输出返回:\\[true,false,true]\n\n```\ny=0 1 0;\nx or y;\n```\n\n输出返回:\\[true,true,true]\n\n```\nt=table(1..3 as id, 4..6 as value);\nt;\n```\n\n输出返回:\n\n| id | value |\n| -- | ----- |\n| 1 | 4 |\n| 2 | 5 |\n| 3 | 6 |\n\n```\nselect id, value from t where id=2 or id=3;\n```\n\n输出返回:\n\n| id | value |\n| -- | ----- |\n| 2 | 5 |\n| 3 | 6 |\n\n相关函数:[and](https://docs.dolphindb.cn/zh/funcs/a/and.html), [not](https://docs.dolphindb.cn/zh/funcs/n/not.html)\n"
|
|
21209
21215
|
},
|
|
21210
|
-
"
|
|
21211
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/
|
|
21216
|
+
"osqp": {
|
|
21217
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/o/osqp.html",
|
|
21212
21218
|
"signatures": [
|
|
21213
21219
|
{
|
|
21214
|
-
"full": "
|
|
21215
|
-
"name": "
|
|
21220
|
+
"full": "osqp(q, [P], [A], [lb], [ub])",
|
|
21221
|
+
"name": "osqp",
|
|
21216
21222
|
"parameters": [
|
|
21217
21223
|
{
|
|
21218
|
-
"full": "
|
|
21219
|
-
"name": "
|
|
21224
|
+
"full": "q",
|
|
21225
|
+
"name": "q"
|
|
21220
21226
|
},
|
|
21221
21227
|
{
|
|
21222
|
-
"full": "
|
|
21223
|
-
"name": "
|
|
21224
|
-
|
|
21225
|
-
|
|
21226
|
-
}
|
|
21227
|
-
],
|
|
21228
|
-
"markdown": "### [nullFill!](https://docs.dolphindb.cn/zh/funcs/n/nullFill_.html)\n\n是 [nullFill](https://docs.dolphindb.cn/zh/funcs/n/nullFill.html) 的别名。\n\nnullFill! 是 函数原地修改版本,它会改变输入对象的值。\n\n\n以下是 `nullFill` 函数的文档:\n### [nullFill](https://docs.dolphindb.cn/zh/funcs/n/nullFill.html)\n\n\n\n#### 语法\n\nnullFill(X, Y)\n\n#### 参数\n\n**X** 可以是向量、矩阵或表。\n\n**Y** 可以是一个标量,也可以是与 *X* 长度相同的向量或矩阵。\n\n#### 详情\n\n如果 *X* 是一个向量或矩阵:\n\n* 如果 *Y* 是标量,使用 *Y* 填充 *X* 中的 NULL 值。\n\n* 如果 *Y* 是一个与 *X* 等长的向量或矩阵,使用 *Y* 中与 *X* 的 NULL 值对应位置的元素替换 *X* 中的 NULL 值。\n\n如果 *X* 是一个表,那么 *Y* 只能是一个标量,使用 *Y* 填充表中的 NULL 值。注意,填充 NULL 值时,系统会尝试将 *Y* 进行类型转换。如果 *Y* 不能转换为表中某列的类型,系统会抛出异常。\n\n`nullFill` 不改变输入对象的值;`nullFill!` 会改变输入对象的值。\n\n#### 例子\n\n例1.向量\n\n```\nx=1 NULL NULL 6 NULL 7;\nnullFill(x,0);\n// output\n[1,0,0,6,0,7]\n\ny=1..6\nnullFill(x,y);\n// output\n[1,2,3,6,5,7]\n```\n\n在 SQL 语句中对表中的一列使用 `nullFill` 函数:\n\n```\nID=take(1,6) join take(2,6)\ndate=take(2018.01.01..2018.01.06, 12)\nx=3.2 5.2 NULL 7.4 NULL NULL NULL NULL 8 NULL NULL 11\nt=table(ID, date, x)\nt;\n```\n\n| ID | date | x |\n| -- | ---------- | --- |\n| 1 | 2018.01.01 | 3.2 |\n| 1 | 2018.01.02 | 5.2 |\n| 1 | 2018.01.03 | |\n| 1 | 2018.01.04 | 7.4 |\n| 1 | 2018.01.05 | |\n| 1 | 2018.01.06 | |\n| 2 | 2018.01.01 | |\n| 2 | 2018.01.02 | |\n| 2 | 2018.01.03 | 8 |\n| 2 | 2018.01.04 | |\n| 2 | 2018.01.05 | |\n| 2 | 2018.01.06 | 11 |\n\n```\nupdate t set x=x.nullFill(avg(x)) context by id;\nt;\n```\n\n| ID | date | x |\n| -- | ---------- | -------- |\n| 1 | 2018.01.01 | 3.2 |\n| 1 | 2018.01.02 | 5.2 |\n| 1 | 2018.01.03 | 5.266667 |\n| 1 | 2018.01.04 | 7.4 |\n| 1 | 2018.01.05 | 5.266667 |\n| 1 | 2018.01.06 | 5.266667 |\n| 2 | 2018.01.01 | 9.5 |\n| 2 | 2018.01.02 | 9.5 |\n| 2 | 2018.01.03 | 8 |\n| 2 | 2018.01.04 | 9.5 |\n| 2 | 2018.01.05 | 9.5 |\n| 2 | 2018.01.06 | 11 |\n\n例2.矩阵\n\n```\nx=1 NULL 2 NULL 3 4 $ 3:2;\nx;\n```\n\n| #0 | #1 |\n| -- | -- |\n| 1 | |\n| | 3 |\n| 2 | 4 |\n\n```\nx.nullFill(0);\n```\n\n| #0 | #1 |\n| -- | -- |\n| 1 | 0 |\n| 0 | 3 |\n| 2 | 4 |\n\n例3.表\n\n```\nt=table(1..6 as id, 2.1 2.2 NULL NULL 2.4 2.6 as x, 4.3 NULL 3.6 6.7 8.8 NULL as y);\nnullFill(t, -999999);\n```\n\n| id | x | y |\n| -- | ------- | ------- |\n| 1 | 2.1 | 4.3 |\n| 2 | 2.2 | -999999 |\n| 3 | -999999 | 3.6 |\n| 4 | -999999 | 6.7 |\n| 5 | 2.4 | 8.8 |\n| 6 | 2.6 | -999999 |\n\n相关函数:[isNull](https://docs.dolphindb.cn/zh/funcs/i/isNull.html), [hasNull](https://docs.dolphindb.cn/zh/funcs/h/hasNull.html), [bfill](https://docs.dolphindb.cn/zh/funcs/b/bfill.html), [ffill](https://docs.dolphindb.cn/zh/funcs/f/ffill.html), [lfill](https://docs.dolphindb.cn/zh/funcs/l/lfill.html)\n"
|
|
21229
|
-
},
|
|
21230
|
-
"nunique": {
|
|
21231
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/n/nunique.html",
|
|
21232
|
-
"signatures": [
|
|
21233
|
-
{
|
|
21234
|
-
"full": "nunique(X, [ignoreNull=false])",
|
|
21235
|
-
"name": "nunique",
|
|
21236
|
-
"parameters": [
|
|
21228
|
+
"full": "[P]",
|
|
21229
|
+
"name": "P",
|
|
21230
|
+
"optional": true
|
|
21231
|
+
},
|
|
21237
21232
|
{
|
|
21238
|
-
"full": "
|
|
21239
|
-
"name": "
|
|
21233
|
+
"full": "[A]",
|
|
21234
|
+
"name": "A",
|
|
21235
|
+
"optional": true
|
|
21240
21236
|
},
|
|
21241
21237
|
{
|
|
21242
|
-
"full": "[
|
|
21243
|
-
"name": "
|
|
21244
|
-
"optional": true
|
|
21245
|
-
|
|
21238
|
+
"full": "[lb]",
|
|
21239
|
+
"name": "lb",
|
|
21240
|
+
"optional": true
|
|
21241
|
+
},
|
|
21242
|
+
{
|
|
21243
|
+
"full": "[ub]",
|
|
21244
|
+
"name": "ub",
|
|
21245
|
+
"optional": true
|
|
21246
21246
|
}
|
|
21247
21247
|
]
|
|
21248
21248
|
}
|
|
21249
21249
|
],
|
|
21250
|
-
"markdown": "### [
|
|
21250
|
+
"markdown": "### [osqp](https://docs.dolphindb.cn/zh/funcs/o/osqp.html)\n\n#### 语法\n\nosqp(q, \\[P], \\[A], \\[lb], \\[ub])\n\n#### 详情\n\n求二元目标函数在线性约束条件下的最优解。具体模型如下:\n\n\n\n返回一个元组:\n\n* 第一个元素是字符串,表示求解状态:\n * solved :已解决\n * solved inaccurate:已解决,但结果不精准\n * primal infeasible:原问题无可行解\n * dual infeasible:对偶问题无可行解\n * maximum iterations reached:达到最大迭代次数\n * run time limit reached:运行超时\n * problem non convex:问题非凸\n * interrupted:求解被中断\n * unsolved:未解决\n* 第二个元素是数值型向量,表示目标函数取到最小值时的数值解。\n\n#### 参数\n\n* **q** 是目标函数一次项向量。\n* **P** 是目标函数的二次项矩阵,且必须是半正定矩阵。\n* **A** 是不等式约束的系数矩阵。\n* **lb** 是不等式约束的左端向量。\n* **ub** 是不等式约束的右端向量。\n\n**Note:**\n\n* *A*、*lb*、*ub* 必须同时指定或同时省略。\n* *lb* 和 *ub* 可以包含空值(NULL),但其长度必须和A的行数匹配。 *ub/lb* 为空值时,视为正/负无穷,在计算时对应值为 ±1030。\n\n#### 例子\n\n```\nP = matrix(4e-2 6e-3 -4e-3 0.0, 6e-3 1e-2 0.0 0.0, -4e-3 0.0 2.5e-3 0.0, 0.0 0.0 0.0 0.0)\nq = [-2, -4, 2, 3]\nA = [1,3,3,-2,2,-1,1,-4,1,2,-1,-5,1,1,1,1]$4:4\nl = [,,,1.0]\nu = [3.0,2.0,-1.0,1.0]\nres = osqp(q, P, newA, l, u)\nprint(res)\n```\n\n返回:(\"solved\",\\[-64.364818313795097,368.910318139716082,-548.041799338347459,244.496302999333039])\n\n"
|
|
21251
21251
|
},
|
|
21252
21252
|
"pack": {
|
|
21253
21253
|
"url": "https://docs.dolphindb.cn/zh/funcs/p/pack.html",
|
|
@@ -21592,7 +21592,7 @@
|
|
|
21592
21592
|
]
|
|
21593
21593
|
}
|
|
21594
21594
|
],
|
|
21595
|
-
"markdown": "### [percentChange](https://docs.dolphindb.cn/zh/funcs/p/percentChange.html)\n\n\n\n#### 语法\n\npercentChange(X,\\[n])\n\n#### 参数\n\n**X** 是一个向量或矩阵。\n\nn 为可选参数,整型,用于指定计算 X 中两个元素值变化百分比时的元素间隔数,默认值为 1。\n\n* 在不指定 n 值时,percentChange 计算相邻元素值的变化百分比;\n\n* 当 n 为大于 1 的整数时,例如,当 X = 3 4 6 9,n = 2 时,计算 X 中 6 和 3 之间、9 和 4 之间的值变化百分比,得到的结果为:\\[,,1,1.25],即 100% 和 125%。\n\n* 当 n 为负整数时,例如, X = 3 4 6 9,n = -2 时,计算 X 中 3 和 6 之间、4 和 9 之间的值变化百分比,得到的结果为:\\[-0.5, -0.5555555555555556,,]。\n\n#### 详情\n\n
|
|
21595
|
+
"markdown": "### [percentChange](https://docs.dolphindb.cn/zh/funcs/p/percentChange.html)\n\n\n\n#### 语法\n\npercentChange(X,\\[n])\n\n#### 参数\n\n**X** 是一个向量或矩阵。\n\nn 为可选参数,整型,用于指定计算 X 中两个元素值变化百分比时的元素间隔数,默认值为 1。\n\n* 在不指定 n 值时,percentChange 计算相邻元素值的变化百分比;\n\n* 当 n 为大于 1 的整数时,例如,当 X = 3 4 6 9,n = 2 时,计算 X 中 6 和 3 之间、9 和 4 之间的值变化百分比,得到的结果为:\\[,,1,1.25],即 100% 和 125%。\n\n* 当 n 为负整数时,例如, X = 3 4 6 9,n = -2 时,计算 X 中 3 和 6 之间、4 和 9 之间的值变化百分比,得到的结果为:\\[-0.5, -0.5555555555555556,,]。\n\n#### 详情\n\n计算两个元素之间的值变化比例。即,对于 *X* 中的每一个元素,计算 (Xi/ Xi-n) - 1。\n\n若 *X* 是矩阵,在每列内进行上述计算,返回一个与 *X* 维度相同的矩阵。\n\n#### 例子\n\n```\npercentChange([1,2,3]);\n//output: [,1,0.5]\n\n```\n\n```\npercentChange(85 90 95);\n//output:[,0.058824,0.055556]\n```\n\n```\nm=matrix(100 105 109 112 108 116, 200 212 208 199 206 210);\nm\n```\n\n返回:\n\n| #0 | #1 |\n| --- | --- |\n| 100 | 200 |\n| 105 | 212 |\n| 109 | 208 |\n| 112 | 199 |\n| 108 | 206 |\n| 116 | 210 |\n\n```\npercentChange(m);\n```\n\n返回:\n\n| #0 | #1 |\n| ------------------ | ------------------ |\n| | |\n| 0.05 | 0.06 |\n| 0.038095238095238 | -0.018867924528302 |\n| 0.027522935779817 | -0.043269230769231 |\n| -0.035714285714286 | 0.035175879396985 |\n| 0.074074074074074 | 0.019417475728155 |\n\n以下例子中,X 是一个从 1 到 10 递增的向量。n = 3,即 1 和 4 比较,2 和 5 比较, 3 和 6 比较,以此类推。\n\n```\nX = 1..10;\nn = 3;\nr = percentChange(X,n);\nprint r;\n//output: [,,,3,1.5,1,0.75,0.6,0.5,0.428571428571429]\n```\n\n以下例子中,X 是一个矩阵。\n\n```\nm=matrix(1 3 2 NULL 6 9 3, 0 8 NULL 7 6 2 8);\nn = 3;\nresult = percentChange(m,n);\nresult;\n```\n\n返回:\n\n<table id=\"table_am1_r15_x1c\"><tbody><tr><td>\n\n0\n\n</td><td>\n\n1\n\n</td></tr><tr><td>\n\n</td><td>\n\n</td></tr><tr><td>\n\n</td><td>\n\n</td></tr><tr><td>\n\n</td><td>\n\n</td></tr><tr><td>\n\n</td><td>\n\n</td></tr><tr><td>\n\n1\n\n</td><td>\n\n-0.25\n\n</td></tr><tr><td>\n\n3.5\n\n</td><td>\n\n</td></tr><tr><td>\n\n</td><td>\n\n0.14285714285714285\n\n</td></tr></tbody>\n</table>当 n 为负整数时,\n\n```\nx = 3 4 6 9\nn = -2\nr2= percentChange(x,n)\nr2\n```\n\n返回:\n\n<table id=\"table_epg_t15_x1c\"><tbody><tr><td>\n\n0\n\n</td><td>\n\n1\n\n</td><td>\n\n2\n\n</td><td>\n\n3\n\n</td></tr><tr><td>\n\n-0.5\n\n</td><td>\n\n-0.5555555555555556\n\n</td><td>\n\n</td><td>\n\n</td></tr></tbody>\n</table>\n"
|
|
21596
21596
|
},
|
|
21597
21597
|
"percentile": {
|
|
21598
21598
|
"url": "https://docs.dolphindb.cn/zh/funcs/p/percentile.html",
|
|
@@ -22010,7 +22010,7 @@
|
|
|
22010
22010
|
]
|
|
22011
22011
|
}
|
|
22012
22012
|
],
|
|
22013
|
-
"markdown": "### [pow](https://docs.dolphindb.cn/zh/funcs/p/pow.html)\n\n#### 语法\n\npow(X, Y)\n\n#### 详情\n\n返回以 *X* 中的元素为底,以 *Y* 中元素为指数计算得到的值。当 *X* 和 *Y* 为整数时,结果仍然是 DOUBLE 类型。\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、向量或矩阵。\n\n#### 例子\n\n```\nx=1 2 3;\npow(x,3);\n//output:[1,8,27]\n\npow(3,x);\n//output:[3,9,27]\n\ny=4.5 5.5 6.5;\npow(x,y);\n//output:[1,45.254834,1262.665039]\n\npow(y,x);\n//output: [4.5,30.25,274.625]\n```\n\n```\nm=1..10$2:5;\nm;\n```\n\n返回:\n\n| #0 | #1 | #2 | #3 | #4 |\n| -- | -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 | 9 |\n| 2 | 4 | 6 | 8 | 10 |\n\n```\ntypestr(pow(3,4));\n//output: DOUBLE\n```\n\n
|
|
22013
|
+
"markdown": "### [pow](https://docs.dolphindb.cn/zh/funcs/p/pow.html)\n\n#### 语法\n\npow(X, Y)\n\n#### 详情\n\n返回以 *X* 中的元素为底,以 *Y* 中元素为指数计算得到的值。当 *X* 和 *Y* 为整数时,结果仍然是 DOUBLE 类型。\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、向量或矩阵。\n\n#### 例子\n\n```\nx=1 2 3;\npow(x,3);\n//output:[1,8,27]\n\npow(3,x);\n//output:[3,9,27]\n\ny=4.5 5.5 6.5;\npow(x,y);\n//output:[1,45.254834,1262.665039]\n\npow(y,x);\n//output: [4.5,30.25,274.625]\n```\n\n```\nm=1..10$2:5;\nm;\n```\n\n返回:\n\n| #0 | #1 | #2 | #3 | #4 |\n| -- | -- | -- | -- | -- |\n| 1 | 3 | 5 | 7 | 9 |\n| 2 | 4 | 6 | 8 | 10 |\n\n```\ntypestr(pow(3,4));\n//output: DOUBLE\n```\n\n"
|
|
22014
22014
|
},
|
|
22015
22015
|
"power": {
|
|
22016
22016
|
"url": "https://docs.dolphindb.cn/zh/funcs/p/power.html",
|
|
@@ -23489,7 +23489,7 @@
|
|
|
23489
23489
|
]
|
|
23490
23490
|
}
|
|
23491
23491
|
],
|
|
23492
|
-
"markdown": "### [remoteRun](https://docs.dolphindb.cn/zh/funcs/r/remoteRun.html)\n\n\n\n#### 语法\n\nremoteRun(conn, script, args)\n\n#### 参数\n\n**conn** 是远程数据库的连接句柄。\n\n**script** 是要执行的脚本或函数名。\n\n**args**
|
|
23492
|
+
"markdown": "### [remoteRun](https://docs.dolphindb.cn/zh/funcs/r/remoteRun.html)\n\n\n\n#### 语法\n\nremoteRun(conn, script, args)\n\n#### 参数\n\n**conn** 是远程数据库的连接句柄。\n\n**script** 是要执行的脚本或函数名。\n\n**args** 可选的可变长度参数。如果 *script* 是函数名,*args* 是函数的参数。\n\n#### 详情\n\n将脚本或函数传输到远程数据库执行。\n\n#### 例子\n\n第一种用法:在远程节点上执行脚本。\n\n```\nconn = xdb(\"localhost\",81);\nremoteRun(conn, \"x=rand(1.0,10000000); y=x pow 2; avg y\");\n```\n\n输出返回:0.333254\n\n第二种用法:\n\n* 如果 functionName 加了单引号,双引号或者反引号,那么表示在远程节点上调用函数。函数是定义在远程节点上,但是参数由本地节点传过去。\n\n ```\n h=xdb(\"localhost\",80);\n x=remoteRun(h, \"sum\",1..100);\n x;\n ```\n\n 输出返回:5050\n\n* 如果 functionName 没有加单引号,双引号或者反引号,那么表示调用的函数定义在本地节点上。参数也是由本地节点传过去。\n\n 假设在本地节点,我们有一个表 EarningsDates,该表有两列:股票代码和日期。表中3个股票中的每一个,都有2006年第三季度公布盈利的日期。在远程节点有一个表 USPrices,节点的名字为 localhost,端口号为8081。它包含所有美国股票的每日股票价格。我们希望从远程节点获得在宣布收益后的一周内所有 EarningsDates 表中股票的价格。 在远程节点,我们导入数据文件创建表 USPrices,然后将其共享为名叫 sharedUSPrices 的表。\n\n ```\n USPrices = loadText(\"c:/DolphinDB/Data/USPrices.csv\");\n share USPrices as USPrices;\n ```\n\n 当我们创建到远程节点的连接时,远程节点将为此连接创建一个新的会话。此新会话与远程节点上的其他会话完全隔离。这对于开发来说很方便,因为开发人员不必担心名称冲突。 然而,有时候我们也希望在同一节点上的多个会话之间共享数据。这时我们可以使用函数 [share](https://docs.dolphindb.cn/zh/progr/statements/share.html) 来共享对象。目前只能在 DolphinDB 中共享表。 在本地节点上,我们创建 EarningsDates 表,然后用脚本将其传输到远程节点。在执行完毕后,结果被返回到本地节点。\n\n ```\n EarningsDates=table(`XOM`AAPL`IBM as TICKER, 2006.10.26 2006.10.19 2006.10.17 as date)\n def loadDailyPrice(data){\n dateDict = dict(data.TICKER, data.date)\n return select date, TICKER, PRC from objByName(\"sharedUSPrices\") where dateDict[TICKER]<date<=dateDict[TICKER]+7\n }\n conn = xdb(\"localhost\",8081)\n prices = conn.remoteRun(loadDailyPrice, EarningsDates);\n prices;\n ```\n\n 输出返回:\n\n | date | TICKER | PRC |\n | ---------- | ------ | ----- |\n | 2006.10.27 | XOM | 71.46 |\n | 2006.10.30 | XOM | 70.84 |\n | 2006.10.31 | XOM | 71.42 |\n | 2006.11.01 | XOM | 71.06 |\n | 2006.11.02 | XOM | 71.19 |\n | 2006.10.18 | IBM | 89.82 |\n | 2006.10.19 | IBM | 89.86 |\n | 2006.10.20 | IBM | 90.48 |\n | 2006.10.23 | IBM | 91.56 |\n | 2006.10.24 | IBM | 91.49 |\n | 2006.10.20 | AAPL | 79.95 |\n | 2006.10.23 | AAPL | 81.46 |\n | 2006.10.24 | AAPL | 81.05 |\n | 2006.10.25 | AAPL | 81.68 |\n | 2006.10.26 | AAPL | 82.19 |\n\n相关函数:[remoteRunCompatible](https://docs.dolphindb.cn/zh/funcs/r/remoteruncompatible.html)\n"
|
|
23493
23493
|
},
|
|
23494
23494
|
"remoteRunCompatible": {
|
|
23495
23495
|
"url": "https://docs.dolphindb.cn/zh/funcs/r/remoteruncompatible.html",
|
|
@@ -23513,7 +23513,7 @@
|
|
|
23513
23513
|
]
|
|
23514
23514
|
}
|
|
23515
23515
|
],
|
|
23516
|
-
"markdown": "### [remoteRunCompatible](https://docs.dolphindb.cn/zh/funcs/r/remoteruncompatible.html)\n\n\n\n#### 语法\n\nremoteRunCompatible(conn, script, args)\n\n##### 参数\n\n**conn** 是远程数据库的连接句柄。\n\n**script** 是要执行的脚本或函数名。\n\n**args**
|
|
23516
|
+
"markdown": "### [remoteRunCompatible](https://docs.dolphindb.cn/zh/funcs/r/remoteruncompatible.html)\n\n\n\n#### 语法\n\nremoteRunCompatible(conn, script, args)\n\n##### 参数\n\n**conn** 是远程数据库的连接句柄。\n\n**script** 是要执行的脚本或函数名。\n\n**args** 可选的可变长度参数。如果 *script* 是函数名,*args* 是函数的参数。\n\n#### 详情\n\n将脚本或函数传输到远程数据库执行。\n\nremoteRunCompatible 与 remoteRun 的区别在于:\n\n* remoteRunCompatible 对本地和远程数据库的版本没有限制。\n\n* remoteRun 在本地数据库为 3.00 版本时,不支持远程数据库的版本低于3.00。\n\n#### 例子\n\n第一种用法:*script* 是脚本,则表示在远程节点上执行脚本。\n\n```\nconn =\n xdb(host=\"localhost\",port=8848,userId=\"admin\",password=123456);\n remoteRunCompatible(conn, \"avg(1..100)\");\n```\n\n结果为 50.5。\n\n第二种用法:*script* 是函数名\n\n* 如果 script 加了单引号,双引号或者反引号,那么表示在远程节点上调用函数。函数是定义在远程节点上,但是参数由本地节点传过去。\n\n在远程节点增加函数视图 myAvg\n\n`def myAvg(x){ return avg(x)+2 } addFunctionView(myAvg)`\n\n连接远程节点调用视图\n\n```\nconn = xdb(\"localhost\",8848,`admin,`123456);\n remoteRunCompatible(conn, \"myAvg\", 1..100);\n```\n\n结果为 52.5。\n\n* 如果 script 不加单引号,双引号或者反引号,那么表示调用的函数定义在本地节点上。参数也是由本地节点传过去。\n\n在本地节点定义同名函数 myAvg\n\n`def myAvg(x){ return avg(x)+1 }`\n\n在远程节点执行此函数\n\n```\nconn = xdb(\"localhost\",8848,`admin,`123456);\n remoteRunCompatible(conn, myAvg, 1..100);\n```\n\n结果为 51.5。\n\n相关函数:[remoteRun](https://docs.dolphindb.cn/zh/funcs/r/remoteRun.html)\n"
|
|
23517
23517
|
},
|
|
23518
23518
|
"remoteRunWithCompression": {
|
|
23519
23519
|
"url": "https://docs.dolphindb.cn/zh/funcs/r/remoteRunWithCompression.html",
|
|
@@ -30101,7 +30101,7 @@
|
|
|
30101
30101
|
]
|
|
30102
30102
|
}
|
|
30103
30103
|
],
|
|
30104
|
-
"markdown": "### [tmLowRange](https://docs.dolphindb.cn/zh/funcs/t/tmlowrange.html)\n\n#### 语法\n\ntmLowRange(T, X, window)\n\n参数说明和窗口计算规则请参考:[tmFunctions](https://docs.dolphindb.cn/zh/funcs/themes/tmFunctions.html)\n\n#### 详情\n\n在给定长度(以时间 *T* 衡量)的滑动窗口内,统计每个元素 Xi 左侧相邻且连续大于它的元素个数。NULL 被视为最小值。\n\n#### 例子\n\n```\nt = [0, 1, 2, 3, 7, 8, 9, 10, 11]\nx = [NULL, 3.1, NULL, 3.0, 2.9, 2.8, 3.1, NULL, 3.2]\ntmLowRange(t, x, window=3)\n// output: [,0,1,0,0,1,0,2,0]\n\ntmLowRange(t, x, window=4)\n// output: [,0,1,0,0,1,0,3,0]\n\nindex = take(datehour(2019.06.13 13:30:10),4) join (datehour(2019.06.13 13:30:10)+1..6)\ndata = 1 NULL 3 4 5 NULL 3 NULL 5 3\ntmLowRange(index, data, 4h)\n// output: [0,1,0,0,0,3,0,1,0,1]\n```\n\n
|
|
30104
|
+
"markdown": "### [tmLowRange](https://docs.dolphindb.cn/zh/funcs/t/tmlowrange.html)\n\n#### 语法\n\ntmLowRange(T, X, window)\n\n参数说明和窗口计算规则请参考:[tmFunctions](https://docs.dolphindb.cn/zh/funcs/themes/tmFunctions.html)\n\n#### 详情\n\n在给定长度(以时间 *T* 衡量)的滑动窗口内,统计每个元素 Xi 左侧相邻且连续大于它的元素个数。NULL 被视为最小值。\n\n#### 例子\n\n```\nt = [0, 1, 2, 3, 7, 8, 9, 10, 11]\nx = [NULL, 3.1, NULL, 3.0, 2.9, 2.8, 3.1, NULL, 3.2]\ntmLowRange(t, x, window=3)\n// output: [,0,1,0,0,1,0,2,0]\n\ntmLowRange(t, x, window=4)\n// output: [,0,1,0,0,1,0,3,0]\n\nindex = take(datehour(2019.06.13 13:30:10),4) join (datehour(2019.06.13 13:30:10)+1..6)\ndata = 1 NULL 3 4 5 NULL 3 NULL 5 3\ntmLowRange(index, data, 4h)\n// output: [0,1,0,0,0,3,0,1,0,1]\n```\n\n"
|
|
30105
30105
|
},
|
|
30106
30106
|
"tmmax": {
|
|
30107
30107
|
"url": "https://docs.dolphindb.cn/zh/funcs/t/tmmax.html",
|
|
@@ -30661,7 +30661,7 @@
|
|
|
30661
30661
|
]
|
|
30662
30662
|
}
|
|
30663
30663
|
],
|
|
30664
|
-
"markdown": "### [tmTopRange](https://docs.dolphindb.cn/zh/funcs/t/tmtoprange.html)\n\n#### 语法\n\ntmTopRange(T, X, window)\n\n参数说明和窗口计算规则请参考:[tmFunctions](https://docs.dolphindb.cn/zh/funcs/themes/tmFunctions.html)\n\n#### 详情\n\n在给定长度(以时间 *T* 衡量)的滑动窗口内,统计每个元素 Xi 左侧相邻且连续小于它的元素个数。NULL 被视为最小值。\n\n#### 例子\n\n```\nt = [0, 1, 2, 3, 7, 8, 9, 10, 11]\nx = [NULL, 3.1, NULL, 3.0, 2.9, 2.8, 3.1, NULL, 3.2];\ntmTopRange(t, x, window=3);\n//output: [,1,0,1,0,0,2,0,2]\n\ntmTopRange(t, x, window=4);\n// output: [,1,0,1,0,0,2,0,3]\n\nindex = take(datehour(2019.06.13 13:30:10),4) join (datehour(2019.06.13 13:30:10)+1..6)\ndata = 1 NULL 3 4 5 NULL 3 NULL 5 3\ntmTopRange(index, data, 4h)\n// output: [0,0,2,3,4,0,1,0,3,0]\n```\n\n
|
|
30664
|
+
"markdown": "### [tmTopRange](https://docs.dolphindb.cn/zh/funcs/t/tmtoprange.html)\n\n#### 语法\n\ntmTopRange(T, X, window)\n\n参数说明和窗口计算规则请参考:[tmFunctions](https://docs.dolphindb.cn/zh/funcs/themes/tmFunctions.html)\n\n#### 详情\n\n在给定长度(以时间 *T* 衡量)的滑动窗口内,统计每个元素 Xi 左侧相邻且连续小于它的元素个数。NULL 被视为最小值。\n\n#### 例子\n\n```\nt = [0, 1, 2, 3, 7, 8, 9, 10, 11]\nx = [NULL, 3.1, NULL, 3.0, 2.9, 2.8, 3.1, NULL, 3.2];\ntmTopRange(t, x, window=3);\n//output: [,1,0,1,0,0,2,0,2]\n\ntmTopRange(t, x, window=4);\n// output: [,1,0,1,0,0,2,0,3]\n\nindex = take(datehour(2019.06.13 13:30:10),4) join (datehour(2019.06.13 13:30:10)+1..6)\ndata = 1 NULL 3 4 5 NULL 3 NULL 5 3\ntmTopRange(index, data, 4h)\n// output: [0,0,2,3,4,0,1,0,3,0]\n```\n\n"
|
|
30665
30665
|
},
|
|
30666
30666
|
"tmvar": {
|
|
30667
30667
|
"url": "https://docs.dolphindb.cn/zh/funcs/t/tmvar.html",
|
|
@@ -32045,76 +32045,6 @@
|
|
|
32045
32045
|
],
|
|
32046
32046
|
"markdown": "### [volumeBar](https://docs.dolphindb.cn/zh/funcs/v/volumeBar.html)\n\n\n\n#### 语法\n\nvolumeBar(X, interval, \\[label='seq'])\n\n#### 参数\n\n**X** 是数值型向量。\n\n**interval** 非零的数值,表示一个定值或百分比。\n\n**label** 为标记分组的方法,有以下三种类型:\n\n* 'seq':默认值,表示按 0, 1, 2, 3… 的顺序标记组号。\n\n* 'left':当前分组第一个元素前所有元素的累加和作为组号。第1个分组的组号为 0。\n\n* 'right':*X* 从第一个元素开始累加到当前分组中最后一个元素的值作为组号。\n\n#### 详情\n\n对 *X* 进行累加,并根据指定的阈值进行分组,返回数据所属分组的组号。分组规则为:\n\n依次累加 *X* 中的元素\n\n* 若阈值为正数,则从第一个元素开始累加,直到累加和大于等于阈值,将这些元素划分为一组。然后从下一个元素重新开始累加,并分组,以此类推。最后剩余的累加和小于阈值的元素划分为一组。\n\n* 若阈值为负数,则从第一个元素开始累加,直到累加和小于等于阈值,将这些元素划分为一组。然后从下一个元素重新开始累加,并分组,以此类推。最后剩余的累加和大于阈值的元素划分为一组。\n\n*interval* 确定了累加分组的阈值,可以是一个定值也可以是一个百分比:\n\n* 当 *interval* ∈ (0, 1) 时, 表示一个百分比,阈值为 sum(X) \\* interval。注意,系统会将阈值转换为与 *X* 相同的类型再进行比较。例如,*X* 是整型,则累加和将与 floor(sum(X) \\* interval)进行比较。\n\n* 否则,*interval* 表示一个定值,即阈值为 *interval*。\n\n#### 例子\n\n```\nX = 1 3 4 2 2 1 1 1 1 6 8\nvolumeBar(X, 4)\n```\n\n输出返回:\\[0,0,1,2,2,3,3,3,3,4,5]\n\n```\nvolumeBar(X, 4, 'left')\n```\n\n输出返回:\\[0,0,4,8,8,12,12,12,12,16,22]\n\n```\nvolumeBar(X, 4, 'right')\n```\n\n输出返回:\\[4,4,8,12,12,16,16,16,16,22,30]\n\n```\nX = -6 2 -4 -5 -1 3 -2 -1\nvolumeBar(X, -2)\n```\n\n输出返回:\\[0,1,1,2,3,3,3,3]\n\n```\nvolumeBar(X, -2, 'left')\n```\n\n输出返回:\\[0,-6,-6,-8,-13,-13,-13,-13]\n\n```\nvolumeBar(X, -2, 'right')\n```\n\n输出返回:\\[-6,-8,-8,-13,-14,-14,-14,-14]\n\n```\nsecurityID = `st001`st002`st001`st002`st001`st002\ntime = 2022.01.01 2022.01.01 2022.01.02 2022.01.02 2022.01.03 2022.01.03\nprice = 30.15 30.21 30.09 30.13 30.18 30.16\nvolume = 190 212 198 211 205 199\nt = table(securityID, time, price, volume)\n\n//每支股票根据 volume 的累加和分组,统计各分组的平均价格。\nselect avg(price) from t group by securityID, contextby(volumeBar{, 400}, volume, securityID) as cumVol\n```\n\n输出返回:\n\n| securityID | cumVol | avg\\_price |\n| ---------- | ------ | ---------- |\n| st001 | 0 | 30.14 |\n| st002 | 0 | 30.17 |\n| st002 | 1 | 30.16 |\n"
|
|
32047
32047
|
},
|
|
32048
|
-
"xdb": {
|
|
32049
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/x/xdb.html",
|
|
32050
|
-
"signatures": [
|
|
32051
|
-
{
|
|
32052
|
-
"full": "xdb(siteAlias, [userId], [password])",
|
|
32053
|
-
"name": "xdb",
|
|
32054
|
-
"parameters": [
|
|
32055
|
-
{
|
|
32056
|
-
"full": "siteAlias",
|
|
32057
|
-
"name": "siteAlias"
|
|
32058
|
-
},
|
|
32059
|
-
{
|
|
32060
|
-
"full": "[userId]",
|
|
32061
|
-
"name": "userId",
|
|
32062
|
-
"optional": true
|
|
32063
|
-
},
|
|
32064
|
-
{
|
|
32065
|
-
"full": "[password]",
|
|
32066
|
-
"name": "password",
|
|
32067
|
-
"optional": true
|
|
32068
|
-
}
|
|
32069
|
-
]
|
|
32070
|
-
},
|
|
32071
|
-
{
|
|
32072
|
-
"full": "xdb(host, port, [userId], [password])",
|
|
32073
|
-
"name": "xdb",
|
|
32074
|
-
"parameters": [
|
|
32075
|
-
{
|
|
32076
|
-
"full": "host",
|
|
32077
|
-
"name": "host"
|
|
32078
|
-
},
|
|
32079
|
-
{
|
|
32080
|
-
"full": "port",
|
|
32081
|
-
"name": "port"
|
|
32082
|
-
},
|
|
32083
|
-
{
|
|
32084
|
-
"full": "[userId]",
|
|
32085
|
-
"name": "userId",
|
|
32086
|
-
"optional": true
|
|
32087
|
-
},
|
|
32088
|
-
{
|
|
32089
|
-
"full": "[password]",
|
|
32090
|
-
"name": "password",
|
|
32091
|
-
"optional": true
|
|
32092
|
-
}
|
|
32093
|
-
]
|
|
32094
|
-
}
|
|
32095
|
-
],
|
|
32096
|
-
"markdown": "### [xdb](https://docs.dolphindb.cn/zh/funcs/x/xdb.html)\n\n\n\n#### 语法\n\nxdb(siteAlias, \\[userId], \\[password])\n\n或\n\nxdb(host, port, \\[userId], \\[password])\n\n#### 参数\n\n**siteAlias** 是远程节点的别名。它需要在配置文件中定义。\n\n**host** 是远程节点的主机名(IP 地址或站点)。\n\n**port** 是远程节点的端口号。\n\n**userId** 和 **password** 是基于用户的配置文件的。如果管理员启用用户访问控制,需要输入用户名和密码。\n\n#### 详情\n\n连接到节点的远程站点。如果连接成功,则返回远程连接的句柄。\n\n#### 例子\n\n```\nh2=xdb(\"local8081\");\nh2;\n// output\n\"Conn[localhost:8081:1166953221]\"\n\nh21=xdb(\"localhost\",8081);\nh21;\n// output\n\"Conn[localhost:8081:1441295757]\"\n\nh4=xdb(\"local8083\",\"userAdm\",\"passAdm\");\nh4;\n// output\n\"Conn[localhost:8083:1166953221]\"\n\nh41=xdb(\"localhost\",8083, \"user001\",\"pass001\");\nh41;\n// output\n\"Conn[localhost:8083:597793698]\"\n```\n"
|
|
32097
|
-
},
|
|
32098
|
-
"xor": {
|
|
32099
|
-
"url": "https://docs.dolphindb.cn/zh/funcs/x/xor.html",
|
|
32100
|
-
"signatures": [
|
|
32101
|
-
{
|
|
32102
|
-
"full": "xor(X, Y)",
|
|
32103
|
-
"name": "xor",
|
|
32104
|
-
"parameters": [
|
|
32105
|
-
{
|
|
32106
|
-
"full": "X",
|
|
32107
|
-
"name": "X"
|
|
32108
|
-
},
|
|
32109
|
-
{
|
|
32110
|
-
"full": "Y",
|
|
32111
|
-
"name": "Y"
|
|
32112
|
-
}
|
|
32113
|
-
]
|
|
32114
|
-
}
|
|
32115
|
-
],
|
|
32116
|
-
"markdown": "### [xor](https://docs.dolphindb.cn/zh/funcs/x/xor.html)\n\n\n\n#### 语法\n\nxor(X, Y)\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、数据对、向量、矩阵或表。\n\n#### 详情\n\n按元素逐个返回 *X* 逻辑异或 (`XOR`)*Y* 的结果。\n\n#### 例子\n\n```\n1 xor 0\n// output\n1\n\nx = 5 6 7\nx xor 0\n// output\n[1,1,1]\n\nx = 1 2 3\ny = 2 1 3\nx xor y\n// output\n[0,0,0]\n\ntrue xor false\n// output\n1\n```\n\n相关函数:[or](https://docs.dolphindb.cn/zh/funcs/o/or.html), [not](https://docs.dolphindb.cn/zh/funcs/n/not.html)\n"
|
|
32117
|
-
},
|
|
32118
32048
|
"warmupStreamEngine": {
|
|
32119
32049
|
"url": "https://docs.dolphindb.cn/zh/funcs/w/warmupStreamEngine.html",
|
|
32120
32050
|
"signatures": [
|
|
@@ -32771,6 +32701,76 @@
|
|
|
32771
32701
|
],
|
|
32772
32702
|
"markdown": "### [wsum2](https://docs.dolphindb.cn/zh/funcs/w/wsum2.html)\n\n\n\n#### 语法\n\nwsum2(X, Y)\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、向量、矩阵或表。\n\n#### 详情\n\n返回 *X* 和 *Y* 的加权平方和。即使 *X* 和 *Y* 都是整型,返回结果仍为 DOUBLE 类型。\n\n#### 例子\n\n```\nwsum2(3 4 1, 1 2 3);\n// output\n44\n// 9*1 + 16*2 + 1*3 = 44\n```\n\n相关函数:[wsum](https://docs.dolphindb.cn/zh/funcs/w/wsum.html)\n"
|
|
32773
32703
|
},
|
|
32704
|
+
"xdb": {
|
|
32705
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/x/xdb.html",
|
|
32706
|
+
"signatures": [
|
|
32707
|
+
{
|
|
32708
|
+
"full": "xdb(siteAlias, [userId], [password])",
|
|
32709
|
+
"name": "xdb",
|
|
32710
|
+
"parameters": [
|
|
32711
|
+
{
|
|
32712
|
+
"full": "siteAlias",
|
|
32713
|
+
"name": "siteAlias"
|
|
32714
|
+
},
|
|
32715
|
+
{
|
|
32716
|
+
"full": "[userId]",
|
|
32717
|
+
"name": "userId",
|
|
32718
|
+
"optional": true
|
|
32719
|
+
},
|
|
32720
|
+
{
|
|
32721
|
+
"full": "[password]",
|
|
32722
|
+
"name": "password",
|
|
32723
|
+
"optional": true
|
|
32724
|
+
}
|
|
32725
|
+
]
|
|
32726
|
+
},
|
|
32727
|
+
{
|
|
32728
|
+
"full": "xdb(host, port, [userId], [password])",
|
|
32729
|
+
"name": "xdb",
|
|
32730
|
+
"parameters": [
|
|
32731
|
+
{
|
|
32732
|
+
"full": "host",
|
|
32733
|
+
"name": "host"
|
|
32734
|
+
},
|
|
32735
|
+
{
|
|
32736
|
+
"full": "port",
|
|
32737
|
+
"name": "port"
|
|
32738
|
+
},
|
|
32739
|
+
{
|
|
32740
|
+
"full": "[userId]",
|
|
32741
|
+
"name": "userId",
|
|
32742
|
+
"optional": true
|
|
32743
|
+
},
|
|
32744
|
+
{
|
|
32745
|
+
"full": "[password]",
|
|
32746
|
+
"name": "password",
|
|
32747
|
+
"optional": true
|
|
32748
|
+
}
|
|
32749
|
+
]
|
|
32750
|
+
}
|
|
32751
|
+
],
|
|
32752
|
+
"markdown": "### [xdb](https://docs.dolphindb.cn/zh/funcs/x/xdb.html)\n\n\n\n#### 语法\n\nxdb(siteAlias, \\[userId], \\[password])\n\n或\n\nxdb(host, port, \\[userId], \\[password])\n\n#### 参数\n\n**siteAlias** 是远程节点的别名。它需要在配置文件中定义。\n\n**host** 是远程节点的主机名(IP 地址或站点)。\n\n**port** 是远程节点的端口号。\n\n**userId** 和 **password** 是基于用户的配置文件的。如果管理员启用用户访问控制,需要输入用户名和密码。\n\n#### 详情\n\n连接到节点的远程站点。如果连接成功,则返回远程连接的句柄。\n\n#### 例子\n\n```\nh2=xdb(\"local8081\");\nh2;\n// output\n\"Conn[localhost:8081:1166953221]\"\n\nh21=xdb(\"localhost\",8081);\nh21;\n// output\n\"Conn[localhost:8081:1441295757]\"\n\nh4=xdb(\"local8083\",\"userAdm\",\"passAdm\");\nh4;\n// output\n\"Conn[localhost:8083:1166953221]\"\n\nh41=xdb(\"localhost\",8083, \"user001\",\"pass001\");\nh41;\n// output\n\"Conn[localhost:8083:597793698]\"\n```\n"
|
|
32753
|
+
},
|
|
32754
|
+
"xor": {
|
|
32755
|
+
"url": "https://docs.dolphindb.cn/zh/funcs/x/xor.html",
|
|
32756
|
+
"signatures": [
|
|
32757
|
+
{
|
|
32758
|
+
"full": "xor(X, Y)",
|
|
32759
|
+
"name": "xor",
|
|
32760
|
+
"parameters": [
|
|
32761
|
+
{
|
|
32762
|
+
"full": "X",
|
|
32763
|
+
"name": "X"
|
|
32764
|
+
},
|
|
32765
|
+
{
|
|
32766
|
+
"full": "Y",
|
|
32767
|
+
"name": "Y"
|
|
32768
|
+
}
|
|
32769
|
+
]
|
|
32770
|
+
}
|
|
32771
|
+
],
|
|
32772
|
+
"markdown": "### [xor](https://docs.dolphindb.cn/zh/funcs/x/xor.html)\n\n\n\n#### 语法\n\nxor(X, Y)\n\n#### 参数\n\n**X** 和 **Y** 可以是标量、数据对、向量、矩阵或表。\n\n#### 详情\n\n按元素逐个返回 *X* 逻辑异或 (`XOR`)*Y* 的结果。\n\n#### 例子\n\n```\n1 xor 0\n// output\n1\n\nx = 5 6 7\nx xor 0\n// output\n[1,1,1]\n\nx = 1 2 3\ny = 2 1 3\nx xor y\n// output\n[0,0,0]\n\ntrue xor false\n// output\n1\n```\n\n相关函数:[or](https://docs.dolphindb.cn/zh/funcs/o/or.html), [not](https://docs.dolphindb.cn/zh/funcs/n/not.html)\n"
|
|
32773
|
+
},
|
|
32774
32774
|
"year": {
|
|
32775
32775
|
"url": "https://docs.dolphindb.cn/zh/funcs/y/year.html",
|
|
32776
32776
|
"signatures": [
|