@fffangchenghao/dsh-web-search 0.19.3 → 0.20.1
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- package/CHANGELOG.md +173 -1
- package/README.md +214 -34
- package/README.zh-CN.md +187 -35
- package/SECURITY.md +42 -7
- package/client.js +248 -10
- package/docs/store-evidence.md +10 -5
- package/lib/advanced-search.d.ts +107 -0
- package/lib/advanced-search.js +255 -0
- package/lib/bridge.d.ts +34 -0
- package/lib/bridge.js +305 -0
- package/lib/cache.d.ts +11 -4
- package/lib/cache.js +9 -5
- package/lib/config.d.ts +19 -3
- package/lib/config.js +24 -0
- package/lib/domain-tool.d.ts +5 -0
- package/lib/domain-tool.js +45 -6
- package/lib/engine-test.d.ts +116 -0
- package/lib/engine-test.js +256 -0
- package/lib/engines.d.ts +11 -1
- package/lib/engines.js +118 -19
- package/lib/errors.d.ts +16 -2
- package/lib/errors.js +40 -1
- package/lib/index.d.ts +24 -2
- package/lib/index.js +309 -21
- package/lib/inject.d.ts +68 -0
- package/lib/inject.js +1 -0
- package/lib/markdown.js +18 -1
- package/lib/mirrors.d.ts +23 -0
- package/lib/mirrors.js +69 -0
- package/lib/official-feed.d.ts +114 -0
- package/lib/official-feed.js +288 -0
- package/lib/official-support.d.ts +74 -0
- package/lib/official-support.js +134 -0
- package/lib/platform-tool.d.ts +77 -0
- package/lib/platform-tool.js +173 -0
- package/lib/platforms.d.ts +178 -0
- package/lib/platforms.js +1035 -0
- package/lib/query-router.d.ts +29 -0
- package/lib/query-router.js +58 -0
- package/lib/read-page.js +2 -1
- package/lib/research-cache.d.ts +115 -0
- package/lib/research-cache.js +275 -0
- package/lib/research.d.ts +45 -4
- package/lib/research.js +505 -22
- package/lib/search-many.d.ts +7 -1
- package/lib/search-many.js +7 -2
- package/lib/system-prompt.d.ts +27 -0
- package/lib/system-prompt.js +50 -0
- package/lib/tool-suite.d.ts +97 -0
- package/lib/tool-suite.js +224 -0
- package/lib/transport.d.ts +33 -2
- package/lib/transport.js +42 -9
- package/lib/types.d.ts +20 -0
- package/lib/types.js +9 -1
- package/lib/untrusted.d.ts +33 -0
- package/lib/untrusted.js +42 -0
- package/lib/verticals.d.ts +3 -1
- package/lib/verticals.js +26 -7
- package/package.json +5 -3
- package/skills/dsh-web-search/SKILL.md +21 -6
package/README.zh-CN.md
CHANGED
|
@@ -9,7 +9,7 @@
|
|
|
9
9
|
|
|
10
10
|
<p align="center">
|
|
11
11
|
<a href="https://www.npmjs.com/package/@fffangchenghao/dsh-web-search"><img src="https://img.shields.io/npm/v/@fffangchenghao/dsh-web-search.svg" alt="npm 版本"></a>
|
|
12
|
-
<img src="https://img.shields.io/badge/tests-
|
|
12
|
+
<img src="https://img.shields.io/badge/tests-664%20passing-brightgreen" alt="测试">
|
|
13
13
|
<img src="https://img.shields.io/badge/engines-8%2C%20zero%20API%20key-brightgreen" alt="引擎">
|
|
14
14
|
<img src="https://img.shields.io/badge/node-%3E%3D22.18-blue" alt="node">
|
|
15
15
|
<img src="https://img.shields.io/badge/dsh-%3E%3D0.2.1--rc.2%20%3C0.3.0-blueviolet" alt="dsh">
|
|
@@ -19,9 +19,9 @@
|
|
|
19
19
|
## 为什么选这个
|
|
20
20
|
|
|
21
21
|
- **不要 API key,八个引擎。** AnySearch、必应中国、DuckDuckGo HTML、必应国际、DuckDuckGo Lite、360 搜索直接抓取;Exa 走它的免密钥 MCP 通道加入主引擎,Firecrawl 的搜索 API 作为实测后的兜底。装好就能用。
|
|
22
|
-
- **排序是量出来的,不是写出来的。** 跨引擎 RRF 融合,叠加权威度与时效加权;20 条离线基准 + 81
|
|
22
|
+
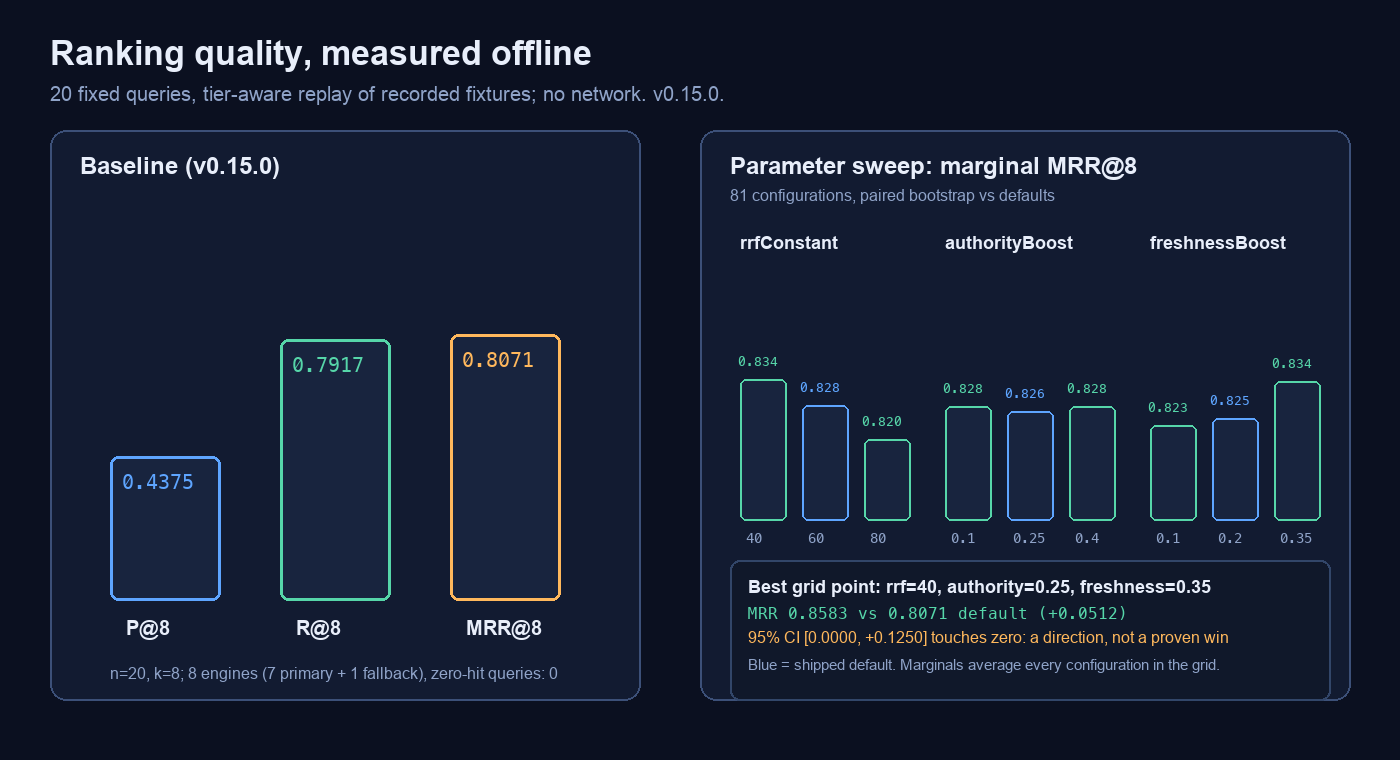
- **排序是量出来的,不是写出来的。** 跨引擎 RRF 融合,叠加权威度与时效加权;20 条离线基准 + 81 组参数扫描,是这类插件里少数同时公开指标、逐条输出和置信区间的。方法见 [排序是怎么做的](docs/rrf-ranking.md)。
|
|
23
23
|
- **抓取会承认失败。** 二进制文档和「200 但正文为空」会被明确拒绝(`SEARCH_UNSUPPORTED`、`SEARCH_EMPTY`),而不是当噪音返回;direct → tunnel → render → extract 四级阶梯共享 25 秒预算,预算不足就不再起新的一级。预算是「每次请求」而不是「插件启动时」,这点有回归测试守着。
|
|
24
|
-
- **
|
|
24
|
+
- **50 个测试文件、664 个用例**,`lib/` 产物入库,声明了 `engines.dsh` / `engines.node`,[SECURITY.md](SECURITY.md) 逐项列出插件会碰的进程、主机和文件。
|
|
25
25
|
- **双语文档。** 本文件和 [English README](README.md) 同步维护。
|
|
26
26
|
|
|
27
27
|
|
|
@@ -30,24 +30,44 @@
|
|
|
30
30
|
|
|
31
31
|
## 它在同类里的位置
|
|
32
32
|
|
|
33
|
-
DSH
|
|
34
|
-
|
|
35
|
-
|
|
36
|
-
|
|
37
|
-
|
|
38
|
-
|
|
|
39
|
-
|
|
|
40
|
-
|
|
|
41
|
-
|
|
|
42
|
-
|
|
|
43
|
-
|
|
44
|
-
|
|
33
|
+
DSH 插件生态里的「联网搜索」已经很挤。下面是一张 2026-10-25 的快照
|
|
34
|
+
(stars 和 npm 下载量是采用度信号,不是质量分数):
|
|
35
|
+
|
|
36
|
+
| | 本插件 | [dsh-free-search](https://github.com/DDDMUC/dsh-free-search) | [dsh-web-search-pro](https://github.com/anweat/dsh-web-search-pro) | [modsearch](https://github.com/liustack/modsearch) | [anysearch-dsh](https://github.com/anysearch-team/anysearch-dsh) |
|
|
37
|
+
|---|---|---|---|---|---|---|
|
|
38
|
+
| 免 key 路径 | 8 个引擎,全部免 key | ~30 个免费/付费引擎链 | 默认 5 个(seam、Exa、DDG、Bing、Jina) | Firecrawl + Keenable 免 key 默认 | 1 个 AnySearch 匿名 API |
|
|
39
|
+
| 专门数据源 | 34 个(默认开 8 个) | 41 个 | 平台注册表,不是垂直源目录 | 网页 + X,无垂直源目录 | AnySearch 的垂直 API |
|
|
40
|
+
| 面向模型的工具 | 1 个(`web_tools`,8 个 action) | ~10 个 | 2 个(`web_index` / `web_call`,20 个动作) | 原生搜索/抓取 + skill | 5 个 |
|
|
41
|
+
| 测试 | 50 文件 / 664 用例,本地实测 | `package.json` 无测试脚本 | 774 单元 + 94 bench,自报 | 配了 Vitest,未公布数量 | 配了 Vitest,未公布数量 |
|
|
42
|
+
| GitHub stars | 0 | 620 | 77 | 836 | 663 |
|
|
43
|
+
| npm 近一月下载 | 1,087 | 52,436 | 6,420 | 43,151 | 9,251 |
|
|
44
|
+
| npm 解包大小 | 1.1 MB | 0.70 MB | 3.05 MB | 0.51 MB | 0.27 MB |
|
|
45
|
+
|
|
46
|
+
这不是「只有一个冠军」的排行榜,比较诚实的结论是:
|
|
47
|
+
|
|
48
|
+
- **功能深度:中上。** `dsh-free-search` 引擎和垂直源更多;
|
|
49
|
+
`dsh-web-search-pro` 的证据/排序管线和平台后端更深;`modsearch` 的跨宿主
|
|
50
|
+
能力更强。
|
|
51
|
+
- **工程质量与可验证性:接近第一梯队。** 664 个本地测试、可重放的排序基准、
|
|
52
|
+
明确的安全边界、只有 1 个运行时依赖,同时体积远小于 Playwright 重型方案。
|
|
53
|
+
- **免 key + 官方源纠错:最强卖点。** Chrome、PostgreSQL、AI Act 的官方路径
|
|
54
|
+
和 34 个垂直源,不是其他插件普遍具备的。
|
|
55
|
+
- **采用度与成熟度:这个样本里的后段。** 公开 npm 已是 0.20.1,与这棵树一致;但 GitHub 仓库创建 4 天、0 stars,
|
|
56
|
+
还缺少独立采用。
|
|
57
|
+
- **工具面的经济性:现在有竞争力。** 0.20.x 只暴露一个 `web_tools` + 8 个
|
|
58
|
+
action,接近 `dsh-web-search-pro` 的 2 工具 + 20 动作;旧的八个工具名保留为
|
|
59
|
+
可选兼容模式。
|
|
60
|
+
|
|
61
|
+
要最大安装量和引擎广度,优先看 `dsh-free-search` 或 `modsearch`;要最深的
|
|
62
|
+
证据/评分管线和浏览器平台,看 `dsh-web-search-pro`。本插件是「完全免 key、
|
|
63
|
+
搜索 + 垂直查询 + 研究包 + 官方源纠错」的轻量选项。它不是最流行的,也不该
|
|
64
|
+
自称最大。
|
|
45
65
|
|
|
46
66
|
> 最新版本与安装命令以 [npm 上的 latest](https://www.npmjs.com/package/@fffangchenghao/dsh-web-search) 为准(这里不写死版本号,免得文档和发布不同步)。下面先讲「它跟我有什么关系」,技术细节放在后面的附录。
|
|
47
67
|
|
|
48
68
|
## 一句话说明
|
|
49
69
|
|
|
50
|
-
装好这个插件,你在对话里问「上周发布的那版怎么配置」,模型可以自己调用 `web_search` 去公开搜索引擎查,拿回排好序的标题、链接和摘要;摘要不够用时,它还能调用 `web_fetch` 打开其中一条链接,把网页正文整理成 Markdown 读进对话,而不是一整屏 HTML。如果一个问题需要分别查几件事,它可以调用 `search_many
|
|
70
|
+
装好这个插件,你在对话里问「上周发布的那版怎么配置」,模型可以自己调用 `web_search` 去公开搜索引擎查,拿回排好序的标题、链接和摘要;摘要不够用时,它还能调用 `web_fetch` 打开其中一条链接,把网页正文整理成 Markdown 读进对话,而不是一整屏 HTML。如果一个问题需要分别查几件事,它可以调用 `search_many`,一次拿回每条查询各自的结果;如果只想给一条查询临时加时间窗,可以调用 `advanced_search`。如果问题问的是某个 npm 包、GitHub 仓库、论文或问答帖,它还可以调用 `domain_search`,直接去那几类专门的数据源里查。如果问题落在 B 站、V2EX、Reddit、YouTube、知乎或掘金,它可以调用 `platform_search`;PostgreSQL 版本/EOL 问题会先补上项目官方支持表,而不是只信旧新闻稿;如果一页正文长到一次读不完,它还可以调用 `read_page`,从上次停下的地方接着读。
|
|
51
71
|
|
|
52
72
|
对你的实际影响就三条:
|
|
53
73
|
|
|
@@ -55,7 +75,7 @@ DSH 插件生态里的「联网搜索」这一块已经很挤,大多数竞品
|
|
|
55
75
|
- 问包、仓库、论文、问答时,模型能直接查对应的数据源,不用拿网页搜索去碰运气。
|
|
56
76
|
- 你不需要准备搜索 API key,也不需要为搜索单独付费。
|
|
57
77
|
|
|
58
|
-
说白了就一句话:它给 Harness 的 `web` 服务插上两个「提供方」——搜索用 `bing`,抓网页用 `http-proxy
|
|
78
|
+
说白了就一句话:它给 Harness 的 `web` 服务插上两个「提供方」——搜索用 `bing`,抓网页用 `http-proxy`;再给模型加一个 `web_tools` action 工具:`action: "domain_search"` 专查包、代码仓库、论文、问答和百科,`search_many` 一次跑多条查询,`advanced_search` 给单条查询临时加时间窗,`read_page` 把长页面分段接着读,`research` 把几次搜索变成一份带引用的证据包,`platform_search` 查 B 站、V2EX、Reddit、YouTube、知乎和掘金,`cache_search` 在 research 已抓取的全文里二次检索,`engine_test` 用来逐个检查引擎是否健康。八种能力只占一个工具注册,不是八个独立插件,也不是八个常驻工具。
|
|
59
79
|
|
|
60
80
|
## 它解决什么问题
|
|
61
81
|
|
|
@@ -152,7 +172,7 @@ fetch 拿回来的则是**正文**,不是页面的装修:导航、广告、
|
|
|
152
172
|
|
|
153
173
|
两个一起用最顺:先用 `domain_search` 找到包或论文,再用 `web_fetch` 打开它的主页或 README 读细节。
|
|
154
174
|
|
|
155
|
-
|
|
175
|
+
旁边还有六个帮手:**`search_many`**、**`advanced_search`**、**`read_page`**、**`research`**、**`platform_search`** 和 **`cache_search`**。当一个问题需要分别查好几件事——比如每个候选库各查一次——`search_many` 一次接住 1–5 条查询,把每条查询的结果分开返回,某一条失败也不会拖垮整批;只有一条问题需要「最近一周」时,`advanced_search` 只给这一次调用加时间窗;`read_page` 则在网页长到一次抓不完时,接着上一次的位置继续往下读;`research` 则在摘要不够、又必须决定该信哪一页时,先跑最多三条查询,再打开靠前的页面,返回一份每个摘录都带出处的证据包。
|
|
156
176
|
|
|
157
177
|
### 分段读长页(read_page):一次读不完,就接着读
|
|
158
178
|
|
|
@@ -250,7 +270,7 @@ Harness 里有个叫 `web` 的**服务**,它自己不会搜索,只负责「
|
|
|
250
270
|
|
|
251
271
|
7. **同一个问题不重复打扰搜索引擎。**
|
|
252
272
|
十分钟内问同一个问题,直接用上次的结果,几乎瞬间返回。
|
|
253
|
-
*技术补充:TTL + LRU 缓存,`cacheTtlMs: 600000`(10 分钟)、`cacheEntries: 100`;键是 `lead|wait|limit|排序后的引擎 id
|
|
273
|
+
*技术补充:TTL + LRU 缓存,`cacheTtlMs: 600000`(10 分钟)、`cacheEntries: 100`;键是 `lead|wait|limit|排序后的引擎 id|时间窗|策略字段|归一化 query`,其中时间窗只在非 `off` 时出现、策略字段只在非默认时出现,所以默认检索的缓存行为没变。*
|
|
254
274
|
|
|
255
275
|
8. **被限流会自己歇一会儿。**
|
|
256
276
|
某家回了验证页,就先不用它,过几分钟再试,其他家照常。
|
|
@@ -277,8 +297,8 @@ Harness 里有个叫 `web` 的**服务**,它自己不会搜索,只负责「
|
|
|
277
297
|
*技术补充:代理来源依次是配置里的 `proxy`、环境变量 `DSH_WEB_SEARCH_PROXY` / `HTTPS_PROXY` / `ALL_PROXY` / `HTTP_PROXY`、macOS 的 `scutil --proxy`;只支持 HTTP 代理(`CONNECT`),不支持 `socks5://`。*
|
|
278
298
|
|
|
279
299
|
14. **所有设置都能在界面上改,不用编辑文件。**
|
|
280
|
-
设置页有
|
|
281
|
-
*技术补充:
|
|
300
|
+
设置页有 30 个控件,分六组;保存后下一次搜索就生效;只有 `cachePersist` / `cacheFile`(决定缓存接线)和 `toolSurface`(工具注册表在挂载时构建)要重载插件。
|
|
301
|
+
*技术补充:30 个字段全部标了 `.volatile()`,Host 以 live commit 方式原地更新,不重挂载插件;`cacheTtlMs` 与 `cacheEntries` 每次使用都重读;抓取提供方在挂载时取走 `proxy`、`timeoutMs`、`fetchFormat`、`fetchMaxLength`;`renderJs` 与 `renderTimeoutMs` 每次抓取重读;缓存接线也在那时取走 `cachePersist` 与 `cacheFile`。*
|
|
282
302
|
|
|
283
303
|
15. **失败会解释原因,不会静默返回空。**
|
|
284
304
|
一家都没成功时,报错里会列出「试过哪些引擎、各自为什么失败」。
|
|
@@ -290,15 +310,15 @@ Harness 里有个叫 `web` 的**服务**,它自己不会搜索,只负责「
|
|
|
290
310
|
|
|
291
311
|
17. **包、仓库、论文、问答能直接查。**
|
|
292
312
|
问「这个 npm 包还维护吗」「有没有讲 RAG 的论文」时,模型可以用 `domain_search` 直接查 34 个专门的数据源,而不是拿网页搜索碰运气。
|
|
293
|
-
*技术补充:34 个免密钥源,默认开 8 个——`github`、`npm`、`pypi`、`arxiv`、`wikipedia`、`hn`(Hacker News)、`stackexchange`、`crates`(crates.io);其余 26 个通过 `sources` 指定。参数 `query`(必填)、`sources`(可选数组,缺省 = 默认 8 个)、`limit`(可选,默认 5、上限 20
|
|
313
|
+
*技术补充:34 个免密钥源,默认开 8 个——`github`、`npm`、`pypi`、`arxiv`、`wikipedia`、`hn`(Hacker News)、`stackexchange`、`crates`(crates.io);其余 26 个通过 `sources` 指定。参数 `query`(必填)、`sources`(可选数组,缺省 = 默认 8 个)、`limit`(可选,默认 5、上限 20)、`timeRange`(可选 `off`/`day`/`week`/`month`/`year`,只保留窗口内有日期的结果;没有一条有日期时才保留无日期结果,并给出 `note`)。带时间窗时,arXiv 适配器会改用 `submittedDate` 排序并给查询加引号,再做本地日期过滤。每个源独立超时(默认 8000 毫秒),单源失败不影响其他源,失败名单从 `failures` 返回。实测 `react`、limit 3 时 github/npm/arxiv/wikipedia/hn/stackexchange/crates 各 3 条、pypi 1 条。已知限制:PyPI 没有公开搜索 API,只按**精确包名**查(取查询的第一个词);Wikipedia 按提问语言只查单一语言(含中日韩字符查 `zh`,否则查 `en`)。宿主没有 `ctx.tools` 服务时,工具不注册,插件其余功能照常。*
|
|
294
314
|
|
|
295
315
|
18. **可以只看最近发布的结果。**
|
|
296
316
|
设置里选「最近 24 小时 / 7 天 / 30 天 / 1 年」,就只留窗口内发布的结果,适合追新闻和版本更新。
|
|
297
|
-
*技术补充:`timeRange` 五值 `off`(默认)/ `day` / `week` / `month` / `year`,分别是 24 小时、7 天、30 天、1 年;发布日期从各引擎结果里解析(Bing 的摘要日期与 `news_dt`、360 的「发贴时间」、DuckDuckGo 的时间戳与摘要、AnySearch 正文末尾的 `date:`)。DuckDuckGo 把窗口下推成 `df=d/w/m/y` 参数;Bing 与 360 的参数实测无效(页面显示已选中但结果不变),因此这两家与 AnySearch
|
|
317
|
+
*技术补充:`timeRange` 五值 `off`(默认)/ `day` / `week` / `month` / `year`,分别是 24 小时、7 天、30 天、1 年;发布日期从各引擎结果里解析(Bing 的摘要日期与 `news_dt`、360 的「发贴时间」、DuckDuckGo 的时间戳与摘要、AnySearch 正文末尾的 `date:`)。DuckDuckGo 把窗口下推成 `df=d/w/m/y` 参数;Bing 与 360 的参数实测无效(页面显示已选中但结果不变),因此这两家与 AnySearch 走本地过滤。开启后只保留窗口内的**带日期**结果;只有当一条带日期的都没落进窗口时,才退回无日期结果,避免空手而归。这个设置是全局的;`advanced_search` 可以在单次模型调用里临时覆盖(见下一条)。*
|
|
298
318
|
|
|
299
319
|
19. **一次问好几件事,只占一次调用。**
|
|
300
320
|
「比较这三个库」这类问题,模型可以把 1–5 条查询交给 `search_many`,每条查询的结果分开返回;批内最多 3 条同时跑,某一条失败不影响其他条。
|
|
301
|
-
*技术补充:`queries`(1–5 条,必填)、`limit`(默认 5,1–20)、`withSites`(默认 false,为 true 时每条结果附带域名)。`SEARCH_MANY_CONCURRENCY = 3`。每条查询走与 `web_search` 相同的引擎层、缓存和冷却记录;抛出的失败只记进该条查询的 `failures
|
|
321
|
+
*技术补充:`queries`(1–5 条,必填)、`limit`(默认 5,1–20)、`withSites`(默认 false,为 true 时每条结果附带域名)。`SEARCH_MANY_CONCURRENCY = 3`。每条查询走与 `web_search` 相同的引擎层、缓存和冷却记录;抛出的失败只记进该条查询的 `failures`,不会中断整批。查询里明确写了 npm、PyPI 或 crates.io 时,会改走对应的包注册表;注册表没结果时再回退到普通搜索。一次多问用 `search_many`,单问用 `web_search`,查包/论文/问答用 `domain_search`。工具超时 30 秒,声明为可并发。名字被占用时注册为 `web_search_many`;宿主没有 `ctx.tools` 时不注册。*
|
|
302
322
|
|
|
303
323
|
20. **缓存能活过重启。**
|
|
304
324
|
重启 DSH 后十分钟内再问同一个问题,上次的结果还在,不用重新打扰搜索引擎。
|
|
@@ -309,11 +329,114 @@ Harness 里有个叫 `web` 的**服务**,它自己不会搜索,只负责「
|
|
|
309
329
|
*技术补充:`bench/` 下 20 条查询(中文 10、英文 10),四类各 5 条(文档 / 版本发布 / 包与库 / 新闻),每条标注 1–3 个期望域名。`node scripts/bench.mjs` 离线读夹具重放,不联网,输出 precision@8、recall@8、MRR@8 与每个引擎的贡献;`--record` 联网重新录制(每条限速 1.5 秒),用于更新夹具;`--json` 输出机器可读结果,便于版本间对比,历史结果存在 `bench/results/`。当前基线(0.15.0,按 tier 回放):P@8 `0.4375`、R@8 `0.7917`、MRR@8 `0.8071`;中文 `0.4000 / 0.8167 / 0.7976`,英文 `0.4750 / 0.7667 / 0.8167`。另有五条中文长查询的独立诊断集(`bench/queries-long.json`,用 `--queries ... --fixtures ...` 录制):`0.4500 / 1.0000 / 0.7667`,五条都命中期望域名;它与 20 条基线分开保存,避免改变基线的可比性。对照实验和已知短板见附录。*
|
|
310
330
|
|
|
311
331
|
22. **一次调用完成小调研。**
|
|
312
|
-
问「官方文档和另外两个来源到底怎么说」时,`research` 先跑最多三条查询,再用与 `web_fetch` 相同的抓取阶梯打开靠前的页面,最后返回一份证据包:每段摘录下面就是它的 URL。打不开的页面按 URL
|
|
313
|
-
*技术补充:参数 `query`(必填)、`queries`(最多再加三条)、`maxSources`(1–5,默认 3);整次调用共享 45 秒预算,最多 3 个页面并发抓,剩余不足 2.5
|
|
332
|
+
问「官方文档和另外两个来源到底怎么说」时,`research` 先跑最多三条查询,再用与 `web_fetch` 相同的抓取阶梯打开靠前的页面,最后返回一份证据包:每段摘录下面就是它的 URL。打不开的页面按 URL 和原因列出,不会让整份证据包失败;人机验证页和登录跳转页会被拒绝,不会被当作证据引用。
|
|
333
|
+
*技术补充:参数 `query`(必填)、`queries`(最多再加三条)、`maxSources`(1–5,默认 3);整次调用共享 45 秒预算,最多 3 个页面并发抓,剩余不足 2.5 秒就不再开新页。候选行先过相关性门槛;命中查询的政府、学术、标准组织和常见官方文档页面会排在前面,首页/落地页不会仅凭权威度被抬高,完全不相关的官方页面仍会被排除。未用完的查询名额(总共三条)可以补聚焦的官方 `site:` 查询(欧盟/europa、中国网信办、Chrome Releases、Python、Redis、W3C),结果再按发布机构域名过滤。抓取侧每页最多读 20 万字符,摘录选择器因此能找到正文深处的数字或原话;它使用独立的 `http-proxy-research` provider,不会干扰宿主 `web_fetch` 的渲染缓存。W3C WCAG 页面 403 时会经 `w3c.github.io` 重试一次;正文取自这个官方镜像,引用仍给 W3C 原页面。搜索侧复用 `web_search` 的同一条链路、缓存与冷却。若 `research` 名字已被别的插件占用,则注册为 `web_research`。*
|
|
334
|
+
|
|
335
|
+
### 社区与视频平台
|
|
336
|
+
|
|
337
|
+
`platform_search` 是 `domain_search` 的社区/视频版:B 站、V2EX、Reddit、
|
|
338
|
+
YouTube、知乎和掘金能用免密钥公开接口的先用接口,被挡或接口变了就用
|
|
339
|
+
`site:<域名>` 走普通搜索兜底。单个平台失败不会拖垮整批;返回里给出平台、
|
|
340
|
+
URL、摘要和能拿到的日期。兜底结果还会按平台域名过滤,防止普通网页冒充平台
|
|
341
|
+
结果。B 站的 `/search/type` 返回 412 时会再试 `/search/all/v2`;只有查询明确要“最近/高播放”时才做时间过滤和播放量排序;掘金有互动数据时会显示点赞/阅读数。
|
|
342
|
+
|
|
343
|
+
*技术补充:参数 `query`(必填)、`platforms`(可选,六选一或数组)、`limit`
|
|
344
|
+
(1–10,默认 5)。直接请求使用浏览器 UA 和配置的代理,失败后走
|
|
345
|
+
`site:<域名> <query>`;每个平台 8 秒直连超时,工具总预算 40 秒,结果去重后
|
|
346
|
+
按名次交错。名字被占用时注册为 `web_platform_search`。知乎没有可用的免密钥
|
|
347
|
+
搜索接口,只能走兜底;兜底也被挡时会明确报平台失败,而不是静默省略。*
|
|
348
|
+
|
|
349
|
+
### research 正文的二次检索
|
|
350
|
+
|
|
351
|
+
`research` 会抓完整页面,但证据包里只放挑选过的段落;`cache_search` 在进程内
|
|
352
|
+
对这些全文再做一次检索,不再发网络请求。第一次回答需要精确数字、原话或某一
|
|
353
|
+
节时,可以再问 `cache_search`,它返回命中的段落和同一批来源 URL。缓存最多
|
|
354
|
+
24 篇、每篇 40 万字符,7 天过期,插件卸载即清空,不把网页正文写进磁盘。
|
|
355
|
+
|
|
356
|
+
第一次挑选也不是简单截前 6,000 字:research 把正文切成窗口,按查询词打分,
|
|
357
|
+
保留最相关的窗口,再补上开头上下文,保证摘录读得懂。这个过程是确定性的,
|
|
358
|
+
不调用模型。
|
|
359
|
+
|
|
360
|
+
*技术补充:`cache_search` 参数 `query` 和可选 `limit`(1–10,默认 3),返回
|
|
361
|
+
`matches`(`url`、`title`、`snippet`、`score`、`fetchedAt`)。缓存只在内存;
|
|
362
|
+
重启即空。`research` 为此每页最多读取 20 万字符,并通过可选的 `onPage` 回调
|
|
363
|
+
把全文交给缓存。*
|
|
364
|
+
|
|
365
|
+
23. **引擎能不能用,可以直接测。**
|
|
366
|
+
模型工具和设置页按钮都能拿一条短查询逐个问引擎,回报谁答了、多快、其余的为什么没答。它只做诊断:不写缓存、不触发冷却、不回退。
|
|
367
|
+
*技术补充:`engine_test` 可选参数 `engine` 和 `query`,测单个或全部八个(并发 3),返回每个引擎的 `ok`、`latencyMs`、`count`、`failureKind`、`code`、`status`、`reason`。设置页按钮走只监听本机的 `POST /api/dsh-web-search/engine-test` 桥,复用同一个 runner;非 POST、非回环地址和跨站来源都会被拒绝。宿主没有可注入的 `webServer` 时不注册,页面自然没有这个按钮。*
|
|
368
|
+
|
|
369
|
+
24. **失败带类别,回退是策略。**
|
|
370
|
+
以前「被墙」「额度用完」「暂时超时」都会触发同样的回退;现在每次主引擎失败都会分类,你可以决定哪几类才允许切备用引擎。回退被跳过或真的用了,结果里都会说明。
|
|
371
|
+
*技术补充:`FailureKind` 为 `quota` / `auth` / `bot-wall` / `transient` / `invalid-response` / `unknown`,由原有的 `SearchError` code 加 HTTP 状态和消息线索判定。`fallbackOn` 默认六类全开,保持旧的「总是回退」行为;留空表示从不回退。`SearchOutcome.failureDetails` 暴露类别、code 和状态,`note` 解释回退被跳过还是被使用(`search_many` 也会渲染)。冷却时长不变。*
|
|
372
|
+
|
|
373
|
+
25. **可以屏蔽网站,也可以转发安全搜索。**
|
|
374
|
+
把域名加进黑名单,它就会从融合结果和缓存结果里消失;选一个安全搜索级别,Bing 和 DuckDuckGo 会收到。
|
|
375
|
+
*技术补充:`blockedDomains` 是逗号分隔的后缀名单(子域名匹配父域名),在融合之后和缓存命中时过滤,默认为空。`safeSearch` 为 `off`(保持引擎默认)/ `moderate` / `strict`,以 Bing `adlt`、DuckDuckGo `kp` 转发,其它引擎不受影响。非空黑名单和非默认安全搜索都会进入缓存键,所以移除屏蔽不会复用已过滤的缓存;默认路径继续复用旧缓存。*
|
|
376
|
+
|
|
377
|
+
26. **时间窗可以按次指定,不必先改全局设置。**
|
|
378
|
+
只有一条问题需要「最近一周」时,模型可以调用 `advanced_search`,给这一次调用传 `day` / `week` / `month` / `year`,不用动设置。省略窗口就沿用全局 `timeRange`;传 `off` 表示这一次不筛。
|
|
379
|
+
*技术补充:参数是 `query`(必填)、`maxResults`(默认 5,上限 20,且仍受部署 `limit` 限制)、`timeRange`(`off` / `day` / `week` / `month` / `year`;省略 = 设置值)。它和 `web_search` 共用引擎、缓存、冷却与失败路径:`off` 可以复用普通缓存,`week` 会落到自己的缓存键。显式传窗口时,它会从发给引擎的查询里去掉多余的「过去 7 天内」/`last 7 days` 短语(结构化窗口已经表达了时间),但结果里的 `query` 仍是原句。当查询带窗口且明确问 Chrome 安全/发布时,它会读取 Chrome Releases 官方 feed,返回 feed 里的真实发布日期,并在 `note` 里说明标题或摘要是否出现 zero-day;查询明确要 Stable 时,会过滤掉 Beta/Dev/Early Stable/Extended Stable,并在每条摘要前给出帖子写明的版本、修复数和高/中/低危数量。feed 不可用或 Stable 过滤后为空时回退普通引擎。名字被占用时注册为 `web_search_advanced`;宿主没有 `ctx.tools` 时不注册。*
|
|
380
|
+
|
|
381
|
+
27. **网页正文被显式标成不可信数据。**
|
|
382
|
+
插件自有的每个工具现在都把网页来源正文包进 `<untrusted-web-content>...</untrusted-web-content>`,并先剥掉正文里伪造的同名标记;系统提示里再用一小段说明这些内容只是数据,不是指令。
|
|
383
|
+
*技术补充:包装覆盖 `domain_search`、`search_many`、`advanced_search`、`read_page`、`research`、`engine_test` 的 render。包装前会删除正文里的边界标记(包括空白/属性变体),防止网页提前闭合边界。宿主自带的 `web_search` / `web_fetch` 外部内容提示保持原样,插件不重复、也不修改 DSH 结果卡片同样会显示的 `Source` 对象。提示段通过可选的 `systemPrompt` 注入安装;没有该服务的宿主自动跳过。*
|
|
314
384
|
|
|
315
385
|
> **0.13.0 修了什么(一个真实缺陷)**:360(`so`)从部分网络访问会返回验证码页(302 到 qcaptcha 的「访问异常页面」),但 HTTP 状态是 200。旧代码把它当作「0 条结果」静默吞掉:引擎等于消失,冷却也没触发。现在识别到验证码/人机校验页面就报 `SEARCH_BLOCKED` 失败,并把 360 降为**兜底档**(主引擎都空时才尝试),不再拖慢每次搜索。实测:单独查该引擎现在返回失败 `so: bot verification page`,而不是 0 条。
|
|
316
386
|
|
|
387
|
+
## 工具面:一个入口,八个动作
|
|
388
|
+
|
|
389
|
+
0.20.x 改变了模型看到的工具面。上面的八种能力现在是同一个 `web_tools`
|
|
390
|
+
工具的不同 `action`,不再是八个独立注册。调用长这样:
|
|
391
|
+
|
|
392
|
+
```json
|
|
393
|
+
{ "action": "domain_search", "query": "react", "sources": ["github"] }
|
|
394
|
+
```
|
|
395
|
+
|
|
396
|
+
宿主自带的 `web_search` 和 `web_fetch` 保持不变:常用路径不变,但可选的
|
|
397
|
+
工具名从八个压到一个。
|
|
398
|
+
|
|
399
|
+
旧提示词如果直接调用 `domain_search`、`search_many`、`research` 等名字,可以
|
|
400
|
+
在配置里显式回到旧工具面:
|
|
401
|
+
|
|
402
|
+
```yaml
|
|
403
|
+
- id: web-search-bing
|
|
404
|
+
name: '@fffangchenghao/dsh-web-search'
|
|
405
|
+
config:
|
|
406
|
+
toolSurface: legacy
|
|
407
|
+
```
|
|
408
|
+
|
|
409
|
+
默认 `unified`,推荐使用;切换模式需要重载插件,因为注册表在挂载时构建。
|
|
410
|
+
下面文档仍会用这些名字指代能力,默认请读作 `web_tools` 的 action。
|
|
411
|
+
|
|
412
|
+
## 自动更新
|
|
413
|
+
|
|
414
|
+
插件是 DSH bundle,**不会替换自己正在运行的代码**:Node 已经加载
|
|
415
|
+
`lib/index.js`,在进程下面换文件不是安全的更新方式。自动更新属于 profile
|
|
416
|
+
级更新器,而不是插件自己。
|
|
417
|
+
|
|
418
|
+
请使用 npm 安装,不要用 `link:`/本地 checkout:
|
|
419
|
+
|
|
420
|
+
```sh
|
|
421
|
+
dsh plugin --profile web add @fffangchenghao/dsh-web-search@latest
|
|
422
|
+
```
|
|
423
|
+
|
|
424
|
+
然后保持 `dsh-autoupdater`(或 `dsh-self-upgrade`)这类 profile
|
|
425
|
+
更新器开启。它会按计划检查 npm dist-tag,在空闲窗口更新,
|
|
426
|
+
桌面版提示重启。`link:`/`file:` 安装会被这类更新器主动跳过,因为用 registry
|
|
427
|
+
包替换本地 checkout 会破坏开发目录。
|
|
428
|
+
|
|
429
|
+
设置页会显示 npm 最新版。如果它比当前版本新,且页面在本地,还会显示
|
|
430
|
+
**安装更新**按钮。这个按钮不是自己跑 pnpm,而是调用 DSH 内置的
|
|
431
|
+
`pluginManager`(和 `dsh plugin` 同一条路径)安装精确的 npm 包,然后提示重启。
|
|
432
|
+
它**不依赖 `dsh-autoupdater`**;它只是手动的,不会定时轮询。远程 Web 页面
|
|
433
|
+
不显示按钮;`link:`/`file:` 安装会在替换前被拒绝。如果部署没有插件管理器,
|
|
434
|
+
按钮会明确报错,而不是假装更新成功。
|
|
435
|
+
|
|
436
|
+
自动更新是用「少一次人工 review」换「更快拿到修复」:更新器会直接安装 registry
|
|
437
|
+
包,不会等人读 diff。如果你的部署不能接受这个交换,就固定精确版本并关掉
|
|
438
|
+
profile 更新器。插件本身从不 fork/exec `pnpm`;手动按钮只是请 Host 执行安装。
|
|
439
|
+
|
|
317
440
|
## 安装与启用
|
|
318
441
|
|
|
319
442
|
### 你需要什么
|
|
@@ -323,6 +446,17 @@ Harness 里有个叫 `web` 的**服务**,它自己不会搜索,只负责「
|
|
|
323
446
|
- 能正常出网。没有梯子也能用,只是可用的引擎少一两个。
|
|
324
447
|
- 可选:想读靠 JavaScript 渲染的页面,自己装 Playwright(见能力清单第 12 条);不装不影响任何现有功能。
|
|
325
448
|
|
|
449
|
+
### 生产安装(可自动更新)
|
|
450
|
+
|
|
451
|
+
普通用户直接把已发布包加进 profile;想让 profile 更新器管理,就不要用
|
|
452
|
+
`link:`:
|
|
453
|
+
|
|
454
|
+
```sh
|
|
455
|
+
dsh plugin --profile web add @fffangchenghao/dsh-web-search@latest
|
|
456
|
+
```
|
|
457
|
+
|
|
458
|
+
下面是从源码 checkout 开发的路径。
|
|
459
|
+
|
|
326
460
|
### 第一步:构建
|
|
327
461
|
|
|
328
462
|
仓库里的 `main` 指向 `lib/index.js`,而 `lib/` **已经随仓库提交**(DSH STORE 只扫描固定 Commit 的 Git 树,运行产物必须入库),所以拿到代码就能直接跑;只有改了 `src/` 才需要重新构建:
|
|
@@ -409,7 +543,7 @@ pnpm install
|
|
|
409
543
|
|
|
410
544
|
三个办法,任选:
|
|
411
545
|
|
|
412
|
-
1. **看设置页**:设置 → 「网页搜索(Bing
|
|
546
|
+
1. **看设置页**:设置 → 「网页搜索(Bing)」,能看到六组、共 30 个控件,说明插件被加载了,schema 也被 Host 收录了。
|
|
413
547
|
2. **看日志**:启动日志里没有 `1 entry did not activate` 这类警告。
|
|
414
548
|
3. **直接试**:问一个明显需要联网的问题,比如「帮我搜一下 DSH 插件开发教程,给我链接」。看模型有没有调用 `web_search`,返回的链接是不是真实可达。
|
|
415
549
|
|
|
@@ -417,17 +551,18 @@ pnpm install
|
|
|
417
551
|
|
|
418
552
|
## 设置页怎么用
|
|
419
553
|
|
|
420
|
-
打开 设置 → 「网页搜索(Bing)」。页面上一共
|
|
554
|
+
打开 设置 → 「网页搜索(Bing)」。页面上一共 30 个控件,按六组排列,外加一个**引擎健康**检查。顶部有一条随滚动固定的跳转栏,点组名直接跳过去;标题下还会拿当前版本和 npm 上的最新版比一下(连不上 npm 时这行不显示,不会瞎猜)。每组只管一类事:
|
|
421
555
|
|
|
422
556
|
| 组 | 控件数 | 这组管什么 |
|
|
423
557
|
| --- | --- | --- |
|
|
424
|
-
| 引擎与传输 |
|
|
558
|
+
| 引擎与传输 | 9 | 用哪些搜索引擎、等多久、走不走代理、AnySearch 的凭据和垂直域 |
|
|
425
559
|
| 结果与排序 | 7 | 返回几条、只看多久内、怎么合并排序、官方文档和新内容加权多少 |
|
|
426
560
|
| 专用检索 | 3 | `domain_search` 查哪些源、每个源返回几条、每个源等多久 |
|
|
427
561
|
| 抓取 | 4 | `web_fetch` 返回 Markdown 还是纯文本、最多返回多少字符、要不要用浏览器渲染空壳页面、渲染最多等多久 |
|
|
428
562
|
| 缓存与冷却 | 6 | 结果记多久、记多少条、要不要写进硬盘、被限流后歇多久 |
|
|
563
|
+
| 模型工具 | 1 | 八种可选能力是统一成一个 `web_tools`,还是保留旧的八个工具名;切换后要重载 |
|
|
429
564
|
|
|
430
|
-
### 引擎与传输(
|
|
565
|
+
### 引擎与传输(9 个)
|
|
431
566
|
|
|
432
567
|
| 控件 | 配置键 | 默认 | 人话 |
|
|
433
568
|
| --- | --- | --- | --- |
|
|
@@ -437,13 +572,16 @@ pnpm install
|
|
|
437
572
|
| 代理(中转站) | `proxy` | 空(自动探测) | 如 `http://127.0.0.1:7890`;留空先读环境变量再读系统代理 |
|
|
438
573
|
| AnySearch 通行证 | `anysearchApiKey` | 空(匿名) | 可选项。只发给 `api.anysearch.com`,用于提高额度、解锁正文抽取。可以用逗号分隔填多个 key,插件轮流使用;某个被限流或拒绝会自动休息 |
|
|
439
574
|
| 专业领域 | `anysearchDomain` | 空(通用) | 常见取值 `finance` / `academic` / `security` / `legal` / `code`,可带子域如 `finance.us_stock` |
|
|
575
|
+
| 屏蔽网站 | `blockedDomains` | 空(不屏蔽) | 永远不要出现在结果里的网站,逗号分隔;子域名会一起屏蔽。在融合之后和缓存命中时都会过滤,所以被屏蔽的行不会从缓存里回来 |
|
|
576
|
+
| 安全搜索 | `safeSearch` | `off` | `off` 保持引擎默认;`moderate` / `strict` 会以 Bing `adlt`、DuckDuckGo `kp` 转发,其它引擎忽略 |
|
|
577
|
+
| 哪些失败可回退 | `fallbackOn` | 六类全开 | 允许切备用引擎的失败类别:`quota`、`auth`、`bot-wall`、`transient`、`invalid-response`、`unknown`。留空表示任何失败都不回退;被跳过的回退会写进结果的 `note` |
|
|
440
578
|
|
|
441
579
|
### 结果与排序(7 个)
|
|
442
580
|
|
|
443
581
|
| 控件 | 配置键 | 默认 | 人话 |
|
|
444
582
|
| --- | --- | --- | --- |
|
|
445
583
|
| 返回几条 | `limit` | `8` | 最多返回几条,1–20;调用方要得更少时以调用方为准 |
|
|
446
|
-
| 只看多久内 | `timeRange` | `off` | `off` 不限;`day` 最近 24 小时、`week` 7 天、`month` 30 天、`year` 1
|
|
584
|
+
| 只看多久内 | `timeRange` | `off` | `off` 不限;`day` 最近 24 小时、`week` 7 天、`month` 30 天、`year` 1 年。开了只留窗口内的结果。`advanced_search` 可以给单条查询临时覆盖 |
|
|
447
585
|
| 结果混合力度 | `rrfConstant` | `60` | 越大越平均,越小越偏向各引擎的头部结果 |
|
|
448
586
|
| 可信网站名单 | `authorityDomains` | 空(用内置列表) | 在内置的官方文档域名之外,追加你想加权的域名 |
|
|
449
587
|
| 可信网站加分 | `authorityBoost` | `0.25` | 命中可信域名时乘 `1 + 这个值`,0–10 |
|
|
@@ -478,9 +616,15 @@ pnpm install
|
|
|
478
616
|
| 被拒后歇多久 | `baseCooldownMs` | `300000` | 被限流后第一次歇多久,5 分钟 |
|
|
479
617
|
| 歇息上限 | `maxCooldownMs` | `1800000` | 连续失败时冷却翻倍的上限,30 分钟 |
|
|
480
618
|
|
|
619
|
+
### 模型工具(1 个)
|
|
620
|
+
|
|
621
|
+
| 控件 | 配置键 | 默认 | 人话 |
|
|
622
|
+
| --- | --- | --- | --- |
|
|
623
|
+
| 工具面 | `toolSurface` | `unified` | `unified` 只注册一个 `web_tools`,用八个 action;`legacy` 保留旧的八个独立工具名,兼容旧提示词。切换会重建注册表,保存后要重载插件 |
|
|
624
|
+
|
|
481
625
|
### 给你的建议
|
|
482
626
|
|
|
483
|
-
**只想正常用:
|
|
627
|
+
**只想正常用:30 个控件全都别改,默认值就是调过的。**
|
|
484
628
|
|
|
485
629
|
只有这些情况值得动:
|
|
486
630
|
|
|
@@ -495,7 +639,7 @@ pnpm install
|
|
|
495
639
|
三个提醒:
|
|
496
640
|
|
|
497
641
|
- 保存是即时的,下一次搜索就按新值走,不用重启——只有 `cachePersist` 和 `cacheFile` 例外,它们决定缓存怎么接线,在插件挂载时读取。
|
|
498
|
-
-
|
|
642
|
+
- 但**排序类的改动可能被缓存挡住**:缓存键里有 `lead|wait|limit|引擎集合|时间窗|query` 这些字段,但没有排序参数。同一个问题十分钟内再问,拿到的还是旧顺序——开了持久化后,重启 DSH 也清不掉。换个问法,或者等十分钟。改时间窗会换一个键,所以不受旧缓存影响。
|
|
499
643
|
- **`web_fetch` 不能从中间续读**:它对一个网址只发一次请求,尾巴缺了可以调大 `fetchMaxLength`,也可以用 `read_page` 从断点接着读;抓一个更窄的页面仍然最省上下文。
|
|
500
644
|
|
|
501
645
|
## 常见问题 FAQ
|
|
@@ -855,10 +999,15 @@ Node 的全局 `fetch` 既不读 macOS 系统代理,也不读 `HTTPS_PROXY`—
|
|
|
855
999
|
- **基准只有 20 条查询**:新闻类 recall 0.367,`zh-linux-612` 0 命中;参数差异只值 1–4 个命中时不足以区分版本。它用来判断方向,不是统计显著性。
|
|
856
1000
|
- **`search_many` 一次最多 5 条查询,批内最多 3 条并发。**
|
|
857
1001
|
- **两个进程共用一个缓存文件是后写覆盖**:不会写坏文件,但一个进程较新的快照可能被另一个进程较旧的快照盖掉。
|
|
858
|
-
-
|
|
1002
|
+
- **时间窗只能过滤「有日期」的结果**:日期从结果页解析,引擎不给日期时这条就没有年龄信息;窗口内一条带日期的都没有时会退回无日期结果,并在 `Note` 中说明这些行没有被证明落在窗口内。Bing 与 360 的时间参数实测无效,真正下推的只有 DuckDuckGo 的 `df=`。
|
|
1003
|
+
- **领域搜索是发现,不是完整记录**:GitHub 搜索不返回 release tag,Wikipedia 搜索不返回修订时间,Hacker News 搜索不返回最高赞评论,Stack Overflow 搜索不返回 accepted answer 正文;要精确记录时用 `web_fetch` 或 `read_page` 追一层。
|
|
859
1004
|
- **PyPI 只支持精确包名**:它没有公开搜索 API,插件取查询的第一个词当包名;拼错就是空结果。
|
|
860
1005
|
- **Wikipedia 只查单一语言**:含中日韩字符查 `zh`,否则查 `en`。
|
|
861
|
-
-
|
|
1006
|
+
- **社区平台是尽力而为**:B 站、V2EX、Reddit、YouTube、掘金会改接口或拦截自动请求;工具会退到限定域名的网页搜索,并按平台域名过滤。知乎在本环境没有可用的免密钥 API,只能走兜底,仍可能一条都拿不到。
|
|
1007
|
+
- **`cache_search` 只在进程内**:research 正文最多保留 7 天、24 篇、每篇 40 万字符,重启即消失;不会写进搜索结果缓存。
|
|
1008
|
+
- **官方站补查有边界**:`research` 只对少数发布机构(欧盟、网信办、Chrome Releases、Python、Redis、W3C)补聚焦 `site:` 查询,其他官方机构仍靠普通排序。
|
|
1009
|
+
- **时间窗不能凭空造日期**:所有结果都没有日期时,`advanced_search` / `domain_search` 会在 `note` 里说明,不会把无日期结果说成在窗口内。
|
|
1010
|
+
- **插件自有工具都依赖宿主提供工具注册表**:没有 `ctx.tools` 时 `domain_search`、`search_many`、`advanced_search`、`read_page`、`research`、`cache_search`、`platform_search`、`engine_test` 都不注册,`web_search` 不受影响。
|
|
862
1011
|
- **AnySearch 匿名调用每次最多 10 条。**
|
|
863
1012
|
- **只支持 HTTP 代理**,不支持 `socks5://`。
|
|
864
1013
|
- **`limit` 上限 20;`domainLimit` 上限也是 20。**
|
|
@@ -869,6 +1018,9 @@ Node 的全局 `fetch` 既不读 macOS 系统代理,也不读 `HTTPS_PROXY`—
|
|
|
869
1018
|
| --- | --- |
|
|
870
1019
|
| 返回条数 `limit` | `8`(1–20) |
|
|
871
1020
|
| 时间窗 `timeRange` | `off`(不限;`day` / `week` / `month` / `year`) |
|
|
1021
|
+
| `domain_search` 时间窗 | 省略(不做本地过滤);`off` / `day` / `week` / `month` / `year` |
|
|
1022
|
+
| `platform_search` 条数 | `5`(1–10) |
|
|
1023
|
+
| research 正文缓存 | 24 篇、每篇 40 万字符、7 天,仅内存 |
|
|
872
1024
|
| 专用源条数 `domainLimit` | `5`(1–20) |
|
|
873
1025
|
| 专用源超时 `domainTimeoutMs` | `8000` 毫秒 |
|
|
874
1026
|
| 缓存有效期 `cacheTtlMs` | `600000` 毫秒 = 600 秒 |
|
package/SECURITY.md
CHANGED
|
@@ -8,7 +8,7 @@ for anyone auditing the fixed commit that DSH STORE scans.
|
|
|
8
8
|
|
|
9
9
|
| dependency | why | note |
|
|
10
10
|
|---|---|---|
|
|
11
|
-
| `@deepseek-ai/schemastery` | defines the
|
|
11
|
+
| `@deepseek-ai/schemastery` | defines the 29 configuration fields and validates them | the same schema library the Harness itself uses; no transitive dependencies of its own |
|
|
12
12
|
|
|
13
13
|
There are no other runtime or optional runtime dependencies. Playwright is
|
|
14
14
|
**not** a dependency: rendering turns on only when the user has already installed
|
|
@@ -32,11 +32,24 @@ Outbound TCP/HTTPS only, plus one local system query described below.
|
|
|
32
32
|
| `api.firecrawl.dev` | key-free search API, fallback tier |
|
|
33
33
|
| `api.github.com`, `registry.npmjs.org`, `pypi.org`, `export.arxiv.org`, `*.wikipedia.org`, `hn.algolia.com`, `api.stackexchange.com`, `crates.io` | the eight default `domain_search` sources |
|
|
34
34
|
| `gitlab.com`, `codeberg.org`, `hub.docker.com`, `search.maven.org`, `azuresearch-usnc.nuget.org`, `rubygems.org`, `packagist.org`, `pub.dev`, `huggingface.co`, `open-vsx.org`, `registry.terraform.io`, `api.wordpress.org`, `plugins.jetbrains.com`, `api.openalex.org`, `api.crossref.org`, `www.ebi.ac.uk`, `rest.uniprot.org`, `clinicaltrials.gov`, `services.nvd.nist.gov`, `api.coingecko.com`, `archive.org`, `www.wikidata.org`, `nominatim.openstreetmap.org` | the 26 opt-in `domain_search` sources; contacted only when named in `sources` or `domainSources` |
|
|
35
|
+
| `api.bilibili.com`, `www.bilibili.com`, `www.v2ex.com`, `www.reddit.com`, `www.youtube.com`, `api.juejin.cn`, `juejin.cn` | `platform_search` direct keyless endpoints; Zhihu has no direct call and uses the search fallback |
|
|
36
|
+
| `chromereleases.googleblog.com` | official Chrome Releases feed for a windowed Chrome security query in `advanced_search` |
|
|
37
|
+
| `www.postgresql.org` | official PostgreSQL versioning table for a version/EOL query in `web_search` |
|
|
38
|
+
| `ai-act-service-desk.ec.europa.eu` | official AI Act Article 113 page when a clause/effective-date question names the AI Act |
|
|
39
|
+
| `w3c.github.io` | read-only mirror of W3C WCAG pages when `www.w3.org` answers 403 |
|
|
35
40
|
| `api.anysearch.com` | optional: search and page extraction, **only when an AnySearch key is configured** |
|
|
36
41
|
| your configured proxy | HTTP `CONNECT` tunnel for the hosts above |
|
|
37
42
|
|
|
38
43
|
`web_fetch` and `read_page` reach **any** HTTP(S) URL the model asks for; that is
|
|
39
|
-
their purpose.
|
|
44
|
+
their purpose. `engine_test` sends its probe query to the engines it tests, just
|
|
45
|
+
like a normal search; `advanced_search` is an ordinary search with a per-call
|
|
46
|
+
date window, except a windowed Chrome security/release query may read the
|
|
47
|
+
official Chrome Releases feed above. The Settings page's engine test uses an **inbound**,
|
|
48
|
+
loopback-only route on the host's own `webServer` (`POST
|
|
49
|
+
/api/dsh-web-search/engine-test`); the plugin never opens a listening socket
|
|
50
|
+
itself and the route refuses non-POST, non-loopback and cross-origin requests.
|
|
51
|
+
|
|
52
|
+
With `useProxy` enabled they speak to the configured proxy
|
|
40
53
|
(default `127.0.0.1:7890`, auto-detected) using HTTP `CONNECT`; a 400 ms TCP
|
|
41
54
|
connect first checks that the proxy port is listening so a stale setting cannot
|
|
42
55
|
stall a search. The plugin never contacts an analytics, telemetry, or update
|
|
@@ -70,17 +83,32 @@ The only credential is an optional AnySearch key. It lives where you put it —
|
|
|
70
83
|
the profile's `cordis.patch.yml` — is read at mount time, is sent only to
|
|
71
84
|
`api.anysearch.com` as a `Bearer` token, and is never logged; failure messages
|
|
72
85
|
redact it. The plugin does not read the keychain, environment tokens, or session
|
|
73
|
-
credentials, and it writes no credential anywhere.
|
|
86
|
+
credentials, and it writes no credential anywhere. A short optional system-prompt
|
|
87
|
+
section is registered through the host `systemPrompt` service; it contains only
|
|
88
|
+
static guidance and no user data.
|
|
89
|
+
|
|
90
|
+
## Untrusted content
|
|
91
|
+
|
|
92
|
+
Search results and page bodies are attacker-controlled text. The plugin's own
|
|
93
|
+
tool renders wrap that text in `<untrusted-web-content>...</untrusted-web-content>`
|
|
94
|
+
and remove forged boundary tags from the payload before wrapping, so a page
|
|
95
|
+
cannot close the boundary early. A short system-prompt section states that
|
|
96
|
+
content inside the boundary is data, not instructions; it does not repeat the
|
|
97
|
+
tool definitions. The host's own notice for `web_search` / `web_fetch` is left
|
|
98
|
+
untouched. This is a boundary, not a guarantee that a model will never be
|
|
99
|
+
influenced by text; it makes the trust level explicit and testable.
|
|
74
100
|
|
|
75
101
|
## Files
|
|
76
102
|
|
|
77
103
|
| path | what | bounds |
|
|
78
104
|
|---|---|---|
|
|
79
105
|
| `$DSH_HOME/cache/dsh-web-search/cache.json` | search result snapshot so a restart does not lose the cache | 4 MiB, versioned, atomic replace, pruned by TTL and entry count |
|
|
106
|
+
| process memory only | `research` body cache used by `cache_search` | at most 24 pages, 400,000 characters each, 7-day TTL, cleared on unload |
|
|
80
107
|
| nothing else | settings live in the profile patch; there is no plugin-owned config file | — |
|
|
81
108
|
|
|
82
|
-
The cache holds queries and result rows only — no page bodies, no headers,
|
|
83
|
-
cookies.
|
|
109
|
+
The on-disk cache holds queries and result rows only — no page bodies, no headers,
|
|
110
|
+
no cookies. Fetched research bodies exist only in process memory for
|
|
111
|
+
`cache_search`; they are never written to disk.
|
|
84
112
|
|
|
85
113
|
## Failure bounds
|
|
86
114
|
|
|
@@ -91,8 +119,14 @@ cookies.
|
|
|
91
119
|
| one fetch | 25 s for the whole ladder (direct 5 s, tunnel, render, extraction share it) |
|
|
92
120
|
| response body | 2 MiB read cap before decoding, 20 000 characters returned by default |
|
|
93
121
|
| `read_page` | 2 000 000 characters per page, 8-page LRU, chunked reads |
|
|
122
|
+
| one `research` page | 200 000 characters fetched for passage selection; the published excerpt is about 6 000 characters |
|
|
123
|
+
| `research` body cache | 24 pages, 400 000 characters each, 7-day TTL, in memory only |
|
|
124
|
+
| one `platform_search` | 40 s tool budget; 8 s per direct platform attempt |
|
|
94
125
|
| cache | TTL and entry count are bounded and both configurable, `0` disables |
|
|
95
126
|
| system proxy probe | 2 s, then the child is killed |
|
|
127
|
+
| engine test bridge request | loopback only, POST only, 16 KiB JSON body |
|
|
128
|
+
| one engine test | 8 s per engine, three probes in flight, no cache or cooldown writes |
|
|
129
|
+
| one advanced_search | 30 s tool budget, same engine deadlines as web_search |
|
|
96
130
|
|
|
97
131
|
Failures are reported as structured codes (`SEARCH_THROTTLED`, `SEARCH_BLOCKED`,
|
|
98
132
|
`SEARCH_TIMEOUT`, `SEARCH_NETWORK`, `SEARCH_PARSE`, `SEARCH_EMPTY`,
|
|
@@ -105,8 +139,9 @@ than returned as noise; an empty 200 response is an error, not a success.
|
|
|
105
139
|
- No telemetry, no analytics, no update check, no remote configuration.
|
|
106
140
|
- No reading of the user's files, browser profile, cookies, or session logs.
|
|
107
141
|
- No modification of the Harness, its shipped plugins, or other plugins' entries.
|
|
108
|
-
It registers one search provider, one fetch provider, and
|
|
109
|
-
(`
|
|
142
|
+
It registers one search provider, one fetch provider, and eight tools
|
|
143
|
+
(`domain_search`, `search_many`, `advanced_search`, `read_page`, `research`,
|
|
144
|
+
`cache_search`, `platform_search`, `engine_test`) through public seams.
|
|
110
145
|
- No hidden network destinations: the table above is exhaustive.
|
|
111
146
|
|
|
112
147
|
## Reporting
|