tileops 0.0.1.dev0__tar.gz → 0.0.1.dev1__tar.gz
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- tileops-0.0.1.dev1/PKG-INFO +26 -0
- tileops-0.0.1.dev1/README.md +119 -0
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/pyproject.toml +28 -15
- tileops-0.0.1.dev1/setup.py +44 -0
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_blocksparse_attention.py +15 -8
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_gqa.py +18 -10
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_linear_attn_fused_chunk.py +0 -3
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_linear_attn_fused_recurrent.py +0 -3
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_mamba_chunk_scan.py +0 -3
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_mamba_chunk_state.py +0 -3
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_mha.py +5 -7
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_mha_decode.py +5 -7
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_mla.py +0 -3
- tileops-0.0.1.dev1/tests/test_sparse_mla.py +57 -0
- tileops-0.0.1.dev1/tileops.egg-info/PKG-INFO +26 -0
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tileops.egg-info/SOURCES.txt +15 -1
- tileops-0.0.1.dev1/tileops.egg-info/requires.txt +18 -0
- tileops-0.0.1.dev1/tileops.egg-info/top_level.txt +4 -0
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/top/__init__.py +4 -6
- tileops-0.0.1.dev1/top/kernel/__init__.py +15 -0
- tileops-0.0.1.dev1/top/kernel/bitnet.py +490 -0
- tileops-0.0.1.dev1/top/kernel/blocksparse_attention.py +605 -0
- tileops-0.0.1.dev1/top/kernel/gqa.py +1079 -0
- tileops-0.0.1.dev1/top/kernel/linear_attention/__init__.py +0 -0
- tileops-0.0.1.dev1/top/kernel/linear_attention/linear_attn.py +490 -0
- tileops-0.0.1.dev1/top/kernel/mamba_chunk_scan.py +335 -0
- tileops-0.0.1.dev1/top/kernel/mamba_chunk_state.py +269 -0
- tileops-0.0.1.dev1/top/kernel/mha.py +920 -0
- tileops-0.0.1.dev1/top/kernel/mla.py +311 -0
- tileops-0.0.1.dev1/top/kernel/sparse_mla.py +502 -0
- tileops-0.0.1.dev1/top/utils/__init__.py +1 -0
- tileops-0.0.1.dev1/top/utils/utils.py +55 -0
- tileops-0.0.1.dev0/PKG-INFO +0 -82
- tileops-0.0.1.dev0/README.md +0 -65
- tileops-0.0.1.dev0/setup.py +0 -33
- tileops-0.0.1.dev0/tileops.egg-info/PKG-INFO +0 -82
- tileops-0.0.1.dev0/tileops.egg-info/requires.txt +0 -2
- tileops-0.0.1.dev0/tileops.egg-info/top_level.txt +0 -1
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/LICENSE +0 -0
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/setup.cfg +0 -0
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_bitnet.py +0 -0
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tests/test_gqa_decode.py +0 -0
- {tileops-0.0.1.dev0 → tileops-0.0.1.dev1}/tileops.egg-info/dependency_links.txt +0 -0
|
@@ -0,0 +1,26 @@
|
|
|
1
|
+
Metadata-Version: 2.4
|
|
2
|
+
Name: tileops
|
|
3
|
+
Version: 0.0.1.dev1
|
|
4
|
+
Summary: TileOPs kernels for efficient inference
|
|
5
|
+
Author: Tile-AI
|
|
6
|
+
License-Expression: MIT
|
|
7
|
+
Requires-Python: >=3.8
|
|
8
|
+
License-File: LICENSE
|
|
9
|
+
Requires-Dist: torch>=2.1.0
|
|
10
|
+
Requires-Dist: numpy>=1.23.5
|
|
11
|
+
Requires-Dist: einops>=0.6.0
|
|
12
|
+
Requires-Dist: Cython
|
|
13
|
+
Requires-Dist: tqdm>=4.62.3
|
|
14
|
+
Requires-Dist: typing_extensions>=4.10.0
|
|
15
|
+
Requires-Dist: cloudpickle
|
|
16
|
+
Requires-Dist: ml_dtypes
|
|
17
|
+
Requires-Dist: psutil
|
|
18
|
+
Requires-Dist: tilelang>=0.1.6.post1
|
|
19
|
+
Provides-Extra: dev
|
|
20
|
+
Requires-Dist: yapf==0.40.2; extra == "dev"
|
|
21
|
+
Requires-Dist: toml==0.10.2; extra == "dev"
|
|
22
|
+
Requires-Dist: tomli==2.0.1; extra == "dev"
|
|
23
|
+
Requires-Dist: ruff==0.6.5; extra == "dev"
|
|
24
|
+
Requires-Dist: codespell==2.3.0; extra == "dev"
|
|
25
|
+
Requires-Dist: clang-format==15.0.7; extra == "dev"
|
|
26
|
+
Dynamic: license-file
|
|
@@ -0,0 +1,119 @@
|
|
|
1
|
+
# TileOPs (TOP)
|
|
2
|
+
|
|
3
|
+
**TileOPs (TOP)** is a high-performance machine learning operator collections built on top of [TileLang](https://github.com/tile-ai/tilelang). It offers efficient, modular, and composable implementations optimized for AI workloads.
|
|
4
|
+
|
|
5
|
+
Note: TileOPs is still under rapid development.
|
|
6
|
+
|
|
7
|
+
---
|
|
8
|
+
|
|
9
|
+
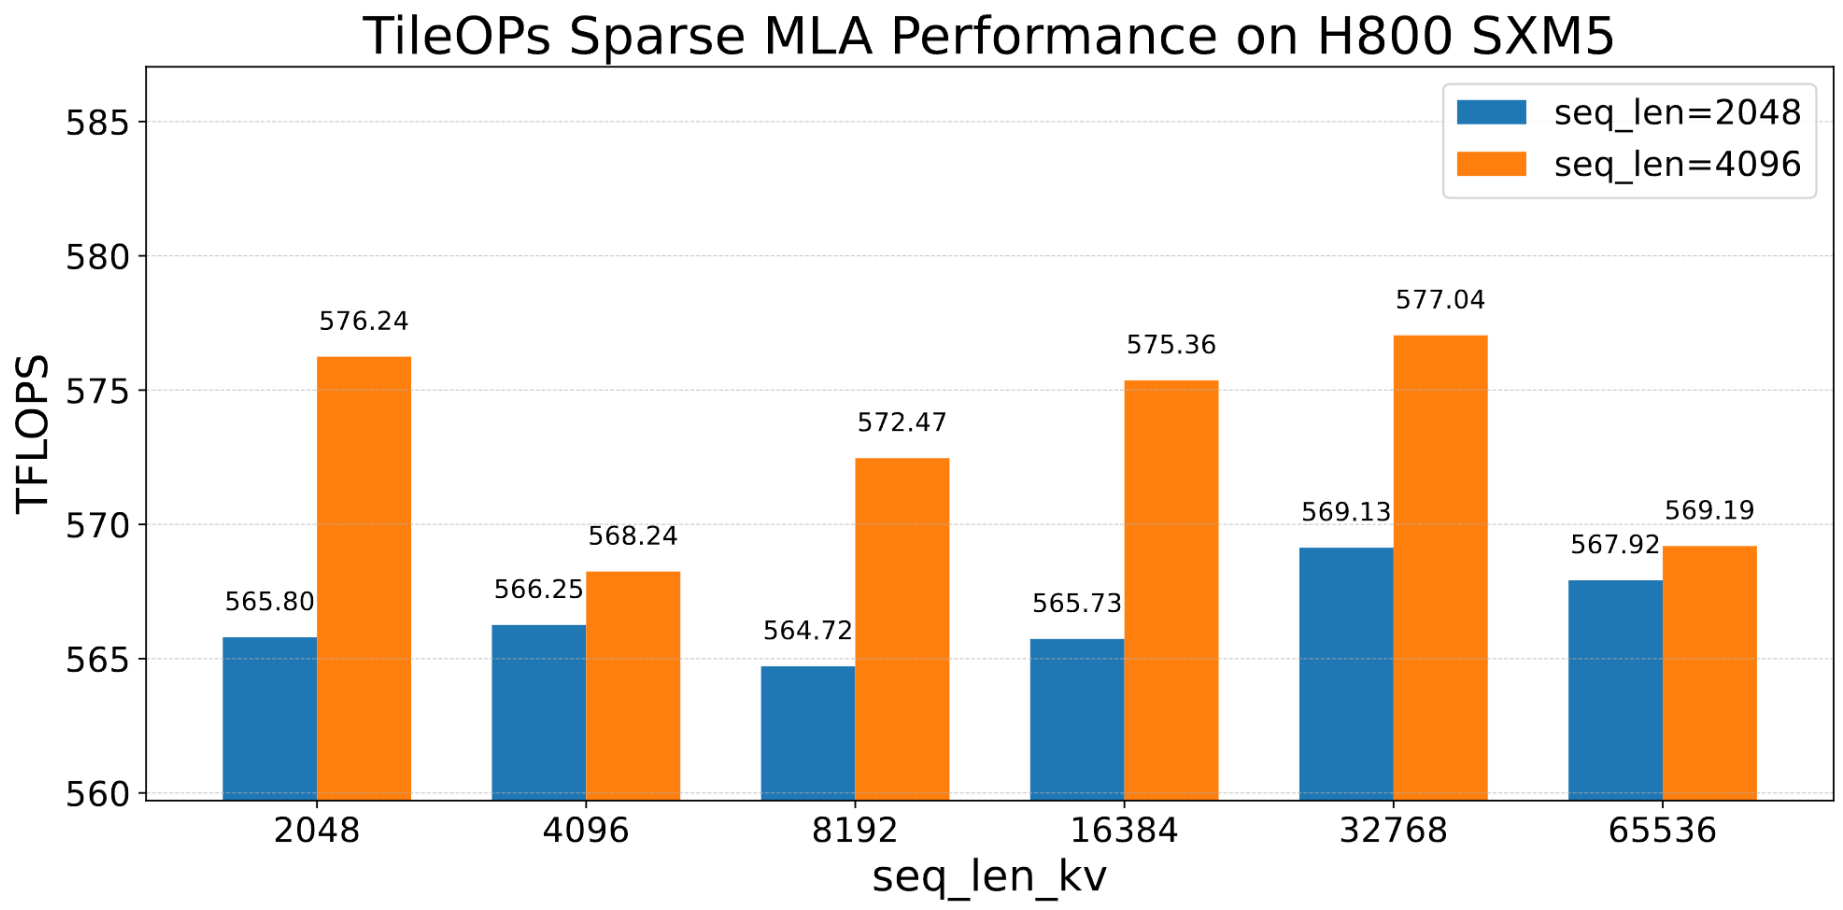
|
|
10
|
+
*DeepSeek-V3.2-Exp DeepSeek Sparse Attention (DSA) performance on H800 SXM*
|
|
11
|
+
|
|
12
|
+
## 📦 Installation
|
|
13
|
+
|
|
14
|
+
### Requirements
|
|
15
|
+
|
|
16
|
+
- Python 3.8+
|
|
17
|
+
- PyTorch >= 2.1
|
|
18
|
+
- GLIBCXX_3.4.32
|
|
19
|
+
- [TileLang](https://github.com/tile-ai/tilelang)
|
|
20
|
+
|
|
21
|
+
### Method 1: Install with Pip
|
|
22
|
+
|
|
23
|
+
```bash
|
|
24
|
+
pip install tileops
|
|
25
|
+
```
|
|
26
|
+
|
|
27
|
+
### Method 2: Install from source (editable mode for development)
|
|
28
|
+
|
|
29
|
+
```bash
|
|
30
|
+
git clone https://github.com/tile-ai/TileOPs
|
|
31
|
+
cd TileOPs
|
|
32
|
+
pip install -e '.[dev]' -v # remove -e option if you don't want to install in editable mode, -v for verbose output
|
|
33
|
+
```
|
|
34
|
+
|
|
35
|
+
## 🚀 Quick Usage
|
|
36
|
+
|
|
37
|
+
### Sparse MLA
|
|
38
|
+
|
|
39
|
+
```python
|
|
40
|
+
import torch
|
|
41
|
+
from top import SparseMLAKernel
|
|
42
|
+
|
|
43
|
+
batch_size = 1
|
|
44
|
+
seq_len = 1024
|
|
45
|
+
seq_len_kv = 2048
|
|
46
|
+
q_start_index_s = 1024
|
|
47
|
+
n_heads = 128
|
|
48
|
+
head_dim = 512
|
|
49
|
+
tail_dim = 64
|
|
50
|
+
topk = 2048
|
|
51
|
+
kv_stride = 1
|
|
52
|
+
kv_group = 1
|
|
53
|
+
sm_scale = None
|
|
54
|
+
|
|
55
|
+
sparse_mla = SparseMLAKernel(
|
|
56
|
+
batch=batch_size,
|
|
57
|
+
seq_len=seq_len,
|
|
58
|
+
seq_len_kv=seq_len_kv,
|
|
59
|
+
q_start_index_s=q_start_index_s,
|
|
60
|
+
heads=n_heads,
|
|
61
|
+
dim=head_dim,
|
|
62
|
+
tail_dim=tail_dim,
|
|
63
|
+
topk=topk,
|
|
64
|
+
kv_stride=kv_stride,
|
|
65
|
+
kv_group=kv_group,
|
|
66
|
+
sm_scale=sm_scale,
|
|
67
|
+
is_casual=True,
|
|
68
|
+
dtype=torch.bfloat16,
|
|
69
|
+
device='cuda',
|
|
70
|
+
)
|
|
71
|
+
|
|
72
|
+
# Evaluate the Sparse MLA kernel performance
|
|
73
|
+
sparse_mla.check()
|
|
74
|
+
latency = sparse_mla.profile()
|
|
75
|
+
print(f"Latency: {latency:.4f} ms")
|
|
76
|
+
print(f'fwd tflops = ',
|
|
77
|
+
(batch_size * seq_len * (head_dim + tail_dim + head_dim) * topk * 2 * n_heads) / (latency * 1e-3) / 1e12)
|
|
78
|
+
```
|
|
79
|
+
|
|
80
|
+
### MLA
|
|
81
|
+
|
|
82
|
+
```python
|
|
83
|
+
import torch
|
|
84
|
+
import top
|
|
85
|
+
from top import MLAKernel
|
|
86
|
+
|
|
87
|
+
device = "cuda"
|
|
88
|
+
dtype = torch.float16
|
|
89
|
+
|
|
90
|
+
batch = 128
|
|
91
|
+
heads = 64
|
|
92
|
+
kv_heads = 1
|
|
93
|
+
kv_ctx = 8192
|
|
94
|
+
dim = 512
|
|
95
|
+
pe_dim = 64
|
|
96
|
+
|
|
97
|
+
# Query input: [batch, heads, dim]
|
|
98
|
+
q = torch.randn(batch, heads, dim, device=device, dtype=dtype)
|
|
99
|
+
|
|
100
|
+
# Query positional encoding: [batch, heads, pe_dim]
|
|
101
|
+
q_pe = torch.randn(batch, heads, pe_dim, device=device, dtype=dtype)
|
|
102
|
+
|
|
103
|
+
# KV cache input: [batch, kv_ctx, kv_heads, dim]
|
|
104
|
+
kv = torch.randn(batch, kv_ctx, kv_heads, dim, device=device, dtype=dtype)
|
|
105
|
+
|
|
106
|
+
# KV positional encoding: [batch, kv_ctx, kv_heads, pe_dim]
|
|
107
|
+
k_pe = torch.randn(batch, kv_ctx, kv_heads, pe_dim, device=device, dtype=dtype)
|
|
108
|
+
|
|
109
|
+
# Use MLA kernel
|
|
110
|
+
block_N = 64
|
|
111
|
+
block_H = 64
|
|
112
|
+
num_split = 1
|
|
113
|
+
|
|
114
|
+
mla = MLAKernel(batch, heads, kv_heads, kv_ctx, dim, pe_dim, block_N, block_H, num_split)
|
|
115
|
+
|
|
116
|
+
out = mla(q, q_pe, kv, k_pe)
|
|
117
|
+
```
|
|
118
|
+
|
|
119
|
+
## Acknowledgments
|
|
@@ -1,21 +1,41 @@
|
|
|
1
1
|
[project]
|
|
2
2
|
name = "tileops"
|
|
3
|
-
version = "0.0.1.
|
|
3
|
+
version = "0.0.1.dev1"
|
|
4
4
|
description = "TileOPs kernels for efficient inference"
|
|
5
|
-
authors = [{ name="Tile-AI"
|
|
6
|
-
|
|
5
|
+
authors = [{ name="Tile-AI"}]
|
|
6
|
+
dependencies = [
|
|
7
|
+
"torch>=2.1.0",
|
|
8
|
+
"numpy>=1.23.5",
|
|
9
|
+
"einops>=0.6.0",
|
|
10
|
+
"Cython",
|
|
11
|
+
"tqdm>=4.62.3",
|
|
12
|
+
"typing_extensions>=4.10.0",
|
|
13
|
+
"cloudpickle",
|
|
14
|
+
"ml_dtypes",
|
|
15
|
+
"psutil",
|
|
16
|
+
"tilelang>=0.1.6.post1"
|
|
17
|
+
]
|
|
7
18
|
requires-python = ">=3.8"
|
|
8
19
|
license = "MIT"
|
|
9
|
-
|
|
10
|
-
|
|
11
|
-
|
|
12
|
-
|
|
20
|
+
|
|
21
|
+
[project.optional-dependencies]
|
|
22
|
+
dev = [
|
|
23
|
+
"yapf==0.40.2",
|
|
24
|
+
"toml==0.10.2",
|
|
25
|
+
"tomli==2.0.1",
|
|
26
|
+
"ruff==0.6.5",
|
|
27
|
+
"codespell==2.3.0",
|
|
28
|
+
"clang-format==15.0.7",
|
|
13
29
|
]
|
|
14
30
|
|
|
15
31
|
[build-system]
|
|
16
|
-
requires = ["setuptools", "wheel"]
|
|
32
|
+
requires = ["setuptools>=68", "wheel", "build"]
|
|
17
33
|
build-backend = "setuptools.build_meta"
|
|
18
34
|
|
|
35
|
+
[tool.setuptools.packages.find]
|
|
36
|
+
where = ["."]
|
|
37
|
+
exclude = ["3rdparty", "3rdparty.*", "tests", "tests.*"]
|
|
38
|
+
|
|
19
39
|
[tool.yapf]
|
|
20
40
|
based_on_style = "yapf"
|
|
21
41
|
column_limit = 100
|
|
@@ -30,13 +50,6 @@ skip = [
|
|
|
30
50
|
".venv"
|
|
31
51
|
]
|
|
32
52
|
|
|
33
|
-
[tool.setuptools]
|
|
34
|
-
packages = ["top"]
|
|
35
|
-
|
|
36
|
-
[project.urls]
|
|
37
|
-
"Homepage" = "https://github.com/tile-ai/tileops"
|
|
38
|
-
"Bug Tracker" = "https://github.com/tile-ai/tileops/issues"
|
|
39
|
-
|
|
40
53
|
[tool.ruff.lint]
|
|
41
54
|
select = [
|
|
42
55
|
# pycodestyle
|
|
@@ -0,0 +1,44 @@
|
|
|
1
|
+
import os
|
|
2
|
+
import sys
|
|
3
|
+
from setuptools import setup
|
|
4
|
+
|
|
5
|
+
|
|
6
|
+
# Control whether to use custom installation logic
|
|
7
|
+
# Custom installation is enabled only when:
|
|
8
|
+
# 1. TILEOPS_DEV_INSTALL environment variable is set to "1"
|
|
9
|
+
# 2. The current command is not for building distribution packages (bdist_wheel, sdist)
|
|
10
|
+
# This ensures that custom installation logic is skipped during package building
|
|
11
|
+
USE_CUSTOM_INSTALL = (
|
|
12
|
+
os.environ.get("TILEOPS_DEV_INSTALL") == "1"
|
|
13
|
+
and not any(cmd in sys.argv for cmd in ["bdist_wheel", "sdist"])
|
|
14
|
+
)
|
|
15
|
+
|
|
16
|
+
cmdclass = {}
|
|
17
|
+
|
|
18
|
+
if USE_CUSTOM_INSTALL:
|
|
19
|
+
from setuptools.command.install import install
|
|
20
|
+
import subprocess
|
|
21
|
+
class CustomInstall(install):
|
|
22
|
+
|
|
23
|
+
def run(self):
|
|
24
|
+
# Step 1: Install system dependencies (optional, warning: requires sudo)
|
|
25
|
+
print("Installing system dependencies for TileLang...")
|
|
26
|
+
subprocess.run(["sudo", "apt-get", "update"])
|
|
27
|
+
subprocess.run([
|
|
28
|
+
"sudo", "apt-get", "install", "-y", "python3-setuptools", "gcc",
|
|
29
|
+
"libtinfo-dev", "zlib1g-dev", "build-essential", "cmake",
|
|
30
|
+
"libedit-dev", "libxml2-dev"
|
|
31
|
+
])
|
|
32
|
+
|
|
33
|
+
# Step 2: Install TileLang via pip from local path
|
|
34
|
+
print("Installing TileLang from submodule...")
|
|
35
|
+
subprocess.run(["pip", "install", "-e", "3rdparty/tilelang"])
|
|
36
|
+
|
|
37
|
+
# Continue normal installation
|
|
38
|
+
install.run(self)
|
|
39
|
+
|
|
40
|
+
cmdclass = {"install": CustomInstall}
|
|
41
|
+
|
|
42
|
+
setup(name = "tileops",
|
|
43
|
+
version = "0.0.1.dev1",
|
|
44
|
+
cmdclass=cmdclass)
|
|
@@ -1,6 +1,3 @@
|
|
|
1
|
-
# Copyright (c) Tile-AI.
|
|
2
|
-
# Licensed under the MIT License.
|
|
3
|
-
|
|
4
1
|
import argparse
|
|
5
2
|
import torch
|
|
6
3
|
from top import BlockSparseAttentionKernel
|
|
@@ -42,13 +39,23 @@ def main():
|
|
|
42
39
|
low=0, high=2, size=(BATCH, H, M_BLOCKS, N_BLOCKS), dtype=torch.bool, device="cuda")
|
|
43
40
|
|
|
44
41
|
attention = BlockSparseAttentionKernel(
|
|
45
|
-
BATCH,
|
|
46
|
-
|
|
47
|
-
|
|
42
|
+
BATCH,
|
|
43
|
+
H,
|
|
44
|
+
N_CTX,
|
|
45
|
+
D_HEAD_QK,
|
|
46
|
+
D_HEAD_V,
|
|
47
|
+
BLOCK_M,
|
|
48
|
+
BLOCK_N,
|
|
49
|
+
causal=causal,
|
|
50
|
+
block_mask=block_mask,
|
|
51
|
+
groups=groups,
|
|
52
|
+
fwd_tune=True,
|
|
53
|
+
bwd_tune=True)
|
|
54
|
+
|
|
55
|
+
o = attention.backward(Q, K, V, dO)
|
|
48
56
|
print(o)
|
|
49
57
|
|
|
50
|
-
attention.
|
|
51
|
-
attention.profile(Q, K, V, dO, block_mask)
|
|
58
|
+
attention.profile()
|
|
52
59
|
|
|
53
60
|
|
|
54
61
|
if __name__ == "__main__":
|
|
@@ -1,6 +1,3 @@
|
|
|
1
|
-
# Copyright (c) Tile-AI.
|
|
2
|
-
# Licensed under the MIT License.
|
|
3
|
-
|
|
4
1
|
import argparse
|
|
5
2
|
import torch
|
|
6
3
|
from top import GQAKernel
|
|
@@ -18,8 +15,10 @@ def main():
|
|
|
18
15
|
args = parser.parse_args()
|
|
19
16
|
BATCH, H, N_CTX, D_HEAD_QK, D_HEAD_V, groups, causal = args.batch, args.h, args.n_ctx, args.d_head_qk, args.d_head_v, args.groups, args.causal
|
|
20
17
|
|
|
21
|
-
|
|
22
|
-
|
|
18
|
+
fwd_BLOCK_M = 128
|
|
19
|
+
fwd_BLOCK_N = 32
|
|
20
|
+
bwd_BLOCK_M = 64
|
|
21
|
+
bwd_BLOCK_N = 32
|
|
23
22
|
# q = torch.randn(batch, heads, dim, device='cuda', dtype=torch.float16)
|
|
24
23
|
Q = (
|
|
25
24
|
torch.empty(BATCH, N_CTX, H, D_HEAD_QK, dtype=torch.half,
|
|
@@ -37,11 +36,20 @@ def main():
|
|
|
37
36
|
device="cuda").normal_().requires_grad_())
|
|
38
37
|
|
|
39
38
|
gqa = GQAKernel(
|
|
40
|
-
BATCH,
|
|
41
|
-
|
|
42
|
-
|
|
43
|
-
|
|
44
|
-
|
|
39
|
+
BATCH,
|
|
40
|
+
H,
|
|
41
|
+
N_CTX,
|
|
42
|
+
D_HEAD_QK,
|
|
43
|
+
D_HEAD_V,
|
|
44
|
+
fwd_BLOCK_M,
|
|
45
|
+
fwd_BLOCK_N,
|
|
46
|
+
bwd_BLOCK_M,
|
|
47
|
+
bwd_BLOCK_N,
|
|
48
|
+
fwd_tune=True,
|
|
49
|
+
bwd_tune=True,
|
|
50
|
+
causal=causal,
|
|
51
|
+
groups=groups)
|
|
52
|
+
gqa.profile(Q, K, V, dO)
|
|
45
53
|
gqa.check(Q, K, V, dO)
|
|
46
54
|
|
|
47
55
|
|
|
@@ -1,12 +1,9 @@
|
|
|
1
|
-
# Copyright (c) Tile-AI.
|
|
2
|
-
# Licensed under the MIT License.
|
|
3
|
-
|
|
4
1
|
import argparse
|
|
5
2
|
from top import MHAKernel
|
|
6
3
|
|
|
7
4
|
|
|
8
|
-
def test_mha_kernel(B, S, H, D, causal):
|
|
9
|
-
kernel = MHAKernel(B, H, S, D, causal)
|
|
5
|
+
def test_mha_kernel(B, S, H, D, causal, tune):
|
|
6
|
+
kernel = MHAKernel(B, H, S, D, causal, fwd_tune=tune, bwd_tune=tune)
|
|
10
7
|
kernel.check()
|
|
11
8
|
kernel.profile()
|
|
12
9
|
|
|
@@ -18,7 +15,8 @@ if __name__ == "__main__":
|
|
|
18
15
|
parser.add_argument('--heads', type=int, default=32, help='num heads')
|
|
19
16
|
parser.add_argument('--dim', type=int, default=64, help='head dim')
|
|
20
17
|
parser.add_argument('--causal', action='store_true', default=False, help='causal attention')
|
|
18
|
+
parser.add_argument('--tune', action='store_true', default=True, help='tune the kernel')
|
|
21
19
|
args = parser.parse_args()
|
|
22
|
-
B, S, H, D, causal = args.batch, args.seq_len, args.heads, args.dim, args.causal
|
|
20
|
+
B, S, H, D, causal, tune = args.batch, args.seq_len, args.heads, args.dim, args.causal, args.tune
|
|
23
21
|
|
|
24
|
-
test_mha_kernel(B, S, H, D, causal)
|
|
22
|
+
test_mha_kernel(B, S, H, D, causal, tune)
|
|
@@ -1,12 +1,9 @@
|
|
|
1
|
-
# Copyright (c) Tile-AI.
|
|
2
|
-
# Licensed under the MIT License.
|
|
3
|
-
|
|
4
1
|
import argparse
|
|
5
2
|
from top import MHADecodeKernel
|
|
6
3
|
|
|
7
4
|
|
|
8
|
-
def test_mha_decode_kernel(B, S, H, D):
|
|
9
|
-
kernel = MHADecodeKernel(B, H, S, D)
|
|
5
|
+
def test_mha_decode_kernel(B, S, H, D, tune):
|
|
6
|
+
kernel = MHADecodeKernel(B, H, S, D, tune=tune)
|
|
10
7
|
kernel.check()
|
|
11
8
|
kernel.profile()
|
|
12
9
|
|
|
@@ -17,7 +14,8 @@ if __name__ == "__main__":
|
|
|
17
14
|
parser.add_argument('--seqlen_kv', type=int, default=8192, help='sequence length')
|
|
18
15
|
parser.add_argument('--heads', type=int, default=32, help='num heads')
|
|
19
16
|
parser.add_argument('--dim', type=int, default=128, help='head dim')
|
|
17
|
+
parser.add_argument('--tune', action='store_true', default=True, help='tune the kernel')
|
|
20
18
|
args = parser.parse_args()
|
|
21
|
-
B, S, H, D = args.batch, args.seqlen_kv, args.heads, args.dim
|
|
19
|
+
B, S, H, D, tune = args.batch, args.seqlen_kv, args.heads, args.dim, args.tune
|
|
22
20
|
|
|
23
|
-
test_mha_decode_kernel(B, S, H, D)
|
|
21
|
+
test_mha_decode_kernel(B, S, H, D, tune)
|
|
@@ -0,0 +1,57 @@
|
|
|
1
|
+
import argparse
|
|
2
|
+
import torch
|
|
3
|
+
from top import SparseMLAKernel
|
|
4
|
+
|
|
5
|
+
|
|
6
|
+
def test_sparsemla_kernel(batch, seq_len, seq_len_kv, q_start_index_s, heads, dim, tail_dim, topk,
|
|
7
|
+
kv_stride, kv_group, sm_scale, dtype):
|
|
8
|
+
sparse_mla = SparseMLAKernel(
|
|
9
|
+
batch=batch,
|
|
10
|
+
seq_len=seq_len,
|
|
11
|
+
seq_len_kv=seq_len_kv,
|
|
12
|
+
q_start_index_s=q_start_index_s,
|
|
13
|
+
heads=heads,
|
|
14
|
+
dim=dim,
|
|
15
|
+
tail_dim=tail_dim,
|
|
16
|
+
topk=topk,
|
|
17
|
+
kv_stride=kv_stride,
|
|
18
|
+
kv_group=kv_group,
|
|
19
|
+
sm_scale=sm_scale,
|
|
20
|
+
is_casual=True,
|
|
21
|
+
dtype=dtype,
|
|
22
|
+
device='cuda',
|
|
23
|
+
)
|
|
24
|
+
sparse_mla.check()
|
|
25
|
+
latency = sparse_mla.profile()
|
|
26
|
+
print(f"Latency: {latency:.4f} ms")
|
|
27
|
+
print(f'fwd tflops = ',
|
|
28
|
+
(batch * seq_len * (dim + tail_dim + dim) * topk * 2 * heads) / (latency * 1e-3) / 1e12)
|
|
29
|
+
|
|
30
|
+
|
|
31
|
+
if __name__ == "__main__":
|
|
32
|
+
parser = argparse.ArgumentParser()
|
|
33
|
+
parser.add_argument('--batch', type=int, default=1, help='batch size')
|
|
34
|
+
parser.add_argument('--seq_len', type=int, default=1024, help='sequence length')
|
|
35
|
+
parser.add_argument('--seq_len_kv', type=int, default=2048, help='key/value sequence length')
|
|
36
|
+
parser.add_argument('--heads', type=int, default=128, help='num heads')
|
|
37
|
+
parser.add_argument('--dim', type=int, default=512, help='head dim')
|
|
38
|
+
parser.add_argument('--tail_dim', type=int, default=64, help='tail dim')
|
|
39
|
+
parser.add_argument('--topk', type=int, default=2048, help='topk')
|
|
40
|
+
parser.add_argument('--kv_stride', type=int, default=1, help='kv_stride')
|
|
41
|
+
parser.add_argument('--kv_group', type=int, default=1, help='kv_group')
|
|
42
|
+
parser.add_argument('--sm_scale', type=float, default=None, help='softmax scaling factor')
|
|
43
|
+
args = parser.parse_args()
|
|
44
|
+
batch = args.batch
|
|
45
|
+
seq_len = args.seq_len
|
|
46
|
+
seq_len_kv = args.seq_len_kv
|
|
47
|
+
heads = args.heads
|
|
48
|
+
dim = args.dim
|
|
49
|
+
tail_dim = args.tail_dim
|
|
50
|
+
topk = args.topk
|
|
51
|
+
kv_stride = args.kv_stride
|
|
52
|
+
kv_group = args.kv_group
|
|
53
|
+
sm_scale = args.sm_scale
|
|
54
|
+
dtype = torch.bfloat16
|
|
55
|
+
|
|
56
|
+
test_sparsemla_kernel(batch, seq_len, seq_len_kv, 1024, heads, dim, tail_dim, topk, kv_stride,
|
|
57
|
+
kv_group, sm_scale, dtype)
|
|
@@ -0,0 +1,26 @@
|
|
|
1
|
+
Metadata-Version: 2.4
|
|
2
|
+
Name: tileops
|
|
3
|
+
Version: 0.0.1.dev1
|
|
4
|
+
Summary: TileOPs kernels for efficient inference
|
|
5
|
+
Author: Tile-AI
|
|
6
|
+
License-Expression: MIT
|
|
7
|
+
Requires-Python: >=3.8
|
|
8
|
+
License-File: LICENSE
|
|
9
|
+
Requires-Dist: torch>=2.1.0
|
|
10
|
+
Requires-Dist: numpy>=1.23.5
|
|
11
|
+
Requires-Dist: einops>=0.6.0
|
|
12
|
+
Requires-Dist: Cython
|
|
13
|
+
Requires-Dist: tqdm>=4.62.3
|
|
14
|
+
Requires-Dist: typing_extensions>=4.10.0
|
|
15
|
+
Requires-Dist: cloudpickle
|
|
16
|
+
Requires-Dist: ml_dtypes
|
|
17
|
+
Requires-Dist: psutil
|
|
18
|
+
Requires-Dist: tilelang>=0.1.6.post1
|
|
19
|
+
Provides-Extra: dev
|
|
20
|
+
Requires-Dist: yapf==0.40.2; extra == "dev"
|
|
21
|
+
Requires-Dist: toml==0.10.2; extra == "dev"
|
|
22
|
+
Requires-Dist: tomli==2.0.1; extra == "dev"
|
|
23
|
+
Requires-Dist: ruff==0.6.5; extra == "dev"
|
|
24
|
+
Requires-Dist: codespell==2.3.0; extra == "dev"
|
|
25
|
+
Requires-Dist: clang-format==15.0.7; extra == "dev"
|
|
26
|
+
Dynamic: license-file
|
|
@@ -13,9 +13,23 @@ tests/test_mamba_chunk_state.py
|
|
|
13
13
|
tests/test_mha.py
|
|
14
14
|
tests/test_mha_decode.py
|
|
15
15
|
tests/test_mla.py
|
|
16
|
+
tests/test_sparse_mla.py
|
|
16
17
|
tileops.egg-info/PKG-INFO
|
|
17
18
|
tileops.egg-info/SOURCES.txt
|
|
18
19
|
tileops.egg-info/dependency_links.txt
|
|
19
20
|
tileops.egg-info/requires.txt
|
|
20
21
|
tileops.egg-info/top_level.txt
|
|
21
|
-
top/__init__.py
|
|
22
|
+
top/__init__.py
|
|
23
|
+
top/kernel/__init__.py
|
|
24
|
+
top/kernel/bitnet.py
|
|
25
|
+
top/kernel/blocksparse_attention.py
|
|
26
|
+
top/kernel/gqa.py
|
|
27
|
+
top/kernel/mamba_chunk_scan.py
|
|
28
|
+
top/kernel/mamba_chunk_state.py
|
|
29
|
+
top/kernel/mha.py
|
|
30
|
+
top/kernel/mla.py
|
|
31
|
+
top/kernel/sparse_mla.py
|
|
32
|
+
top/kernel/linear_attention/__init__.py
|
|
33
|
+
top/kernel/linear_attention/linear_attn.py
|
|
34
|
+
top/utils/__init__.py
|
|
35
|
+
top/utils/utils.py
|
|
@@ -0,0 +1,18 @@
|
|
|
1
|
+
torch>=2.1.0
|
|
2
|
+
numpy>=1.23.5
|
|
3
|
+
einops>=0.6.0
|
|
4
|
+
Cython
|
|
5
|
+
tqdm>=4.62.3
|
|
6
|
+
typing_extensions>=4.10.0
|
|
7
|
+
cloudpickle
|
|
8
|
+
ml_dtypes
|
|
9
|
+
psutil
|
|
10
|
+
tilelang>=0.1.6.post1
|
|
11
|
+
|
|
12
|
+
[dev]
|
|
13
|
+
yapf==0.40.2
|
|
14
|
+
toml==0.10.2
|
|
15
|
+
tomli==2.0.1
|
|
16
|
+
ruff==0.6.5
|
|
17
|
+
codespell==2.3.0
|
|
18
|
+
clang-format==15.0.7
|
|
@@ -1,18 +1,16 @@
|
|
|
1
|
-
# Copyright (c) Tile-AI.
|
|
2
|
-
# Licensed under the MIT License.
|
|
3
|
-
|
|
4
1
|
from .kernel.mha import MHAKernel, MHADecodeKernel
|
|
5
2
|
from .kernel.mla import MLAKernel
|
|
6
3
|
from .kernel.gqa import GQAKernel, GQADecodeKernel
|
|
7
4
|
from .kernel.mamba_chunk_scan import MambaChunkScanKernel
|
|
8
5
|
from .kernel.mamba_chunk_state import MambaChunkStateKernel
|
|
9
6
|
from .kernel.blocksparse_attention import BlockSparseAttentionKernel
|
|
10
|
-
from .kernel.linear_attention.linear_attn import LinearAttentionFusedChunkKernel, LinearAttentionFusedRecurrentKernel
|
|
7
|
+
# from .kernel.linear_attention.linear_attn import LinearAttentionFusedChunkKernel, LinearAttentionFusedRecurrentKernel
|
|
11
8
|
from .kernel.bitnet import Bitnet_158_int8xint2_kernel
|
|
9
|
+
from .kernel.sparse_mla import SparseMLAKernel
|
|
12
10
|
|
|
13
11
|
__all__ = [
|
|
14
12
|
"MHAKernel", "MHADecodeKernel", "MLAKernel", "GQAKernel", "GQADecodeKernel",
|
|
15
13
|
"MambaChunkScanKernel", "MambaChunkStateKernel", "BlockSparseAttentionKernel",
|
|
16
|
-
"LinearAttentionFusedChunkKernel", "LinearAttentionFusedRecurrentKernel",
|
|
17
|
-
"Bitnet_158_int8xint2_kernel"
|
|
14
|
+
# "LinearAttentionFusedChunkKernel", "LinearAttentionFusedRecurrentKernel",
|
|
15
|
+
"Bitnet_158_int8xint2_kernel", "SparseMLAKernel"
|
|
18
16
|
]
|
|
@@ -0,0 +1,15 @@
|
|
|
1
|
+
from .mha import MHAKernel, MHADecodeKernel
|
|
2
|
+
from .mla import MLAKernel
|
|
3
|
+
from .gqa import GQAKernel, GQADecodeKernel
|
|
4
|
+
from .mamba_chunk_scan import MambaChunkScanKernel
|
|
5
|
+
from .mamba_chunk_state import MambaChunkStateKernel
|
|
6
|
+
from .blocksparse_attention import BlockSparseAttentionKernel
|
|
7
|
+
# from .linear_attention.linear_attn import LinearAttentionFusedChunkKernel, LinearAttentionFusedRecurrentKernel
|
|
8
|
+
from .bitnet import Bitnet_158_int8xint2_kernel
|
|
9
|
+
|
|
10
|
+
__all__ = [
|
|
11
|
+
"MHAKernel", "MHADecodeKernel", "MLAKernel", "GQAKernel", "GQADecodeKernel",
|
|
12
|
+
"MambaChunkScanKernel", "MambaChunkStateKernel", "BlockSparseAttentionKernel",
|
|
13
|
+
# "LinearAttentionFusedChunkKernel", "LinearAttentionFusedRecurrentKernel",
|
|
14
|
+
"Bitnet_158_int8xint2_kernel"
|
|
15
|
+
]
|