text2sql-eval 0.1.0__tar.gz → 0.1.1__tar.gz
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- text2sql_eval-0.1.1/PKG-INFO +229 -0
- text2sql_eval-0.1.1/README.md +201 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/pyproject.toml +2 -2
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/pyproject.toml.orig +2 -2
- text2sql_eval-0.1.0/PKG-INFO +0 -176
- text2sql_eval-0.1.0/README.md +0 -148
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/LICENSE +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/__init__.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/cli/__init__.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/cli/main.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/compare/__init__.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/compare/runs.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/csv_safety.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/datasets/__init__.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/datasets/_json.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/datasets/bird.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/datasets/predictions.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/errors.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/evaluate.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/execution/__init__.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/execution/executor.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/facts/__init__.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/facts/output.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/facts/structure.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/judge/__init__.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/judge/ex.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/py.typed +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/report/__init__.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/report/csv_report.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/report/highlight.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/report/html_report.py +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/report/templates/report.html.j2 +0 -0
- {text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/runfile.py +0 -0
|
@@ -0,0 +1,229 @@
|
|
|
1
|
+
Metadata-Version: 2.4
|
|
2
|
+
Name: text2sql-eval
|
|
3
|
+
Version: 0.1.1
|
|
4
|
+
Summary: Deterministic error analysis and run comparison for text-to-SQL experiments, with BIRD-compatible EX
|
|
5
|
+
Keywords: text-to-sql,nl2sql,evaluation,error-analysis,bird
|
|
6
|
+
Author: cheolkim02
|
|
7
|
+
License-Expression: MIT
|
|
8
|
+
License-File: LICENSE
|
|
9
|
+
Classifier: Development Status :: 3 - Alpha
|
|
10
|
+
Classifier: Intended Audience :: Science/Research
|
|
11
|
+
Classifier: Programming Language :: Python :: 3
|
|
12
|
+
Classifier: Programming Language :: Python :: 3 :: Only
|
|
13
|
+
Classifier: Programming Language :: Python :: 3.11
|
|
14
|
+
Classifier: Programming Language :: Python :: 3.12
|
|
15
|
+
Classifier: Programming Language :: Python :: 3.13
|
|
16
|
+
Classifier: Programming Language :: Python :: 3.14
|
|
17
|
+
Classifier: Programming Language :: Python :: 3.15
|
|
18
|
+
Classifier: Topic :: Database
|
|
19
|
+
Classifier: Topic :: Scientific/Engineering :: Artificial Intelligence
|
|
20
|
+
Classifier: Typing :: Typed
|
|
21
|
+
Requires-Dist: jinja2>=3.1.6
|
|
22
|
+
Requires-Dist: sqlglot>=30.31.0
|
|
23
|
+
Requires-Python: >=3.11
|
|
24
|
+
Project-URL: Repository, https://github.com/cheolkim02/text2sql-eval
|
|
25
|
+
Project-URL: Documentation, https://github.com/cheolkim02/text2sql-eval/tree/main/docs
|
|
26
|
+
Project-URL: Issues, https://github.com/cheolkim02/text2sql-eval/issues
|
|
27
|
+
Description-Content-Type: text/markdown
|
|
28
|
+
|
|
29
|
+
# text2sql-eval
|
|
30
|
+
|
|
31
|
+
[](https://github.com/cheolkim02/text2sql-eval/actions/workflows/ci.yml)
|
|
32
|
+
[](https://pypi.org/project/text2sql-eval/)
|
|
33
|
+
[](https://pypi.org/project/text2sql-eval/)
|
|
34
|
+
|
|
35
|
+
**English summary.** Documentation is in Korean. `text2sql-eval` is a Python library and CLI for the error analysis of text-to-SQL experiments. It judges execution accuracy (EX) with the same rule as BIRD's official script, explains every wrong case without an LLM (how the results differ and where the SQL differs), flags verdicts the official rule may get wrong, compares two runs case by case, and writes an offline HTML report and a CSV. The same inputs always give the same output.
|
|
36
|
+
|
|
37
|
+
```sh
|
|
38
|
+
pip install text2sql-eval
|
|
39
|
+
text2sql-eval eval --dataset dev.json --db-dir dev_databases --pred predictions.jsonl --out run.json
|
|
40
|
+
```
|
|
41
|
+
|
|
42
|
+
text-to-SQL 실험의 예측 파일을 받아 **EX(실행 정확도)를 판정하고, 오답이 정답과 무엇이 다른지를 AI 없이 근거와 함께 보여 주는** Python 라이브러리이자 CLI다.
|
|
43
|
+
|
|
44
|
+
## 무엇을 하나
|
|
45
|
+
|
|
46
|
+
- **EX 판정:** BIRD 공식 스크립트와 같은 규칙(행 집합 비교)으로 판정한다. 같은 예측을 공식 스크립트로도 채점해 숫자가 같음을 확인했다.
|
|
47
|
+
- **오답의 차이:** 오답마다 두 가지를 근거와 함께 붙인다. 한 오답에 여러 개가 붙을 수 있다.
|
|
48
|
+
- 출력 차이 6종: 빈 결과(`empty_result`), 컬럼 수(`column_mismatch`), 행 수(`row_count_differs`), 값 하나(`single_value_differs`), 행 내용(`row_set_differs`), 실행 실패(`execution_failed`)
|
|
49
|
+
- SQL 구조 차이 5종: WHERE 값(`where_value`), 테이블·JOIN(`tables_joins`), 컬럼(`columns`), 집계(`aggregation`), ORDER BY/LIMIT(`order_limit`)
|
|
50
|
+
- **판정 신뢰도 플래그:** 공식 규칙이 놓쳤을 수 있는 판정 6가지를 표시한다(거짓 정답 의심, 거짓 오답 의심). 판정 자체는 바꾸지 않는다.
|
|
51
|
+
- **두 실험 비교:** 케이스 단위 분할표(고쳐짐, 나빠짐), 난이도별·DB별 EX, 차이 분포의 변화를 보여 준다. 기준보다 나빠지면 실패하게 해서 CI에서도 쓸 수 있다.
|
|
52
|
+
- **리포트:** 인터넷 없이 열리는 HTML 한 파일과, 엑셀에서 한글이 깨지지 않는 CSV를 만든다. HTML은 정답·예측 SQL을 절마다 줄을 나눠 나란히 보여 주고, 다른 절과 다른 행을 색칠한다.
|
|
53
|
+
|
|
54
|
+
판정과 분석에 LLM, 무작위, 시간에 따라 달라지는 값을 쓰지 않는다. 같은 입력이면 같은 결과가 나온다.
|
|
55
|
+
|
|
56
|
+
|
|
57
|
+
|
|
58
|
+
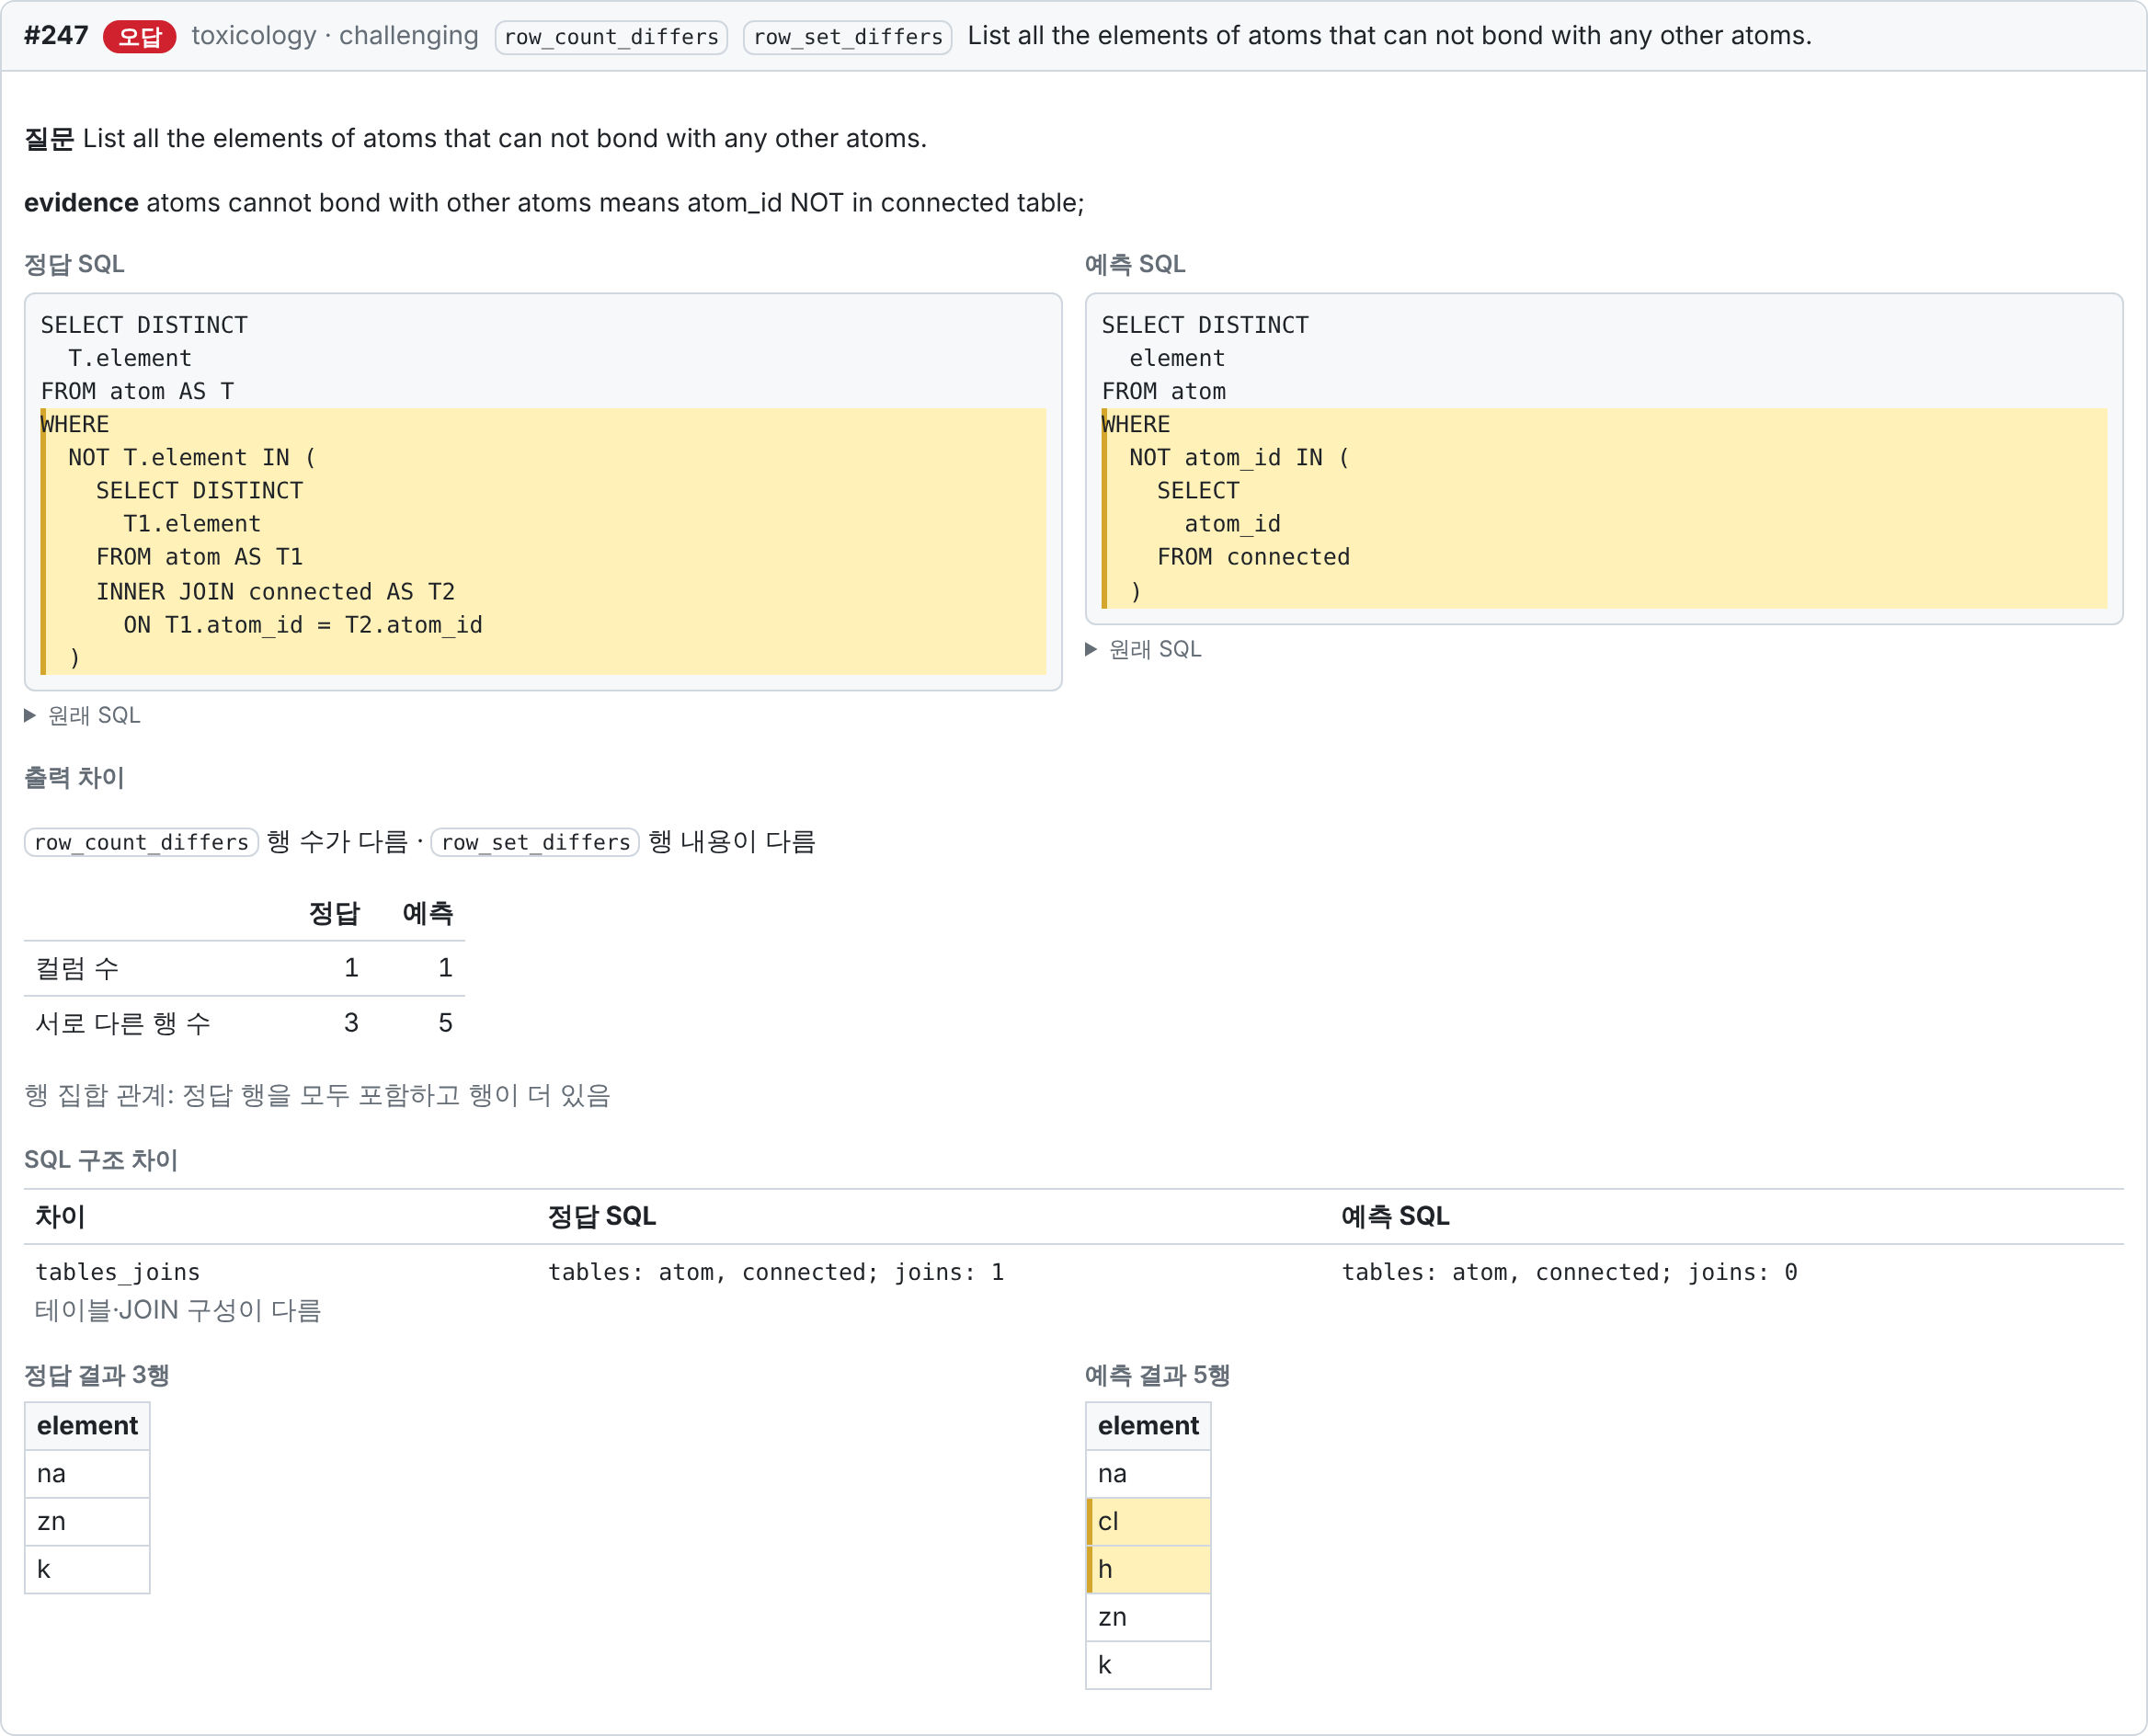
HTML 리포트에서 오답 하나(#247)를 펼친 화면이다. 정답과 예측 SQL에서 다른 절(WHERE)과, 정답에 없는 예측 결과 행(`cl`, `h`)을 칠한다. 출력 차이(`row_count_differs`, `row_set_differs`)와 SQL 구조 차이(`tables_joins`)를 근거와 함께 보여 준다. 리포트 전체는 [examples/results/report.html](https://github.com/cheolkim02/text2sql-eval/blob/main/examples/results/report.html)이다. GitHub 화면에서는 HTML 소스로 보이니, 파일을 내려받아 브라우저로 연다.
|
|
59
|
+
|
|
60
|
+
## 설치
|
|
61
|
+
|
|
62
|
+
Python 3.11 이상이 필요하다.
|
|
63
|
+
|
|
64
|
+
```sh
|
|
65
|
+
pip install text2sql-eval
|
|
66
|
+
```
|
|
67
|
+
|
|
68
|
+
## 3분 사용법
|
|
69
|
+
|
|
70
|
+
예제 데이터는 패키지가 아니라 저장소에 들어 있다. BIRD dev의 DB 3개와 문제 432개, gpt-4o-mini의 예측 두 벌이다. 위에서 설치했다면 저장소는 데이터만 받으면 된다.
|
|
71
|
+
|
|
72
|
+
```sh
|
|
73
|
+
git clone https://github.com/cheolkim02/text2sql-eval.git
|
|
74
|
+
cd text2sql-eval
|
|
75
|
+
```
|
|
76
|
+
|
|
77
|
+
설치하지 않았거나 저장소의 코드로 설치하려면 여기서 `pip install .`을 한다. uv를 쓰면 `uv sync`를 하고 아래 명령 앞에 `uv run`을 붙인다. 자세한 안내는 [시작하기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/getting-started.md)에 있다.
|
|
78
|
+
|
|
79
|
+
판정하기(30초쯤 걸린다):
|
|
80
|
+
|
|
81
|
+
```sh
|
|
82
|
+
text2sql-eval eval \
|
|
83
|
+
--dataset examples/bird-mini/dev.json \
|
|
84
|
+
--db-dir examples/bird-mini/dev_databases \
|
|
85
|
+
--pred examples/results/gpt-4o-mini-evidence.jsonl \
|
|
86
|
+
--tied examples/bird-mini/dev_tied_append.json \
|
|
87
|
+
--out runs/evidence.json
|
|
88
|
+
```
|
|
89
|
+
|
|
90
|
+
`--tied`는 BIRD가 함께 주는 동점 대체 정답 파일이다. 정답 SQL이 동점 중 하나만 고르는 문제에 다른 정답을 알려 준다. 판정에는 쓰지 않고 플래그에만 쓰며, 빼도 된다.
|
|
91
|
+
|
|
92
|
+
```text
|
|
93
|
+
Evaluated 432 cases: EX 61.8% (267 correct, 161 incorrect, 4 errors)
|
|
94
|
+
Output difference: 62 column_mismatch, 58 row_set_differs, 44 single_value_differs, 34 empty_result, 31 row_count_differs, 4 execution_failed
|
|
95
|
+
SQL structure difference: 79 columns, 72 tables_joins, 66 aggregation, 25 where_value, 23 order_limit
|
|
96
|
+
Flags: 8 gold_columns_concatenated, 25 gold_rows_with_extra_columns, 5 matches_tied_alternative_only, 13 tied_alternative_exists
|
|
97
|
+
Run file: runs/evidence.json
|
|
98
|
+
```
|
|
99
|
+
|
|
100
|
+
리포트 만들기(`runs/evidence.html`을 브라우저로 연다):
|
|
101
|
+
|
|
102
|
+
```sh
|
|
103
|
+
text2sql-eval report runs/evidence.json --html runs/evidence.html --csv runs/evidence.csv
|
|
104
|
+
```
|
|
105
|
+
|
|
106
|
+
evidence를 뺀 실험과 비교하기:
|
|
107
|
+
|
|
108
|
+
```sh
|
|
109
|
+
text2sql-eval compare examples/results/gpt-4o-mini-no-evidence.run.json runs/evidence.json
|
|
110
|
+
```
|
|
111
|
+
|
|
112
|
+
```text
|
|
113
|
+
Comparing examples/results/gpt-4o-mini-no-evidence.run.json -> runs/evidence.json (432 common cases)
|
|
114
|
+
EX: 37.5% -> 61.8% (+24.3 pp)
|
|
115
|
+
Both correct 144 | Fixed 123 | Regressed 18 | Both wrong 147
|
|
116
|
+
By difficulty: challenging 29.1% -> 47.3%, moderate 27.7% -> 54.6%, simple 43.8% -> 68.2%
|
|
117
|
+
By database: student_club 43.0% -> 57.0%, superhero 57.4% -> 79.8%, toxicology 13.8% -> 51.0%
|
|
118
|
+
Output difference: empty_result 100 -> 34, single_value_differs 94 -> 44, column_mismatch 78 -> 62, row_set_differs 46 -> 58, row_count_differs 26 -> 31, execution_failed 9 -> 4
|
|
119
|
+
SQL structure difference: columns 155 -> 79, where_value 132 -> 25, tables_joins 130 -> 72, aggregation 121 -> 66, order_limit 40 -> 23
|
|
120
|
+
```
|
|
121
|
+
|
|
122
|
+
## 내 실험에 쓰기
|
|
123
|
+
|
|
124
|
+
가장 널리 쓰이는 BIRD 형식을 기준으로, 파일 세 개가 필요하다.
|
|
125
|
+
|
|
126
|
+
1. **문제 파일(`--dataset`):** BIRD의 `dev.json`과 같은 JSON 배열이다. 문제마다 `question_id`(정수), `db_id`, `question`, `evidence`, `SQL`(정답 SQL)이 있다. `difficulty`가 있으면 난이도별 EX도 낸다.
|
|
127
|
+
2. **DB 폴더(`--db-dir`):** `<db-dir>/<db_id>/<db_id>.sqlite` 구조의 SQLite 파일이다. BIRD의 `dev_databases` 폴더가 이 구조다.
|
|
128
|
+
3. **예측 파일(`--pred`):** 모델이 만든 SQL이다. 두 형식 중 하나로 쓴다.
|
|
129
|
+
- `.txt`: 한 줄에 SQL 하나. N번째 줄이 문제 파일의 N번째 문제의 예측이다.
|
|
130
|
+
- `.jsonl`: 한 줄에 `{"id": question_id, "sql": "..."}` 하나. 줄 순서는 상관없다.
|
|
131
|
+
|
|
132
|
+
```text
|
|
133
|
+
{"id": 195, "sql": "SELECT T.bond_type FROM bond AS T GROUP BY T.bond_type ORDER BY COUNT(*) DESC LIMIT 1"}
|
|
134
|
+
{"id": 196, "sql": "SELECT COUNT(*) FROM atom WHERE element = 'cl'"}
|
|
135
|
+
```
|
|
136
|
+
|
|
137
|
+
```sh
|
|
138
|
+
text2sql-eval eval --dataset dev.json --db-dir dev_databases \
|
|
139
|
+
--pred my_predictions.jsonl --meta model=my-model --out runs/my-run.json
|
|
140
|
+
text2sql-eval report runs/my-run.json --html runs/my-run.html
|
|
141
|
+
```
|
|
142
|
+
|
|
143
|
+
`--meta`로 모델 이름이나 프롬프트 버전 같은 실험 설정을 판정 결과 파일에 함께 남긴다. 예측 파일을 만드는 법은 [예측 파일 만들기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/prediction-format.md)에 있다.
|
|
144
|
+
|
|
145
|
+
Python에서는 같은 일을 이렇게 한다([API 레퍼런스](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/reference/api.md)).
|
|
146
|
+
|
|
147
|
+
```python
|
|
148
|
+
from pathlib import Path
|
|
149
|
+
|
|
150
|
+
from text2sql_eval import evaluate_files, write_html_report, write_run
|
|
151
|
+
|
|
152
|
+
run = evaluate_files(
|
|
153
|
+
Path("dev.json"),
|
|
154
|
+
Path("my_predictions.jsonl"),
|
|
155
|
+
db_dir=Path("dev_databases"),
|
|
156
|
+
)
|
|
157
|
+
print(f"EX {run.summary.ex:.1%}")
|
|
158
|
+
write_run(run, Path("runs/my-run.json"))
|
|
159
|
+
write_html_report(run, Path("runs/my-run.html"), run_name="my-run")
|
|
160
|
+
```
|
|
161
|
+
|
|
162
|
+
## 실측 결과
|
|
163
|
+
|
|
164
|
+
저장소에 커밋된 baseline이다. `examples/bird-mini`(BIRD dev, 432문제)에서 gpt-4o-mini로 같은 프롬프트를 두 번 돌렸고, 다른 점은 BIRD의 `evidence`(힌트)를 넣었는지 하나다.
|
|
165
|
+
|
|
166
|
+
| 설정 | EX | simple | moderate | challenging | BIRD 공식 스크립트 |
|
|
167
|
+
| --- | --- | --- | --- | --- | --- |
|
|
168
|
+
| evidence 있음 | **61.81%** | 68.22% | 54.62% | 47.27% | 61.81% (일치) |
|
|
169
|
+
| evidence 없음 | **37.50%** | 43.80% | 27.73% | 29.09% | 37.50% (일치) |
|
|
170
|
+
|
|
171
|
+
- **공식 스크립트와 일치:** 공식 평가 스크립트를 수정하지 않고 같은 예측을 채점했다. 난이도별 숫자까지 8개가 모두 소수점 둘째 자리까지 같다.
|
|
172
|
+
- **거짓 오답 의심:** evidence 있음 실험의 오답 161개 중 38개(24%)에 플래그가 붙었다. 공식 규칙으로는 오답이지만 사람이 보면 맞다고 할 만한 답이다. 예를 들어 #1445는 이름과 성을 한 컬럼으로 이어 붙였고, #300은 원자 id에 원소 컬럼을 덧붙였다.
|
|
173
|
+
- **두 실험 비교:** evidence를 넣자 123개가 맞게 바뀌고 18개가 틀리게 바뀌었다(+24.3%p). `where_value` 차이가 132개에서 25개로 가장 많이 줄었다. evidence가 주로 WHERE에 들어갈 값(철자, 대소문자, 코드값)을 알려 주기 때문이다.
|
|
174
|
+
|
|
175
|
+
생성 조건, 비용, 시간 제한에 민감한 케이스는 [examples/results](https://github.com/cheolkim02/text2sql-eval/tree/main/examples/results)에 있다.
|
|
176
|
+
|
|
177
|
+
## 문서
|
|
178
|
+
|
|
179
|
+
| 문서 | 내용 |
|
|
180
|
+
| --- | --- |
|
|
181
|
+
| [시작하기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/getting-started.md) | 설치부터 예제로 `eval → report → compare`까지 |
|
|
182
|
+
| [예측 파일 만들기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/prediction-format.md) | 내 파이프라인의 결과를 넣는 법 |
|
|
183
|
+
| [결과 읽기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/reading-results.md) | 판정 규칙, 차이와 플래그의 뜻, HTML 리포트, CSV로 손 분류하기 |
|
|
184
|
+
| [실험 비교하기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/comparing-runs.md) | 비교 결과 해석, CI에서 쓰기 |
|
|
185
|
+
| [CLI 레퍼런스](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/reference/cli.md) | 명령과 옵션, 종료 코드, 출력 형식 |
|
|
186
|
+
| [API 레퍼런스](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/reference/api.md) | 공개 Python API 38개 |
|
|
187
|
+
| [판정 결과 파일 형식](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/reference/run-file.md) | `eval`이 쓰는 JSON |
|
|
188
|
+
| [아키텍처](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/architecture.md) | 모듈 경계, 의존 방향, 설계 원칙 |
|
|
189
|
+
| [기여 안내](https://github.com/cheolkim02/text2sql-eval/blob/main/CONTRIBUTING.md) | 개발 환경, 검사, 커밋 규칙 |
|
|
190
|
+
|
|
191
|
+
## 한계와 로드맵
|
|
192
|
+
|
|
193
|
+
- **지원 형식:** 가장 널리 쓰이는 BIRD 형식(문제 파일, DB 폴더)을 먼저 지원한다. 예측은 텍스트(`.txt`)와 JSONL(`.jsonl`)로 받는다. 다른 벤치마크 형식은 추가할 예정이다.
|
|
194
|
+
- **실행 엔진:** SQLite만 실행한다. PostgreSQL·MySQL은 로드맵이다.
|
|
195
|
+
- **판정:** BIRD 공식 규칙 하나로만 판정한다. 행 순서와 중복까지 따지는 엄격 모드는 로드맵이다.
|
|
196
|
+
- **정규화:** SQL 구조 차이의 정규화는 최소한이다. 조건 순서, `IN`과 `EXISTS`, 서브쿼리와 JOIN처럼 뜻은 같고 모양이 다른 SQL은 다르게 본다.
|
|
197
|
+
- **카테고리 매핑:** 사용자가 정한 카테고리를 파일로 자동으로 붙이는 기능은 로드맵이다. 지금은 CSV의 `my_category` 열에 손으로 적는다.
|
|
198
|
+
- **버전:** 아직 0.x 버전이라 공개 API와 판정 결과 파일 형식이 바뀔 수 있다. 판정 결과 파일에는 형식 버전(`schema_version`)이 들어 있다.
|
|
199
|
+
|
|
200
|
+
## 해결하려는 문제
|
|
201
|
+
|
|
202
|
+
text-to-SQL 실험에서는 실험을 돌리는 것보다 결과를 판단하는 데 시간이 더 오래 걸린다.
|
|
203
|
+
|
|
204
|
+
- **오답 분석이 수작업이다.** 틀린 케이스마다 정답과 예측 SQL을 읽고, 다른 곳을 찾아 엑셀에 적고, 카테고리를 붙인다. 질문이나 SQL이 길면 읽기조차 힘들다.
|
|
205
|
+
- **분류를 AI에게 맡길 수 없다.** 평가 결과를 LLM이 분류하면 그 분류에도 오류가 섞여, 평가를 믿을 수 없게 된다.
|
|
206
|
+
- **EX 판정 자체가 틀린다.** 정답 결과가 비어 있으면 빈 결과를 내는 아무 SQL이나 정답이 된다. 사람 이름을 물었을 때 이름과 성을 한 컬럼으로 이어 붙여 내면, 내용이 맞아도 오답이 된다.
|
|
207
|
+
- **실험 비교도 수작업이다.** 두 설정에서 둘 다 틀린 문제, 한쪽만 틀린 문제를 스크립트로 뽑아 눈으로 본다.
|
|
208
|
+
|
|
209
|
+
그래서 이 도구는 "무엇이 다른가"를 규칙으로 보고하고, "왜 틀렸나"는 사람이 판단하게 둔다.
|
|
210
|
+
|
|
211
|
+
## 품질
|
|
212
|
+
|
|
213
|
+
- **타입:** pyright strict에서 오류가 0개다. 공개 API에 `Any`가 없고, 타입 정보(`py.typed`)를 함께 배포한다.
|
|
214
|
+
- **CI:** GitHub Actions에서 다음을 돌린다.
|
|
215
|
+
- Ruff 린트와 포맷 검사, pyright
|
|
216
|
+
- Python 3.11~3.15 테스트
|
|
217
|
+
- 빌드한 wheel을 개발 도구 없는 새 환경에 설치해 CLI를 실제로 돌려 보기
|
|
218
|
+
- **테스트:** 단위 테스트, Hypothesis 속성 기반 테스트, 실제 프로세스로 돌리는 e2e 테스트가 있다. 그 밖에 이런 것을 지킨다.
|
|
219
|
+
- 커밋된 baseline이 예측 파일에서 그대로 다시 나오는지
|
|
220
|
+
- 문서가 코드와 어긋나지 않는지
|
|
221
|
+
|
|
222
|
+
## AI와 함께 만든 방식
|
|
223
|
+
|
|
224
|
+
이 저장소는 Claude Code와 함께 만들었다. 설계 결정은 모두 사람이 하고 이유와 함께 [결정 기록](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/decisions/README.md)으로 남겼으며, 에이전트는 선택지 제시와 구현·테스트·문서 초안을 맡았다. 역할 규칙은 [AGENTS.md](https://github.com/cheolkim02/text2sql-eval/blob/main/AGENTS.md)에, 사람이 기각한 추천과 AI가 틀린 사례는 [AI와 함께 개발한 방식](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/ai-workflow.md)에 있다.
|
|
225
|
+
|
|
226
|
+
## 라이선스
|
|
227
|
+
|
|
228
|
+
- 코드: [MIT](https://github.com/cheolkim02/text2sql-eval/blob/main/LICENSE)
|
|
229
|
+
- 예제 데이터 `examples/bird-mini`: [BIRD](https://bird-bench.github.io/) dev의 일부, [CC BY-SA 4.0](https://github.com/cheolkim02/text2sql-eval/blob/main/examples/bird-mini/LICENSE)(출처와 바꾼 점은 [SOURCE.md](https://github.com/cheolkim02/text2sql-eval/blob/main/examples/bird-mini/SOURCE.md))
|
|
@@ -0,0 +1,201 @@
|
|
|
1
|
+
# text2sql-eval
|
|
2
|
+
|
|
3
|
+
[](https://github.com/cheolkim02/text2sql-eval/actions/workflows/ci.yml)
|
|
4
|
+
[](https://pypi.org/project/text2sql-eval/)
|
|
5
|
+
[](https://pypi.org/project/text2sql-eval/)
|
|
6
|
+
|
|
7
|
+
**English summary.** Documentation is in Korean. `text2sql-eval` is a Python library and CLI for the error analysis of text-to-SQL experiments. It judges execution accuracy (EX) with the same rule as BIRD's official script, explains every wrong case without an LLM (how the results differ and where the SQL differs), flags verdicts the official rule may get wrong, compares two runs case by case, and writes an offline HTML report and a CSV. The same inputs always give the same output.
|
|
8
|
+
|
|
9
|
+
```sh
|
|
10
|
+
pip install text2sql-eval
|
|
11
|
+
text2sql-eval eval --dataset dev.json --db-dir dev_databases --pred predictions.jsonl --out run.json
|
|
12
|
+
```
|
|
13
|
+
|
|
14
|
+
text-to-SQL 실험의 예측 파일을 받아 **EX(실행 정확도)를 판정하고, 오답이 정답과 무엇이 다른지를 AI 없이 근거와 함께 보여 주는** Python 라이브러리이자 CLI다.
|
|
15
|
+
|
|
16
|
+
## 무엇을 하나
|
|
17
|
+
|
|
18
|
+
- **EX 판정:** BIRD 공식 스크립트와 같은 규칙(행 집합 비교)으로 판정한다. 같은 예측을 공식 스크립트로도 채점해 숫자가 같음을 확인했다.
|
|
19
|
+
- **오답의 차이:** 오답마다 두 가지를 근거와 함께 붙인다. 한 오답에 여러 개가 붙을 수 있다.
|
|
20
|
+
- 출력 차이 6종: 빈 결과(`empty_result`), 컬럼 수(`column_mismatch`), 행 수(`row_count_differs`), 값 하나(`single_value_differs`), 행 내용(`row_set_differs`), 실행 실패(`execution_failed`)
|
|
21
|
+
- SQL 구조 차이 5종: WHERE 값(`where_value`), 테이블·JOIN(`tables_joins`), 컬럼(`columns`), 집계(`aggregation`), ORDER BY/LIMIT(`order_limit`)
|
|
22
|
+
- **판정 신뢰도 플래그:** 공식 규칙이 놓쳤을 수 있는 판정 6가지를 표시한다(거짓 정답 의심, 거짓 오답 의심). 판정 자체는 바꾸지 않는다.
|
|
23
|
+
- **두 실험 비교:** 케이스 단위 분할표(고쳐짐, 나빠짐), 난이도별·DB별 EX, 차이 분포의 변화를 보여 준다. 기준보다 나빠지면 실패하게 해서 CI에서도 쓸 수 있다.
|
|
24
|
+
- **리포트:** 인터넷 없이 열리는 HTML 한 파일과, 엑셀에서 한글이 깨지지 않는 CSV를 만든다. HTML은 정답·예측 SQL을 절마다 줄을 나눠 나란히 보여 주고, 다른 절과 다른 행을 색칠한다.
|
|
25
|
+
|
|
26
|
+
판정과 분석에 LLM, 무작위, 시간에 따라 달라지는 값을 쓰지 않는다. 같은 입력이면 같은 결과가 나온다.
|
|
27
|
+
|
|
28
|
+

|
|
29
|
+
|
|
30
|
+
HTML 리포트에서 오답 하나(#247)를 펼친 화면이다. 정답과 예측 SQL에서 다른 절(WHERE)과, 정답에 없는 예측 결과 행(`cl`, `h`)을 칠한다. 출력 차이(`row_count_differs`, `row_set_differs`)와 SQL 구조 차이(`tables_joins`)를 근거와 함께 보여 준다. 리포트 전체는 [examples/results/report.html](https://github.com/cheolkim02/text2sql-eval/blob/main/examples/results/report.html)이다. GitHub 화면에서는 HTML 소스로 보이니, 파일을 내려받아 브라우저로 연다.
|
|
31
|
+
|
|
32
|
+
## 설치
|
|
33
|
+
|
|
34
|
+
Python 3.11 이상이 필요하다.
|
|
35
|
+
|
|
36
|
+
```sh
|
|
37
|
+
pip install text2sql-eval
|
|
38
|
+
```
|
|
39
|
+
|
|
40
|
+
## 3분 사용법
|
|
41
|
+
|
|
42
|
+
예제 데이터는 패키지가 아니라 저장소에 들어 있다. BIRD dev의 DB 3개와 문제 432개, gpt-4o-mini의 예측 두 벌이다. 위에서 설치했다면 저장소는 데이터만 받으면 된다.
|
|
43
|
+
|
|
44
|
+
```sh
|
|
45
|
+
git clone https://github.com/cheolkim02/text2sql-eval.git
|
|
46
|
+
cd text2sql-eval
|
|
47
|
+
```
|
|
48
|
+
|
|
49
|
+
설치하지 않았거나 저장소의 코드로 설치하려면 여기서 `pip install .`을 한다. uv를 쓰면 `uv sync`를 하고 아래 명령 앞에 `uv run`을 붙인다. 자세한 안내는 [시작하기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/getting-started.md)에 있다.
|
|
50
|
+
|
|
51
|
+
판정하기(30초쯤 걸린다):
|
|
52
|
+
|
|
53
|
+
```sh
|
|
54
|
+
text2sql-eval eval \
|
|
55
|
+
--dataset examples/bird-mini/dev.json \
|
|
56
|
+
--db-dir examples/bird-mini/dev_databases \
|
|
57
|
+
--pred examples/results/gpt-4o-mini-evidence.jsonl \
|
|
58
|
+
--tied examples/bird-mini/dev_tied_append.json \
|
|
59
|
+
--out runs/evidence.json
|
|
60
|
+
```
|
|
61
|
+
|
|
62
|
+
`--tied`는 BIRD가 함께 주는 동점 대체 정답 파일이다. 정답 SQL이 동점 중 하나만 고르는 문제에 다른 정답을 알려 준다. 판정에는 쓰지 않고 플래그에만 쓰며, 빼도 된다.
|
|
63
|
+
|
|
64
|
+
```text
|
|
65
|
+
Evaluated 432 cases: EX 61.8% (267 correct, 161 incorrect, 4 errors)
|
|
66
|
+
Output difference: 62 column_mismatch, 58 row_set_differs, 44 single_value_differs, 34 empty_result, 31 row_count_differs, 4 execution_failed
|
|
67
|
+
SQL structure difference: 79 columns, 72 tables_joins, 66 aggregation, 25 where_value, 23 order_limit
|
|
68
|
+
Flags: 8 gold_columns_concatenated, 25 gold_rows_with_extra_columns, 5 matches_tied_alternative_only, 13 tied_alternative_exists
|
|
69
|
+
Run file: runs/evidence.json
|
|
70
|
+
```
|
|
71
|
+
|
|
72
|
+
리포트 만들기(`runs/evidence.html`을 브라우저로 연다):
|
|
73
|
+
|
|
74
|
+
```sh
|
|
75
|
+
text2sql-eval report runs/evidence.json --html runs/evidence.html --csv runs/evidence.csv
|
|
76
|
+
```
|
|
77
|
+
|
|
78
|
+
evidence를 뺀 실험과 비교하기:
|
|
79
|
+
|
|
80
|
+
```sh
|
|
81
|
+
text2sql-eval compare examples/results/gpt-4o-mini-no-evidence.run.json runs/evidence.json
|
|
82
|
+
```
|
|
83
|
+
|
|
84
|
+
```text
|
|
85
|
+
Comparing examples/results/gpt-4o-mini-no-evidence.run.json -> runs/evidence.json (432 common cases)
|
|
86
|
+
EX: 37.5% -> 61.8% (+24.3 pp)
|
|
87
|
+
Both correct 144 | Fixed 123 | Regressed 18 | Both wrong 147
|
|
88
|
+
By difficulty: challenging 29.1% -> 47.3%, moderate 27.7% -> 54.6%, simple 43.8% -> 68.2%
|
|
89
|
+
By database: student_club 43.0% -> 57.0%, superhero 57.4% -> 79.8%, toxicology 13.8% -> 51.0%
|
|
90
|
+
Output difference: empty_result 100 -> 34, single_value_differs 94 -> 44, column_mismatch 78 -> 62, row_set_differs 46 -> 58, row_count_differs 26 -> 31, execution_failed 9 -> 4
|
|
91
|
+
SQL structure difference: columns 155 -> 79, where_value 132 -> 25, tables_joins 130 -> 72, aggregation 121 -> 66, order_limit 40 -> 23
|
|
92
|
+
```
|
|
93
|
+
|
|
94
|
+
## 내 실험에 쓰기
|
|
95
|
+
|
|
96
|
+
가장 널리 쓰이는 BIRD 형식을 기준으로, 파일 세 개가 필요하다.
|
|
97
|
+
|
|
98
|
+
1. **문제 파일(`--dataset`):** BIRD의 `dev.json`과 같은 JSON 배열이다. 문제마다 `question_id`(정수), `db_id`, `question`, `evidence`, `SQL`(정답 SQL)이 있다. `difficulty`가 있으면 난이도별 EX도 낸다.
|
|
99
|
+
2. **DB 폴더(`--db-dir`):** `<db-dir>/<db_id>/<db_id>.sqlite` 구조의 SQLite 파일이다. BIRD의 `dev_databases` 폴더가 이 구조다.
|
|
100
|
+
3. **예측 파일(`--pred`):** 모델이 만든 SQL이다. 두 형식 중 하나로 쓴다.
|
|
101
|
+
- `.txt`: 한 줄에 SQL 하나. N번째 줄이 문제 파일의 N번째 문제의 예측이다.
|
|
102
|
+
- `.jsonl`: 한 줄에 `{"id": question_id, "sql": "..."}` 하나. 줄 순서는 상관없다.
|
|
103
|
+
|
|
104
|
+
```text
|
|
105
|
+
{"id": 195, "sql": "SELECT T.bond_type FROM bond AS T GROUP BY T.bond_type ORDER BY COUNT(*) DESC LIMIT 1"}
|
|
106
|
+
{"id": 196, "sql": "SELECT COUNT(*) FROM atom WHERE element = 'cl'"}
|
|
107
|
+
```
|
|
108
|
+
|
|
109
|
+
```sh
|
|
110
|
+
text2sql-eval eval --dataset dev.json --db-dir dev_databases \
|
|
111
|
+
--pred my_predictions.jsonl --meta model=my-model --out runs/my-run.json
|
|
112
|
+
text2sql-eval report runs/my-run.json --html runs/my-run.html
|
|
113
|
+
```
|
|
114
|
+
|
|
115
|
+
`--meta`로 모델 이름이나 프롬프트 버전 같은 실험 설정을 판정 결과 파일에 함께 남긴다. 예측 파일을 만드는 법은 [예측 파일 만들기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/prediction-format.md)에 있다.
|
|
116
|
+
|
|
117
|
+
Python에서는 같은 일을 이렇게 한다([API 레퍼런스](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/reference/api.md)).
|
|
118
|
+
|
|
119
|
+
```python
|
|
120
|
+
from pathlib import Path
|
|
121
|
+
|
|
122
|
+
from text2sql_eval import evaluate_files, write_html_report, write_run
|
|
123
|
+
|
|
124
|
+
run = evaluate_files(
|
|
125
|
+
Path("dev.json"),
|
|
126
|
+
Path("my_predictions.jsonl"),
|
|
127
|
+
db_dir=Path("dev_databases"),
|
|
128
|
+
)
|
|
129
|
+
print(f"EX {run.summary.ex:.1%}")
|
|
130
|
+
write_run(run, Path("runs/my-run.json"))
|
|
131
|
+
write_html_report(run, Path("runs/my-run.html"), run_name="my-run")
|
|
132
|
+
```
|
|
133
|
+
|
|
134
|
+
## 실측 결과
|
|
135
|
+
|
|
136
|
+
저장소에 커밋된 baseline이다. `examples/bird-mini`(BIRD dev, 432문제)에서 gpt-4o-mini로 같은 프롬프트를 두 번 돌렸고, 다른 점은 BIRD의 `evidence`(힌트)를 넣었는지 하나다.
|
|
137
|
+
|
|
138
|
+
| 설정 | EX | simple | moderate | challenging | BIRD 공식 스크립트 |
|
|
139
|
+
| --- | --- | --- | --- | --- | --- |
|
|
140
|
+
| evidence 있음 | **61.81%** | 68.22% | 54.62% | 47.27% | 61.81% (일치) |
|
|
141
|
+
| evidence 없음 | **37.50%** | 43.80% | 27.73% | 29.09% | 37.50% (일치) |
|
|
142
|
+
|
|
143
|
+
- **공식 스크립트와 일치:** 공식 평가 스크립트를 수정하지 않고 같은 예측을 채점했다. 난이도별 숫자까지 8개가 모두 소수점 둘째 자리까지 같다.
|
|
144
|
+
- **거짓 오답 의심:** evidence 있음 실험의 오답 161개 중 38개(24%)에 플래그가 붙었다. 공식 규칙으로는 오답이지만 사람이 보면 맞다고 할 만한 답이다. 예를 들어 #1445는 이름과 성을 한 컬럼으로 이어 붙였고, #300은 원자 id에 원소 컬럼을 덧붙였다.
|
|
145
|
+
- **두 실험 비교:** evidence를 넣자 123개가 맞게 바뀌고 18개가 틀리게 바뀌었다(+24.3%p). `where_value` 차이가 132개에서 25개로 가장 많이 줄었다. evidence가 주로 WHERE에 들어갈 값(철자, 대소문자, 코드값)을 알려 주기 때문이다.
|
|
146
|
+
|
|
147
|
+
생성 조건, 비용, 시간 제한에 민감한 케이스는 [examples/results](https://github.com/cheolkim02/text2sql-eval/tree/main/examples/results)에 있다.
|
|
148
|
+
|
|
149
|
+
## 문서
|
|
150
|
+
|
|
151
|
+
| 문서 | 내용 |
|
|
152
|
+
| --- | --- |
|
|
153
|
+
| [시작하기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/getting-started.md) | 설치부터 예제로 `eval → report → compare`까지 |
|
|
154
|
+
| [예측 파일 만들기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/prediction-format.md) | 내 파이프라인의 결과를 넣는 법 |
|
|
155
|
+
| [결과 읽기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/reading-results.md) | 판정 규칙, 차이와 플래그의 뜻, HTML 리포트, CSV로 손 분류하기 |
|
|
156
|
+
| [실험 비교하기](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/guides/comparing-runs.md) | 비교 결과 해석, CI에서 쓰기 |
|
|
157
|
+
| [CLI 레퍼런스](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/reference/cli.md) | 명령과 옵션, 종료 코드, 출력 형식 |
|
|
158
|
+
| [API 레퍼런스](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/reference/api.md) | 공개 Python API 38개 |
|
|
159
|
+
| [판정 결과 파일 형식](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/reference/run-file.md) | `eval`이 쓰는 JSON |
|
|
160
|
+
| [아키텍처](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/architecture.md) | 모듈 경계, 의존 방향, 설계 원칙 |
|
|
161
|
+
| [기여 안내](https://github.com/cheolkim02/text2sql-eval/blob/main/CONTRIBUTING.md) | 개발 환경, 검사, 커밋 규칙 |
|
|
162
|
+
|
|
163
|
+
## 한계와 로드맵
|
|
164
|
+
|
|
165
|
+
- **지원 형식:** 가장 널리 쓰이는 BIRD 형식(문제 파일, DB 폴더)을 먼저 지원한다. 예측은 텍스트(`.txt`)와 JSONL(`.jsonl`)로 받는다. 다른 벤치마크 형식은 추가할 예정이다.
|
|
166
|
+
- **실행 엔진:** SQLite만 실행한다. PostgreSQL·MySQL은 로드맵이다.
|
|
167
|
+
- **판정:** BIRD 공식 규칙 하나로만 판정한다. 행 순서와 중복까지 따지는 엄격 모드는 로드맵이다.
|
|
168
|
+
- **정규화:** SQL 구조 차이의 정규화는 최소한이다. 조건 순서, `IN`과 `EXISTS`, 서브쿼리와 JOIN처럼 뜻은 같고 모양이 다른 SQL은 다르게 본다.
|
|
169
|
+
- **카테고리 매핑:** 사용자가 정한 카테고리를 파일로 자동으로 붙이는 기능은 로드맵이다. 지금은 CSV의 `my_category` 열에 손으로 적는다.
|
|
170
|
+
- **버전:** 아직 0.x 버전이라 공개 API와 판정 결과 파일 형식이 바뀔 수 있다. 판정 결과 파일에는 형식 버전(`schema_version`)이 들어 있다.
|
|
171
|
+
|
|
172
|
+
## 해결하려는 문제
|
|
173
|
+
|
|
174
|
+
text-to-SQL 실험에서는 실험을 돌리는 것보다 결과를 판단하는 데 시간이 더 오래 걸린다.
|
|
175
|
+
|
|
176
|
+
- **오답 분석이 수작업이다.** 틀린 케이스마다 정답과 예측 SQL을 읽고, 다른 곳을 찾아 엑셀에 적고, 카테고리를 붙인다. 질문이나 SQL이 길면 읽기조차 힘들다.
|
|
177
|
+
- **분류를 AI에게 맡길 수 없다.** 평가 결과를 LLM이 분류하면 그 분류에도 오류가 섞여, 평가를 믿을 수 없게 된다.
|
|
178
|
+
- **EX 판정 자체가 틀린다.** 정답 결과가 비어 있으면 빈 결과를 내는 아무 SQL이나 정답이 된다. 사람 이름을 물었을 때 이름과 성을 한 컬럼으로 이어 붙여 내면, 내용이 맞아도 오답이 된다.
|
|
179
|
+
- **실험 비교도 수작업이다.** 두 설정에서 둘 다 틀린 문제, 한쪽만 틀린 문제를 스크립트로 뽑아 눈으로 본다.
|
|
180
|
+
|
|
181
|
+
그래서 이 도구는 "무엇이 다른가"를 규칙으로 보고하고, "왜 틀렸나"는 사람이 판단하게 둔다.
|
|
182
|
+
|
|
183
|
+
## 품질
|
|
184
|
+
|
|
185
|
+
- **타입:** pyright strict에서 오류가 0개다. 공개 API에 `Any`가 없고, 타입 정보(`py.typed`)를 함께 배포한다.
|
|
186
|
+
- **CI:** GitHub Actions에서 다음을 돌린다.
|
|
187
|
+
- Ruff 린트와 포맷 검사, pyright
|
|
188
|
+
- Python 3.11~3.15 테스트
|
|
189
|
+
- 빌드한 wheel을 개발 도구 없는 새 환경에 설치해 CLI를 실제로 돌려 보기
|
|
190
|
+
- **테스트:** 단위 테스트, Hypothesis 속성 기반 테스트, 실제 프로세스로 돌리는 e2e 테스트가 있다. 그 밖에 이런 것을 지킨다.
|
|
191
|
+
- 커밋된 baseline이 예측 파일에서 그대로 다시 나오는지
|
|
192
|
+
- 문서가 코드와 어긋나지 않는지
|
|
193
|
+
|
|
194
|
+
## AI와 함께 만든 방식
|
|
195
|
+
|
|
196
|
+
이 저장소는 Claude Code와 함께 만들었다. 설계 결정은 모두 사람이 하고 이유와 함께 [결정 기록](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/decisions/README.md)으로 남겼으며, 에이전트는 선택지 제시와 구현·테스트·문서 초안을 맡았다. 역할 규칙은 [AGENTS.md](https://github.com/cheolkim02/text2sql-eval/blob/main/AGENTS.md)에, 사람이 기각한 추천과 AI가 틀린 사례는 [AI와 함께 개발한 방식](https://github.com/cheolkim02/text2sql-eval/blob/main/docs/ai-workflow.md)에 있다.
|
|
197
|
+
|
|
198
|
+
## 라이선스
|
|
199
|
+
|
|
200
|
+
- 코드: [MIT](https://github.com/cheolkim02/text2sql-eval/blob/main/LICENSE)
|
|
201
|
+
- 예제 데이터 `examples/bird-mini`: [BIRD](https://bird-bench.github.io/) dev의 일부, [CC BY-SA 4.0](https://github.com/cheolkim02/text2sql-eval/blob/main/examples/bird-mini/LICENSE)(출처와 바꾼 점은 [SOURCE.md](https://github.com/cheolkim02/text2sql-eval/blob/main/examples/bird-mini/SOURCE.md))
|
|
@@ -1,7 +1,7 @@
|
|
|
1
1
|
[project]
|
|
2
2
|
name = "text2sql-eval"
|
|
3
|
-
version = "0.1.
|
|
4
|
-
description = "Deterministic
|
|
3
|
+
version = "0.1.1"
|
|
4
|
+
description = "Deterministic error analysis and run comparison for text-to-SQL experiments, with BIRD-compatible EX"
|
|
5
5
|
readme = "README.md"
|
|
6
6
|
license = "MIT"
|
|
7
7
|
license-files = ["LICENSE"]
|
|
@@ -1,7 +1,7 @@
|
|
|
1
1
|
[project]
|
|
2
2
|
name = "text2sql-eval"
|
|
3
|
-
version = "0.1.
|
|
4
|
-
description = "Deterministic
|
|
3
|
+
version = "0.1.1"
|
|
4
|
+
description = "Deterministic error analysis and run comparison for text-to-SQL experiments, with BIRD-compatible EX"
|
|
5
5
|
readme = "README.md"
|
|
6
6
|
license = "MIT"
|
|
7
7
|
license-files = ["LICENSE"]
|
text2sql_eval-0.1.0/PKG-INFO
DELETED
|
@@ -1,176 +0,0 @@
|
|
|
1
|
-
Metadata-Version: 2.4
|
|
2
|
-
Name: text2sql-eval
|
|
3
|
-
Version: 0.1.0
|
|
4
|
-
Summary: Deterministic, evidence-backed error analysis and run comparison for text-to-SQL experiments
|
|
5
|
-
Keywords: text-to-sql,nl2sql,evaluation,error-analysis,bird
|
|
6
|
-
Author: cheolkim02
|
|
7
|
-
License-Expression: MIT
|
|
8
|
-
License-File: LICENSE
|
|
9
|
-
Classifier: Development Status :: 3 - Alpha
|
|
10
|
-
Classifier: Intended Audience :: Science/Research
|
|
11
|
-
Classifier: Programming Language :: Python :: 3
|
|
12
|
-
Classifier: Programming Language :: Python :: 3 :: Only
|
|
13
|
-
Classifier: Programming Language :: Python :: 3.11
|
|
14
|
-
Classifier: Programming Language :: Python :: 3.12
|
|
15
|
-
Classifier: Programming Language :: Python :: 3.13
|
|
16
|
-
Classifier: Programming Language :: Python :: 3.14
|
|
17
|
-
Classifier: Programming Language :: Python :: 3.15
|
|
18
|
-
Classifier: Topic :: Database
|
|
19
|
-
Classifier: Topic :: Scientific/Engineering :: Artificial Intelligence
|
|
20
|
-
Classifier: Typing :: Typed
|
|
21
|
-
Requires-Dist: jinja2>=3.1.6
|
|
22
|
-
Requires-Dist: sqlglot>=30.31.0
|
|
23
|
-
Requires-Python: >=3.11
|
|
24
|
-
Project-URL: Repository, https://github.com/cheolkim02/text2sql-eval
|
|
25
|
-
Project-URL: Documentation, https://github.com/cheolkim02/text2sql-eval/tree/main/docs
|
|
26
|
-
Project-URL: Issues, https://github.com/cheolkim02/text2sql-eval/issues
|
|
27
|
-
Description-Content-Type: text/markdown
|
|
28
|
-
|
|
29
|
-
# text2sql-eval
|
|
30
|
-
|
|
31
|
-
[](https://github.com/cheolkim02/text2sql-eval/actions/workflows/ci.yml)
|
|
32
|
-
|
|
33
|
-
**English summary.** `text2sql-eval` is a Python library and CLI for the error analysis of text-to-SQL experiments. Given a BIRD-style dataset, SQLite databases and a file of predicted SQL, it judges execution accuracy (EX) exactly like BIRD's official script; on the bundled example its numbers match the official script to two decimals. It then explains every wrong case without using an LLM: how the executed results differ, and where the SQL differs, with evidence. It flags verdicts that the official rule may get wrong, such as an answer that returns every gold row plus an extra column. It also compares two runs case by case and writes an offline HTML report and an Excel-ready CSV. Everything is deterministic: the same inputs give the same output. Documentation is in Korean.
|
|
34
|
-
|
|
35
|
-
text-to-SQL 실험의 예측 파일을 받아 **EX(실행 정확도)를 판정하고, 오답이 정답과 무엇이 다른지를 AI 없이 근거와 함께 보여 주는** Python 라이브러리이자 CLI다.
|
|
36
|
-
|
|
37
|
-
## 왜 만들었나
|
|
38
|
-
|
|
39
|
-
text-to-SQL 연구를 하면서 실험을 돌리는 것보다 결과를 판단하는 데 시간이 더 오래 걸렸다.
|
|
40
|
-
|
|
41
|
-
- **오답 분석을 손으로 했다.** 틀린 케이스마다 정답과 예측 SQL을 읽고, 다른 곳을 찾아 엑셀에 적고, 카테고리를 붙였다. 질문이나 SQL이 길면 읽기조차 힘들었다.
|
|
42
|
-
- **분류를 AI에게 맡길 수 없었다.** 평가 결과를 LLM이 분류하면 그 분류에도 오류가 섞여, 평가를 믿을 수 없게 된다.
|
|
43
|
-
- **EX 판정 자체가 틀린다.** 정답 결과가 비어 있으면 빈 결과를 내는 아무 SQL이나 정답이 된다. 사람 이름을 물었을 때 이름과 성을 한 컬럼으로 이어 붙여 내면, 내용이 맞아도 오답이 된다.
|
|
44
|
-
- **실험 비교도 손으로 했다.** 두 설정에서 둘 다 틀린 문제, 한쪽만 틀린 문제를 스크립트로 뽑아 눈으로 봤다.
|
|
45
|
-
|
|
46
|
-
그래서 "무엇이 다른가"는 도구가 규칙으로 보고하고, "왜 틀렸나"는 사람이 판단하도록 나눴다.
|
|
47
|
-
|
|
48
|
-
## 무엇을 하나
|
|
49
|
-
|
|
50
|
-
- **EX 판정:** BIRD 공식 스크립트와 같은 규칙(행 집합 비교)으로 판정한다. 같은 예측을 공식 스크립트로도 채점해 숫자가 같음을 확인했다.
|
|
51
|
-
- **오답의 차이:** 오답마다 두 가지를 근거와 함께 붙인다. 한 오답에 여러 개가 붙을 수 있다.
|
|
52
|
-
- 출력 차이 6종: 빈 결과, 컬럼 수, 행 수, 값 하나, 행 내용, 실행 실패
|
|
53
|
-
- SQL 구조 차이 5종: WHERE 값, 테이블·JOIN, 컬럼, 집계, ORDER BY/LIMIT
|
|
54
|
-
- **판정 신뢰도 플래그:** 공식 규칙이 놓쳤을 수 있는 판정 6가지를 표시한다(거짓 정답 의심, 거짓 오답 의심). 판정 자체는 바꾸지 않는다.
|
|
55
|
-
- **두 실행 비교:** 케이스 단위 분할표(고쳐짐, 나빠짐), 난이도별·DB별 EX, 차이 분포의 변화를 보여 준다. 기준보다 나빠지면 실패하게 해서 CI에서도 쓸 수 있다.
|
|
56
|
-
- **리포트:** 인터넷 없이 열리는 HTML 한 파일과, 엑셀에서 한글이 깨지지 않는 CSV를 만든다. HTML은 정답·예측 SQL을 절마다 줄을 나눠 나란히 보여 주고, 다른 절과 다른 행을 색칠한다.
|
|
57
|
-
|
|
58
|
-
판정과 분석에 LLM, 무작위, 시간에 따라 달라지는 값을 쓰지 않는다. 같은 입력이면 같은 결과가 나온다.
|
|
59
|
-
|
|
60
|
-

|
|
61
|
-
|
|
62
|
-
HTML 리포트에서 오답 하나(#247)를 펼친 화면이다. 정답과 예측 SQL에서 다른 절(WHERE)과, 정답에 없는 예측 결과 행(`cl`, `h`)을 칠한다. 출력 차이(`row_count_differs`, `row_set_differs`)와 SQL 구조 차이(`tables_joins`)를 근거와 함께 보여 준다. 리포트 전체는 [examples/results/report.html](examples/results/report.html)이다. 내려받아 브라우저로 열면 된다.
|
|
63
|
-
|
|
64
|
-
## 3분 사용법
|
|
65
|
-
|
|
66
|
-
Python 3.11 이상이 필요하다. 저장소에 BIRD dev의 DB 3개와 문제 432개, gpt-4o-mini의 예측 두 벌이 들어 있어서 받자마자 돌려 볼 수 있다.
|
|
67
|
-
|
|
68
|
-
```sh
|
|
69
|
-
git clone https://github.com/cheolkim02/text2sql-eval.git
|
|
70
|
-
cd text2sql-eval
|
|
71
|
-
python -m venv .venv && . .venv/bin/activate
|
|
72
|
-
pip install .
|
|
73
|
-
```
|
|
74
|
-
|
|
75
|
-
판정하기(30초쯤 걸린다):
|
|
76
|
-
|
|
77
|
-
```sh
|
|
78
|
-
text2sql-eval eval \
|
|
79
|
-
--dataset examples/bird-mini/dev.json \
|
|
80
|
-
--db-dir examples/bird-mini/dev_databases \
|
|
81
|
-
--pred examples/results/gpt-4o-mini-evidence.jsonl \
|
|
82
|
-
--tied examples/bird-mini/dev_tied_append.json \
|
|
83
|
-
--out runs/evidence.json
|
|
84
|
-
```
|
|
85
|
-
|
|
86
|
-
```text
|
|
87
|
-
Evaluated 432 cases: EX 61.8% (267 correct, 161 incorrect, 4 errors)
|
|
88
|
-
Output difference: 62 column_mismatch, 58 row_set_differs, 44 single_value_differs, 34 empty_result, 31 row_count_differs, 4 execution_failed
|
|
89
|
-
SQL structure difference: 79 columns, 72 tables_joins, 66 aggregation, 25 where_value, 23 order_limit
|
|
90
|
-
Flags: 8 gold_columns_concatenated, 25 gold_rows_with_extra_columns, 5 matches_tied_alternative_only, 13 tied_alternative_exists
|
|
91
|
-
Run file: runs/evidence.json
|
|
92
|
-
```
|
|
93
|
-
|
|
94
|
-
리포트 만들기(`runs/evidence.html`을 브라우저로 연다):
|
|
95
|
-
|
|
96
|
-
```sh
|
|
97
|
-
text2sql-eval report runs/evidence.json --html runs/evidence.html --csv runs/evidence.csv
|
|
98
|
-
```
|
|
99
|
-
|
|
100
|
-
evidence를 뺀 실행과 비교하기:
|
|
101
|
-
|
|
102
|
-
```sh
|
|
103
|
-
text2sql-eval compare examples/results/gpt-4o-mini-no-evidence.run.json runs/evidence.json
|
|
104
|
-
```
|
|
105
|
-
|
|
106
|
-
uv를 쓰면 `pip install .` 대신 `uv sync`를 하고, 명령 앞에 `uv run`을 붙인다. 자세한 안내는 [시작하기](docs/guides/getting-started.md)에 있다.
|
|
107
|
-
|
|
108
|
-
내 실험의 결과를 넣으려면 예측을 한 줄에 SQL 하나인 텍스트나 JSONL로 쓰면 된다([예측 파일 만들기](docs/guides/prediction-format.md)). 같은 일을 Python에서 하려면 `text2sql_eval.evaluate_files`를 쓴다([API](docs/reference/api.md)).
|
|
109
|
-
|
|
110
|
-
## 실측 결과
|
|
111
|
-
|
|
112
|
-
저장소에 커밋된 baseline이다. `examples/bird-mini`(BIRD dev, 432문제)에서 gpt-4o-mini로 같은 프롬프트를 두 번 돌렸고, 다른 점은 BIRD의 `evidence`(힌트)를 넣었는지 하나다.
|
|
113
|
-
|
|
114
|
-
| 설정 | EX | simple | moderate | challenging | BIRD 공식 스크립트 |
|
|
115
|
-
| --- | --- | --- | --- | --- | --- |
|
|
116
|
-
| evidence 있음 | **61.81%** | 68.22% | 54.62% | 47.27% | 61.81% (일치) |
|
|
117
|
-
| evidence 없음 | **37.50%** | 43.80% | 27.73% | 29.09% | 37.50% (일치) |
|
|
118
|
-
|
|
119
|
-
- **공식 스크립트와 일치:** 공식 평가 스크립트를 수정하지 않고 같은 예측을 채점했다. 난이도별 숫자까지 8개가 모두 소수점 둘째 자리까지 같다.
|
|
120
|
-
- **거짓 오답 의심:** evidence 있음 실행의 오답 161개 중 38개(24%)에 플래그가 붙었다. 공식 규칙으로는 오답이지만 사람이 보면 맞다고 할 만한 답이다. 예를 들어 #1445는 이름과 성을 한 컬럼으로 이어 붙였고, #300은 원자 id에 원소 컬럼을 덧붙였다.
|
|
121
|
-
- **두 실행 비교:** evidence를 넣자 123개가 맞게 바뀌고 18개가 틀리게 바뀌었다(+24.3%p). `where_value` 차이가 132개에서 25개로 가장 많이 줄었다. evidence가 주로 WHERE에 들어갈 값(철자, 대소문자, 코드값)을 알려 주기 때문이다.
|
|
122
|
-
|
|
123
|
-
생성 조건, 비용, 시간 제한에 민감한 케이스는 [examples/results](examples/results/README.md)에 있다.
|
|
124
|
-
|
|
125
|
-
## 문서
|
|
126
|
-
|
|
127
|
-
| 문서 | 내용 |
|
|
128
|
-
| --- | --- |
|
|
129
|
-
| [시작하기](docs/guides/getting-started.md) | 설치부터 예제로 `eval → report → compare`까지 |
|
|
130
|
-
| [예측 파일 만들기](docs/guides/prediction-format.md) | 내 파이프라인의 결과를 넣는 법 |
|
|
131
|
-
| [결과 읽기](docs/guides/reading-results.md) | 판정 규칙, 차이와 플래그의 뜻, HTML 리포트, CSV로 손 분류하기 |
|
|
132
|
-
| [실행 비교하기](docs/guides/comparing-runs.md) | 비교 결과 해석, CI에서 쓰기 |
|
|
133
|
-
| [CLI 레퍼런스](docs/reference/cli.md) | 명령과 옵션, 종료 코드, 출력 형식 |
|
|
134
|
-
| [API 레퍼런스](docs/reference/api.md) | 공개 Python API 38개 |
|
|
135
|
-
| [실행 파일 형식](docs/reference/run-file.md) | `eval`이 쓰는 JSON |
|
|
136
|
-
| [아키텍처](docs/architecture.md) | 모듈 경계, 의존 방향, 설계 원칙 |
|
|
137
|
-
| [기여 안내](CONTRIBUTING.md) | 개발 환경, 검사, 커밋 규칙 |
|
|
138
|
-
|
|
139
|
-
## 품질
|
|
140
|
-
|
|
141
|
-
- **타입:** pyright strict에서 오류가 0개다. 공개 API에 `Any`가 없고, 타입 정보(`py.typed`)를 함께 배포한다.
|
|
142
|
-
- **CI:** GitHub Actions에서 다음을 돌린다.
|
|
143
|
-
- Ruff 린트와 포맷 검사, pyright
|
|
144
|
-
- Python 3.11~3.15 테스트
|
|
145
|
-
- 빌드한 wheel을 개발 도구 없는 새 환경에 설치해 CLI를 실제로 돌려 보기
|
|
146
|
-
- **테스트:** 단위 테스트, Hypothesis 속성 기반 테스트, 실제 프로세스로 돌리는 e2e 테스트가 있다. 그 밖에 이런 것을 지킨다.
|
|
147
|
-
- 커밋된 baseline이 예측 파일에서 그대로 다시 나오는지
|
|
148
|
-
- 문서가 코드와 어긋나지 않는지
|
|
149
|
-
|
|
150
|
-
## AI와 함께 만든 방식
|
|
151
|
-
|
|
152
|
-
이 저장소는 Claude Code와 함께 만들었다. 역할은 [AGENTS.md](AGENTS.md)에 정해 두었다. 사람이 설계를 결정하고 리뷰하며, 에이전트는 선택지를 제시하고 구현·테스트·문서 초안을 맡는다.
|
|
153
|
-
|
|
154
|
-
- **설계 결정은 모두 사람이 했다.** 공개 API, 의존성, 파일 형식, 판정·차이·플래그 규칙, 도구 선택이 결정 대상이다. 에이전트가 선택지와 장단점을 표로 제시하고, 사람이 고르면 그 자리에서 결정 기록(ADR)을 남긴다. [결정 기록 45개](docs/decisions/README.md)는 모두 결정자가 사람이고, 사람이 한 말을 그대로 인용한다. 에이전트의 추천을 고르지 않은 결정도 그대로 적었다. 예를 들어 Ruff 규칙 세트, baseline 모델, 통계 검정을 넣지 않기로 한 것이 그렇다.
|
|
155
|
-
- **작게 나눠 검토했다.** 기능마다 순서를 지켰다.
|
|
156
|
-
1. 계획 승인
|
|
157
|
-
2. 테스트와 구현
|
|
158
|
-
3. 자가 검토 체크리스트
|
|
159
|
-
4. 사람의 diff 검토
|
|
160
|
-
5. PR, CI 통과 후 merge
|
|
161
|
-
- **기록:** AI가 함께 쓴 커밋에는 `Co-Authored-By`를 붙였다.
|
|
162
|
-
|
|
163
|
-
역할 분담, 사람이 기각한 추천, AI가 틀린 대표 사례와 그것을 잡은 방법은 [AI와 함께 개발한 방식](docs/ai-workflow.md)에 정리했다.
|
|
164
|
-
|
|
165
|
-
## 한계와 로드맵
|
|
166
|
-
|
|
167
|
-
- **실행 엔진:** SQLite만 실행한다. PostgreSQL·MySQL은 로드맵이다.
|
|
168
|
-
- **판정:** BIRD 공식 규칙 하나로만 판정한다. 행 순서와 중복까지 따지는 엄격 모드는 로드맵이다.
|
|
169
|
-
- **정규화:** SQL 구조 차이의 정규화는 최소한이다. 조건 순서, `IN`과 `EXISTS`, 서브쿼리와 JOIN처럼 뜻은 같고 모양이 다른 SQL은 다르게 본다.
|
|
170
|
-
- **카테고리 매핑:** 사용자가 정한 카테고리를 파일로 자동으로 붙이는 기능은 로드맵이다. 지금은 CSV의 `my_category` 열에 손으로 적는다.
|
|
171
|
-
- **설치:** PyPI에는 아직 배포하지 않았다. 저장소에서 설치한다.
|
|
172
|
-
|
|
173
|
-
## 라이선스
|
|
174
|
-
|
|
175
|
-
- 코드: [MIT](LICENSE)
|
|
176
|
-
- 예제 데이터 `examples/bird-mini`: [BIRD](https://bird-bench.github.io/) dev의 일부, [CC BY-SA 4.0](examples/bird-mini/LICENSE)(출처와 바꾼 점은 [SOURCE.md](examples/bird-mini/SOURCE.md))
|
text2sql_eval-0.1.0/README.md
DELETED
|
@@ -1,148 +0,0 @@
|
|
|
1
|
-
# text2sql-eval
|
|
2
|
-
|
|
3
|
-
[](https://github.com/cheolkim02/text2sql-eval/actions/workflows/ci.yml)
|
|
4
|
-
|
|
5
|
-
**English summary.** `text2sql-eval` is a Python library and CLI for the error analysis of text-to-SQL experiments. Given a BIRD-style dataset, SQLite databases and a file of predicted SQL, it judges execution accuracy (EX) exactly like BIRD's official script; on the bundled example its numbers match the official script to two decimals. It then explains every wrong case without using an LLM: how the executed results differ, and where the SQL differs, with evidence. It flags verdicts that the official rule may get wrong, such as an answer that returns every gold row plus an extra column. It also compares two runs case by case and writes an offline HTML report and an Excel-ready CSV. Everything is deterministic: the same inputs give the same output. Documentation is in Korean.
|
|
6
|
-
|
|
7
|
-
text-to-SQL 실험의 예측 파일을 받아 **EX(실행 정확도)를 판정하고, 오답이 정답과 무엇이 다른지를 AI 없이 근거와 함께 보여 주는** Python 라이브러리이자 CLI다.
|
|
8
|
-
|
|
9
|
-
## 왜 만들었나
|
|
10
|
-
|
|
11
|
-
text-to-SQL 연구를 하면서 실험을 돌리는 것보다 결과를 판단하는 데 시간이 더 오래 걸렸다.
|
|
12
|
-
|
|
13
|
-
- **오답 분석을 손으로 했다.** 틀린 케이스마다 정답과 예측 SQL을 읽고, 다른 곳을 찾아 엑셀에 적고, 카테고리를 붙였다. 질문이나 SQL이 길면 읽기조차 힘들었다.
|
|
14
|
-
- **분류를 AI에게 맡길 수 없었다.** 평가 결과를 LLM이 분류하면 그 분류에도 오류가 섞여, 평가를 믿을 수 없게 된다.
|
|
15
|
-
- **EX 판정 자체가 틀린다.** 정답 결과가 비어 있으면 빈 결과를 내는 아무 SQL이나 정답이 된다. 사람 이름을 물었을 때 이름과 성을 한 컬럼으로 이어 붙여 내면, 내용이 맞아도 오답이 된다.
|
|
16
|
-
- **실험 비교도 손으로 했다.** 두 설정에서 둘 다 틀린 문제, 한쪽만 틀린 문제를 스크립트로 뽑아 눈으로 봤다.
|
|
17
|
-
|
|
18
|
-
그래서 "무엇이 다른가"는 도구가 규칙으로 보고하고, "왜 틀렸나"는 사람이 판단하도록 나눴다.
|
|
19
|
-
|
|
20
|
-
## 무엇을 하나
|
|
21
|
-
|
|
22
|
-
- **EX 판정:** BIRD 공식 스크립트와 같은 규칙(행 집합 비교)으로 판정한다. 같은 예측을 공식 스크립트로도 채점해 숫자가 같음을 확인했다.
|
|
23
|
-
- **오답의 차이:** 오답마다 두 가지를 근거와 함께 붙인다. 한 오답에 여러 개가 붙을 수 있다.
|
|
24
|
-
- 출력 차이 6종: 빈 결과, 컬럼 수, 행 수, 값 하나, 행 내용, 실행 실패
|
|
25
|
-
- SQL 구조 차이 5종: WHERE 값, 테이블·JOIN, 컬럼, 집계, ORDER BY/LIMIT
|
|
26
|
-
- **판정 신뢰도 플래그:** 공식 규칙이 놓쳤을 수 있는 판정 6가지를 표시한다(거짓 정답 의심, 거짓 오답 의심). 판정 자체는 바꾸지 않는다.
|
|
27
|
-
- **두 실행 비교:** 케이스 단위 분할표(고쳐짐, 나빠짐), 난이도별·DB별 EX, 차이 분포의 변화를 보여 준다. 기준보다 나빠지면 실패하게 해서 CI에서도 쓸 수 있다.
|
|
28
|
-
- **리포트:** 인터넷 없이 열리는 HTML 한 파일과, 엑셀에서 한글이 깨지지 않는 CSV를 만든다. HTML은 정답·예측 SQL을 절마다 줄을 나눠 나란히 보여 주고, 다른 절과 다른 행을 색칠한다.
|
|
29
|
-
|
|
30
|
-
판정과 분석에 LLM, 무작위, 시간에 따라 달라지는 값을 쓰지 않는다. 같은 입력이면 같은 결과가 나온다.
|
|
31
|
-
|
|
32
|
-

|
|
33
|
-
|
|
34
|
-
HTML 리포트에서 오답 하나(#247)를 펼친 화면이다. 정답과 예측 SQL에서 다른 절(WHERE)과, 정답에 없는 예측 결과 행(`cl`, `h`)을 칠한다. 출력 차이(`row_count_differs`, `row_set_differs`)와 SQL 구조 차이(`tables_joins`)를 근거와 함께 보여 준다. 리포트 전체는 [examples/results/report.html](examples/results/report.html)이다. 내려받아 브라우저로 열면 된다.
|
|
35
|
-
|
|
36
|
-
## 3분 사용법
|
|
37
|
-
|
|
38
|
-
Python 3.11 이상이 필요하다. 저장소에 BIRD dev의 DB 3개와 문제 432개, gpt-4o-mini의 예측 두 벌이 들어 있어서 받자마자 돌려 볼 수 있다.
|
|
39
|
-
|
|
40
|
-
```sh
|
|
41
|
-
git clone https://github.com/cheolkim02/text2sql-eval.git
|
|
42
|
-
cd text2sql-eval
|
|
43
|
-
python -m venv .venv && . .venv/bin/activate
|
|
44
|
-
pip install .
|
|
45
|
-
```
|
|
46
|
-
|
|
47
|
-
판정하기(30초쯤 걸린다):
|
|
48
|
-
|
|
49
|
-
```sh
|
|
50
|
-
text2sql-eval eval \
|
|
51
|
-
--dataset examples/bird-mini/dev.json \
|
|
52
|
-
--db-dir examples/bird-mini/dev_databases \
|
|
53
|
-
--pred examples/results/gpt-4o-mini-evidence.jsonl \
|
|
54
|
-
--tied examples/bird-mini/dev_tied_append.json \
|
|
55
|
-
--out runs/evidence.json
|
|
56
|
-
```
|
|
57
|
-
|
|
58
|
-
```text
|
|
59
|
-
Evaluated 432 cases: EX 61.8% (267 correct, 161 incorrect, 4 errors)
|
|
60
|
-
Output difference: 62 column_mismatch, 58 row_set_differs, 44 single_value_differs, 34 empty_result, 31 row_count_differs, 4 execution_failed
|
|
61
|
-
SQL structure difference: 79 columns, 72 tables_joins, 66 aggregation, 25 where_value, 23 order_limit
|
|
62
|
-
Flags: 8 gold_columns_concatenated, 25 gold_rows_with_extra_columns, 5 matches_tied_alternative_only, 13 tied_alternative_exists
|
|
63
|
-
Run file: runs/evidence.json
|
|
64
|
-
```
|
|
65
|
-
|
|
66
|
-
리포트 만들기(`runs/evidence.html`을 브라우저로 연다):
|
|
67
|
-
|
|
68
|
-
```sh
|
|
69
|
-
text2sql-eval report runs/evidence.json --html runs/evidence.html --csv runs/evidence.csv
|
|
70
|
-
```
|
|
71
|
-
|
|
72
|
-
evidence를 뺀 실행과 비교하기:
|
|
73
|
-
|
|
74
|
-
```sh
|
|
75
|
-
text2sql-eval compare examples/results/gpt-4o-mini-no-evidence.run.json runs/evidence.json
|
|
76
|
-
```
|
|
77
|
-
|
|
78
|
-
uv를 쓰면 `pip install .` 대신 `uv sync`를 하고, 명령 앞에 `uv run`을 붙인다. 자세한 안내는 [시작하기](docs/guides/getting-started.md)에 있다.
|
|
79
|
-
|
|
80
|
-
내 실험의 결과를 넣으려면 예측을 한 줄에 SQL 하나인 텍스트나 JSONL로 쓰면 된다([예측 파일 만들기](docs/guides/prediction-format.md)). 같은 일을 Python에서 하려면 `text2sql_eval.evaluate_files`를 쓴다([API](docs/reference/api.md)).
|
|
81
|
-
|
|
82
|
-
## 실측 결과
|
|
83
|
-
|
|
84
|
-
저장소에 커밋된 baseline이다. `examples/bird-mini`(BIRD dev, 432문제)에서 gpt-4o-mini로 같은 프롬프트를 두 번 돌렸고, 다른 점은 BIRD의 `evidence`(힌트)를 넣었는지 하나다.
|
|
85
|
-
|
|
86
|
-
| 설정 | EX | simple | moderate | challenging | BIRD 공식 스크립트 |
|
|
87
|
-
| --- | --- | --- | --- | --- | --- |
|
|
88
|
-
| evidence 있음 | **61.81%** | 68.22% | 54.62% | 47.27% | 61.81% (일치) |
|
|
89
|
-
| evidence 없음 | **37.50%** | 43.80% | 27.73% | 29.09% | 37.50% (일치) |
|
|
90
|
-
|
|
91
|
-
- **공식 스크립트와 일치:** 공식 평가 스크립트를 수정하지 않고 같은 예측을 채점했다. 난이도별 숫자까지 8개가 모두 소수점 둘째 자리까지 같다.
|
|
92
|
-
- **거짓 오답 의심:** evidence 있음 실행의 오답 161개 중 38개(24%)에 플래그가 붙었다. 공식 규칙으로는 오답이지만 사람이 보면 맞다고 할 만한 답이다. 예를 들어 #1445는 이름과 성을 한 컬럼으로 이어 붙였고, #300은 원자 id에 원소 컬럼을 덧붙였다.
|
|
93
|
-
- **두 실행 비교:** evidence를 넣자 123개가 맞게 바뀌고 18개가 틀리게 바뀌었다(+24.3%p). `where_value` 차이가 132개에서 25개로 가장 많이 줄었다. evidence가 주로 WHERE에 들어갈 값(철자, 대소문자, 코드값)을 알려 주기 때문이다.
|
|
94
|
-
|
|
95
|
-
생성 조건, 비용, 시간 제한에 민감한 케이스는 [examples/results](examples/results/README.md)에 있다.
|
|
96
|
-
|
|
97
|
-
## 문서
|
|
98
|
-
|
|
99
|
-
| 문서 | 내용 |
|
|
100
|
-
| --- | --- |
|
|
101
|
-
| [시작하기](docs/guides/getting-started.md) | 설치부터 예제로 `eval → report → compare`까지 |
|
|
102
|
-
| [예측 파일 만들기](docs/guides/prediction-format.md) | 내 파이프라인의 결과를 넣는 법 |
|
|
103
|
-
| [결과 읽기](docs/guides/reading-results.md) | 판정 규칙, 차이와 플래그의 뜻, HTML 리포트, CSV로 손 분류하기 |
|
|
104
|
-
| [실행 비교하기](docs/guides/comparing-runs.md) | 비교 결과 해석, CI에서 쓰기 |
|
|
105
|
-
| [CLI 레퍼런스](docs/reference/cli.md) | 명령과 옵션, 종료 코드, 출력 형식 |
|
|
106
|
-
| [API 레퍼런스](docs/reference/api.md) | 공개 Python API 38개 |
|
|
107
|
-
| [실행 파일 형식](docs/reference/run-file.md) | `eval`이 쓰는 JSON |
|
|
108
|
-
| [아키텍처](docs/architecture.md) | 모듈 경계, 의존 방향, 설계 원칙 |
|
|
109
|
-
| [기여 안내](CONTRIBUTING.md) | 개발 환경, 검사, 커밋 규칙 |
|
|
110
|
-
|
|
111
|
-
## 품질
|
|
112
|
-
|
|
113
|
-
- **타입:** pyright strict에서 오류가 0개다. 공개 API에 `Any`가 없고, 타입 정보(`py.typed`)를 함께 배포한다.
|
|
114
|
-
- **CI:** GitHub Actions에서 다음을 돌린다.
|
|
115
|
-
- Ruff 린트와 포맷 검사, pyright
|
|
116
|
-
- Python 3.11~3.15 테스트
|
|
117
|
-
- 빌드한 wheel을 개발 도구 없는 새 환경에 설치해 CLI를 실제로 돌려 보기
|
|
118
|
-
- **테스트:** 단위 테스트, Hypothesis 속성 기반 테스트, 실제 프로세스로 돌리는 e2e 테스트가 있다. 그 밖에 이런 것을 지킨다.
|
|
119
|
-
- 커밋된 baseline이 예측 파일에서 그대로 다시 나오는지
|
|
120
|
-
- 문서가 코드와 어긋나지 않는지
|
|
121
|
-
|
|
122
|
-
## AI와 함께 만든 방식
|
|
123
|
-
|
|
124
|
-
이 저장소는 Claude Code와 함께 만들었다. 역할은 [AGENTS.md](AGENTS.md)에 정해 두었다. 사람이 설계를 결정하고 리뷰하며, 에이전트는 선택지를 제시하고 구현·테스트·문서 초안을 맡는다.
|
|
125
|
-
|
|
126
|
-
- **설계 결정은 모두 사람이 했다.** 공개 API, 의존성, 파일 형식, 판정·차이·플래그 규칙, 도구 선택이 결정 대상이다. 에이전트가 선택지와 장단점을 표로 제시하고, 사람이 고르면 그 자리에서 결정 기록(ADR)을 남긴다. [결정 기록 45개](docs/decisions/README.md)는 모두 결정자가 사람이고, 사람이 한 말을 그대로 인용한다. 에이전트의 추천을 고르지 않은 결정도 그대로 적었다. 예를 들어 Ruff 규칙 세트, baseline 모델, 통계 검정을 넣지 않기로 한 것이 그렇다.
|
|
127
|
-
- **작게 나눠 검토했다.** 기능마다 순서를 지켰다.
|
|
128
|
-
1. 계획 승인
|
|
129
|
-
2. 테스트와 구현
|
|
130
|
-
3. 자가 검토 체크리스트
|
|
131
|
-
4. 사람의 diff 검토
|
|
132
|
-
5. PR, CI 통과 후 merge
|
|
133
|
-
- **기록:** AI가 함께 쓴 커밋에는 `Co-Authored-By`를 붙였다.
|
|
134
|
-
|
|
135
|
-
역할 분담, 사람이 기각한 추천, AI가 틀린 대표 사례와 그것을 잡은 방법은 [AI와 함께 개발한 방식](docs/ai-workflow.md)에 정리했다.
|
|
136
|
-
|
|
137
|
-
## 한계와 로드맵
|
|
138
|
-
|
|
139
|
-
- **실행 엔진:** SQLite만 실행한다. PostgreSQL·MySQL은 로드맵이다.
|
|
140
|
-
- **판정:** BIRD 공식 규칙 하나로만 판정한다. 행 순서와 중복까지 따지는 엄격 모드는 로드맵이다.
|
|
141
|
-
- **정규화:** SQL 구조 차이의 정규화는 최소한이다. 조건 순서, `IN`과 `EXISTS`, 서브쿼리와 JOIN처럼 뜻은 같고 모양이 다른 SQL은 다르게 본다.
|
|
142
|
-
- **카테고리 매핑:** 사용자가 정한 카테고리를 파일로 자동으로 붙이는 기능은 로드맵이다. 지금은 CSV의 `my_category` 열에 손으로 적는다.
|
|
143
|
-
- **설치:** PyPI에는 아직 배포하지 않았다. 저장소에서 설치한다.
|
|
144
|
-
|
|
145
|
-
## 라이선스
|
|
146
|
-
|
|
147
|
-
- 코드: [MIT](LICENSE)
|
|
148
|
-
- 예제 데이터 `examples/bird-mini`: [BIRD](https://bird-bench.github.io/) dev의 일부, [CC BY-SA 4.0](examples/bird-mini/LICENSE)(출처와 바꾼 점은 [SOURCE.md](examples/bird-mini/SOURCE.md))
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
|
File without changes
|
{text2sql_eval-0.1.0 → text2sql_eval-0.1.1}/src/text2sql_eval/report/templates/report.html.j2
RENAMED
|
File without changes
|
|
File without changes
|