kernelport 0.1.0__tar.gz → 0.2.0__tar.gz
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- {kernelport-0.1.0 → kernelport-0.2.0}/.github/workflows/ci.yml +21 -2
- {kernelport-0.1.0 → kernelport-0.2.0}/.gitignore +3 -0
- kernelport-0.2.0/CHANGELOG.md +56 -0
- kernelport-0.2.0/HANDOFF.md +168 -0
- kernelport-0.2.0/LAUNCH_PLAN.md +74 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/PKG-INFO +38 -7
- {kernelport-0.1.0 → kernelport-0.2.0}/PROGRESS.md +111 -5
- {kernelport-0.1.0 → kernelport-0.2.0}/README.md +37 -6
- kernelport-0.2.0/docs/demo/transcript.json +124 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/docs/how-it-works.md +21 -0
- kernelport-0.2.0/docs/img/demo.svg +140 -0
- kernelport-0.2.0/docs/index.html +60 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/docs/installation.md +3 -3
- kernelport-0.2.0/docs/web/cases.json +1 -0
- kernelport-0.2.0/docs/web/index.html +277 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/index.json +3 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/frozen/launch.json +214 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/frozen/manifest.json +9 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/frozen/reference.py +16 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/kernel.json +190 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/launch.json +214 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/metal/port.py +63 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/metal/results/apple-m1-virtual-metal.json +423 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/triton/attempts.jsonl +2 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +22 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/triton/port.py +54 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +423 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/webgpu/attempts.jsonl +4 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/webgpu/port.py +63 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/webgpu/results/apple-paravirtual-device-webgpu-metal.json +423 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/webgpu/results/llvmpipe-llvm-20-1-2-256-bits-webgpu-vulkan.json +423 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/ports/webgpu/results/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +423 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/reference.py +16 -0
- kernelport-0.2.0/examples/flash-attention-minimal/.kernelport/kernels/forward_kernel-588bfe/validation.json +423 -0
- kernelport-0.2.0/examples/flash-attention-minimal/LICENSE +201 -0
- kernelport-0.2.0/examples/flash-attention-minimal/README.md +60 -0
- kernelport-0.2.0/examples/flash-attention-minimal/flash.cu +116 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/attempts.jsonl +1 -0
- kernelport-0.2.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +22 -0
- kernelport-0.2.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/port.py +30 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +2 -2
- kernelport-0.2.0/examples/llm.c/.kernelport/pipelines/gpt2_embed_gelu_residual.json +23 -0
- kernelport-0.2.0/examples/llm.c/.kernelport/pipelines/gpt2_loss_head.json +26 -0
- kernelport-0.2.0/examples/llm.c/.kernelport/pipelines/results/gpt2_embed_gelu_residual/cuda/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +478 -0
- kernelport-0.2.0/examples/llm.c/.kernelport/pipelines/results/gpt2_embed_gelu_residual/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +75 -0
- kernelport-0.2.0/examples/llm.c/.kernelport/pipelines/results/gpt2_embed_gelu_residual/triton/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +478 -0
- kernelport-0.2.0/examples/llm.c/.kernelport/pipelines/results/gpt2_loss_head/cuda/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +602 -0
- kernelport-0.2.0/examples/llm.c/.kernelport/pipelines/results/gpt2_loss_head/triton/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +602 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/README.md +45 -1
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/__init__.py +1 -1
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/analyzer/cuda_parser.py +152 -12
- kernelport-0.2.0/kernelport/analyzer/hazards.py +423 -0
- kernelport-0.2.0/kernelport/analyzer/macros.py +238 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/analyzer/models.py +5 -1
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/webgpu/runner.py +150 -2
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/cli.py +98 -9
- kernelport-0.2.0/kernelport/harness/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/compare.py +5 -3
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/device_source.py +52 -8
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/inputs.py +4 -0
- kernelport-0.2.0/kernelport/harness/pipeline.py +536 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/mcp_server.py +15 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/report/data.py +49 -2
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/report/html.py +67 -11
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/report/markdown.py +38 -8
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/tools.py +220 -6
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/workspace.py +90 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/notebooks/freeze_references_colab.ipynb +81 -5
- {kernelport-0.1.0 → kernelport-0.2.0}/pyproject.toml +4 -1
- kernelport-0.2.0/scripts/build_web_demo.py +148 -0
- kernelport-0.2.0/scripts/check_web_demo.py +88 -0
- kernelport-0.2.0/scripts/record_demo.py +237 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/skills/kernelport/SKILL.md +59 -1
- {kernelport-0.1.0 → kernelport-0.2.0}/skills/kernelport/backends/metal.md +2 -1
- {kernelport-0.1.0 → kernelport-0.2.0}/skills/kernelport/backends/webgpu.md +10 -3
- {kernelport-0.1.0 → kernelport-0.2.0}/skills/kernelport/common_bugs.md +2 -0
- kernelport-0.2.0/tests/bad_ports/crossentropy_clamped.py +25 -0
- kernelport-0.2.0/tests/fixtures/macro_kernels/kernels.cu +44 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_agent.py +1 -1
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_cpu_backend.py +2 -1
- kernelport-0.2.0/tests/test_hazards.py +285 -0
- kernelport-0.2.0/tests/test_macros.py +127 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_mcp_protocol.py +2 -1
- kernelport-0.2.0/tests/test_pipeline.py +312 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_report.py +26 -2
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_tools.py +16 -0
- kernelport-0.2.0/tests/test_web_demo.py +48 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_webgpu_backend.py +72 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/softmax/ports/webgpu.py +1 -1
- kernelport-0.1.0/LAUNCH_PLAN.md +0 -118
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -12
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/port.py +0 -29
- {kernelport-0.1.0 → kernelport-0.2.0}/.gitattributes +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/.github/workflows/release.yml +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/LICENSE +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/RELEASING.md +0 -0
- /kernelport-0.1.0/kernelport/analyzer/__init__.py → /kernelport-0.2.0/docs/.nojekyll +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/docs/img/llmc-status.svg +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/index.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/ports/triton/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/ports/triton/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/ports/triton/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/ports/triton/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/ports/triton/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/ports/triton/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/ports/triton/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/ports/triton/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel1-1864a1/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel2-8ee6db/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/metal/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/metal/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/metal/results/apple-m1-virtual-metal.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/tune/tune.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel1-ba054e/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/metal/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/metal/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/metal/results/apple-m1-virtual-metal.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/triton/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/triton/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel1-4d2ec2/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/metal/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/metal/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/metal/results/apple-m1-virtual-metal.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/triton/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/triton/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/bench/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/results/apple-paravirtual-device-webgpu-metal.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/results/llvmpipe-llvm-20-1-2-256-bits-webgpu-vulkan.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/results/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel4-d55f38/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel5-4b05bb/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel6-137835/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/mean_kernel-e0b51b/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/normalization_kernel-4c4090/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/metal/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/metal/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/metal/results/apple-m1-virtual-metal.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/triton/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/triton/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/residual_forward_kernel2-3e3587/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/rstd_kernel-30478b/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_kernel1-2619de/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_kernel2-1cd536/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_kernel3-fc6e41/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_kernel4-c8e3ac/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_kernel7-4d52ba/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel1-ce266a/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel2-3de0c7/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/frozen/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/frozen/manifest.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/frozen/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/kernel.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/metal/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/metal/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/metal/results/apple-m1-virtual-metal.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/triton/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/triton/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/attempts.jsonl +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/bench/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/port.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/results/apple-paravirtual-device-webgpu-metal.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/results/llvmpipe-llvm-20-1-2-256-bits-webgpu-vulkan.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/results/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/validation.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/LICENSE +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/adamw.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/common.h +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/crossentropy_forward.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/crossentropy_softmax_backward.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/encoder_forward.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/gelu_forward.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/layernorm_forward.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/residual_forward.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/examples/llm.c/dev/cuda/softmax_forward.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/__main__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/agent.py +0 -0
- {kernelport-0.1.0/kernelport/bench → kernelport-0.2.0/kernelport/analyzer}/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/analyzer/suggest.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/base.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/cpu/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/cpu/capability.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/cpu/config.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/cpu/runner.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/hip/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/hip/capability.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/hip/config.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/hip/runner.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/metal/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/metal/capability.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/metal/config.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/metal/runner.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/triton/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/triton/capability.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/triton/config.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/triton/runner.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/webgpu/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/webgpu/capability.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/backends/webgpu/config.py +0 -0
- {kernelport-0.1.0/kernelport/harness → kernelport-0.2.0/kernelport/bench}/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/bench/timer.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/doctor.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/hardware.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/expr.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/results.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/run_cuda.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/spec.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/tolerances.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/harness/verify.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/hashing.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/report/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/setup_agents/__init__.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/setup_agents/backup.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/setup_agents/detect.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/setup_agents/register.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/setup_agents/skills_install.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/tune.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/kernelport/zoo.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/scripts/amd_check.sh +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/scripts/check_env.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/scripts/render_status_svg.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/skills/kernelport/backends/cpu.md +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/skills/kernelport/backends/hip.md +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/skills/kernelport/backends/triton.md +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/cpu/cumsum_exclusive.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/cpu/layernorm_unbiased.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/cpu/reduce_sum_overwrites.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/cpu/relu_rebinds_output.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/cpu/relu_returns_array.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/cpu/vector_add_missing_tail.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/matmul_tf32.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/relu_leaky.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/softmax_first_chunk_sum.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/softmax_no_max.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/vector_add_compile_error.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/vector_add_missing_tail.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/vector_add_noop.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/vector_add_sub.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/vector_add_tiny_error.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/webgpu/reduce_sum_racy_add.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/webgpu/relu_wrong_name.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/webgpu/vector_add_grid_too_big.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/bad_ports/webgpu/vector_add_no_stride.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/conftest.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/fixtures/embedded_kernel.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/fixtures/host_mixed/helpers.cuh +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/fixtures/host_mixed/kernels.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/fixtures/tricky.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_analyzer.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_backends.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_compare.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_device_source.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_doctor.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_expr.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_harness_gpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_hip_backend.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_inputs.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_metal_backend.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_results.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_setup.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_skills.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_spec.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_tune.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_workspace.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/tests/test_zoo_originals.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/cumsum/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/cumsum/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/cumsum/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/cumsum/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/cumsum/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/cumsum/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/cumsum/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/cumsum/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/embedding_gather/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/embedding_gather/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/embedding_gather/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/embedding_gather/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/embedding_gather/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/embedding_gather/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/embedding_gather/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/embedding_gather/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/layernorm/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/layernorm/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/layernorm/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/layernorm/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/layernorm/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/layernorm/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/layernorm/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/layernorm/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/matmul_naive/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/matmul_naive/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/matmul_naive/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/matmul_naive/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/matmul_naive/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/matmul_naive/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/matmul_naive/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/matmul_naive/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/reduce_sum/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/reduce_sum/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/reduce_sum/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/reduce_sum/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/reduce_sum/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/reduce_sum/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/reduce_sum/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/reduce_sum/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/relu/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/relu/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/relu/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/relu/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/relu/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/relu/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/relu/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/relu/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rmsnorm/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rmsnorm/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rmsnorm/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rmsnorm/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rmsnorm/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rmsnorm/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rmsnorm/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rmsnorm/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rope/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rope/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rope/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rope/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rope/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rope/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rope/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/rope/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/saxpy/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/saxpy/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/saxpy/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/saxpy/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/saxpy/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/saxpy/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/saxpy/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/saxpy/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/softmax/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/softmax/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/softmax/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/softmax/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/softmax/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/softmax/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/softmax/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/transpose/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/transpose/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/transpose/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/transpose/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/transpose/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/transpose/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/transpose/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/transpose/reference.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/vector_add/kernel.cu +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/vector_add/launch.json +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/vector_add/ports/cpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/vector_add/ports/hip.hip +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/vector_add/ports/metal.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/vector_add/ports/triton.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/vector_add/ports/webgpu.py +0 -0
- {kernelport-0.1.0 → kernelport-0.2.0}/zoo/vector_add/reference.py +0 -0
|
@@ -62,13 +62,22 @@ jobs:
|
|
|
62
62
|
run: kernelport zoo --backend metal --no-bench
|
|
63
63
|
- name: llm.c example (Metal ports vs references frozen on NVIDIA)
|
|
64
64
|
working-directory: examples/llm.c
|
|
65
|
+
run: |
|
|
66
|
+
kernelport verify --backend metal
|
|
67
|
+
kernelport pipeline gpt2_embed_gelu_residual --backend metal
|
|
68
|
+
kernelport status
|
|
69
|
+
- name: flash-attention-minimal example (Metal port vs reference frozen on NVIDIA)
|
|
70
|
+
working-directory: examples/flash-attention-minimal
|
|
65
71
|
run: |
|
|
66
72
|
kernelport verify --backend metal
|
|
67
73
|
kernelport status
|
|
68
74
|
- uses: actions/upload-artifact@v4
|
|
69
75
|
with:
|
|
70
76
|
name: llmc-results-metal
|
|
71
|
-
path:
|
|
77
|
+
path: |
|
|
78
|
+
examples/llm.c/.kernelport/kernels/*/ports/metal/results/*.json
|
|
79
|
+
examples/llm.c/.kernelport/pipelines/results/*/metal/*.json
|
|
80
|
+
examples/flash-attention-minimal/.kernelport/kernels/*/ports/metal/results/*.json
|
|
72
81
|
|
|
73
82
|
webgpu:
|
|
74
83
|
# WGSL ports through wgpu-native: Mesa llvmpipe (software Vulkan) on Linux, Metal on macOS.
|
|
@@ -99,15 +108,25 @@ jobs:
|
|
|
99
108
|
run: python -m pytest -q -rs tests/test_webgpu_backend.py
|
|
100
109
|
- name: WebGPU zoo
|
|
101
110
|
run: kernelport zoo --backend webgpu --no-bench
|
|
111
|
+
- name: Browser check (docs/web in headless Chrome; Tint, not naga, compiles the WGSL)
|
|
112
|
+
# Chrome's adapter: SwiftShader on Linux, the Apple GPU on macOS
|
|
113
|
+
run: python scripts/check_web_demo.py --timeout 240
|
|
102
114
|
- name: llm.c example (WGSL ports vs references frozen on NVIDIA)
|
|
103
115
|
working-directory: examples/llm.c
|
|
104
116
|
run: |
|
|
105
117
|
kernelport verify --backend webgpu
|
|
106
118
|
kernelport status
|
|
119
|
+
- name: flash-attention-minimal example (WGSL port vs reference frozen on NVIDIA)
|
|
120
|
+
working-directory: examples/flash-attention-minimal
|
|
121
|
+
run: |
|
|
122
|
+
kernelport verify --backend webgpu
|
|
123
|
+
kernelport status
|
|
107
124
|
- uses: actions/upload-artifact@v4
|
|
108
125
|
with:
|
|
109
126
|
name: llmc-results-webgpu-${{ matrix.os }}
|
|
110
|
-
path:
|
|
127
|
+
path: |
|
|
128
|
+
examples/llm.c/.kernelport/kernels/*/ports/webgpu/results/*.json
|
|
129
|
+
examples/flash-attention-minimal/.kernelport/kernels/*/ports/webgpu/results/*.json
|
|
111
130
|
|
|
112
131
|
package:
|
|
113
132
|
name: build sdist + wheel
|
|
@@ -0,0 +1,56 @@
|
|
|
1
|
+
# Changelog
|
|
2
|
+
|
|
3
|
+
## 0.2.0 (2026-11-02)
|
|
4
|
+
|
|
5
|
+
**Multi-kernel pipelines**
|
|
6
|
+
- Run ported kernels in a chain and check every stage on the data it really gets
|
|
7
|
+
(`kernelport pipeline`, MCP tools `write_pipeline` and `verify_pipeline`).
|
|
8
|
+
- Time the chain of ports against the chain of original CUDA kernels, whole and per stage
|
|
9
|
+
(`kernelport pipeline <name> --bench`, MCP tool `bench_pipeline`). A stage is called slower only if
|
|
10
|
+
it loses every one of 5 rounds.
|
|
11
|
+
- Pipelines show up in `kernelport status` and the HTML/Markdown reports.
|
|
12
|
+
|
|
13
|
+
**New static checks** (warnings from `scan_kernels`, the hazards that pass runtime tests on today's
|
|
14
|
+
NVIDIA GPUs and break elsewhere)
|
|
15
|
+
- A lane can exit before a full-mask warp shuffle (`__shfl_*_sync(0xffffffff, ...)`). This flags the
|
|
16
|
+
two softmax kernels fixed upstream in karpathy/llm.c#867.
|
|
17
|
+
- Some threads can miss a `__syncthreads()`: a thread-dependent early return before it, or the
|
|
18
|
+
barrier inside a branch or loop that differs between threads.
|
|
19
|
+
|
|
20
|
+
**WebGPU**
|
|
21
|
+
- The runner refuses WGSL that wgpu-native accepts but browsers reject or run differently: a
|
|
22
|
+
non-uniform `workgroupBarrier()`, float literals beyond `f32` range, and a `var` without initializer
|
|
23
|
+
inside a loop (wgpu-native 29 zeroes it once instead of every iteration).
|
|
24
|
+
- In-browser check (`docs/web`): runs 15 WGSL ports (the 12 zoo kernels, two llm.c kernels and the
|
|
25
|
+
FlashAttention forward pass) on the viewer's GPU against kernelport's own cases and tolerances,
|
|
26
|
+
float32 and float16. CI runs it in headless Chrome. `docs/index.html` is a landing page for
|
|
27
|
+
GitHub Pages.
|
|
28
|
+
- The Colab notebook has a self-test section that runs the zoo and the llm.c example on the T4.
|
|
29
|
+
- `shader-f16` support is checked when a shader runs, not when binding text is generated.
|
|
30
|
+
|
|
31
|
+
**Analyzer**
|
|
32
|
+
- Kernels defined through macros (`#define KERNEL __global__`, `FOR_TYPES(DEFINE_X)`, `C_KERNEL(name)`)
|
|
33
|
+
are found, with a small cpp-style macro expander.
|
|
34
|
+
- Survives braces opened separately in each `#if` branch.
|
|
35
|
+
|
|
36
|
+
**Examples**
|
|
37
|
+
- `examples/flash-attention-minimal`: the unmodified `flash.cu` ported to Triton (23x the original),
|
|
38
|
+
Metal and WGSL, all PASS.
|
|
39
|
+
- `examples/llm.c`: two pipelines (GPT-2 loss head; bf16 encoder, GELU, residual).
|
|
40
|
+
|
|
41
|
+
**CLI and reports**
|
|
42
|
+
- `kernelport verify softmax` and `bench softmax` take the kernel id as an argument; unknown ids are
|
|
43
|
+
usage errors.
|
|
44
|
+
- Reports lead with a headline (kernels verified, PASS results, hardware targets) and each PASS cell
|
|
45
|
+
shows the hardware and speedup.
|
|
46
|
+
- The README has an animated recording of a real session (`scripts/record_demo.py`).
|
|
47
|
+
|
|
48
|
+
**Fixes**
|
|
49
|
+
- Benchmarks of very short kernels no longer flag noise as a slowdown.
|
|
50
|
+
- WebGPU tests: a deliberately racy port may pass on a CPU adapter, so that case is skipped there
|
|
51
|
+
instead of failing.
|
|
52
|
+
|
|
53
|
+
## 0.1.0 (2026-10-14)
|
|
54
|
+
|
|
55
|
+
First release: MCP server, agent skill and CLI; Triton, Metal, WebGPU and CPU backends verified,
|
|
56
|
+
HIP written but not run on AMD hardware; 12-kernel zoo; the llm.c example.
|
|
@@ -0,0 +1,168 @@
|
|
|
1
|
+
# kernelport: handoff notes
|
|
2
|
+
|
|
3
|
+
*Last updated 2026-11-02. Read this first when resuming. Deeper detail: [PROGRESS.md](PROGRESS.md)
|
|
4
|
+
(full technical history), [LAUNCH_PLAN.md](LAUNCH_PLAN.md) (launch strategy), [RELEASING.md](RELEASING.md)
|
|
5
|
+
(publishing).*
|
|
6
|
+
|
|
7
|
+
## Where things stand
|
|
8
|
+
|
|
9
|
+
kernelport 0.1.0 is on [PyPI](https://pypi.org/project/kernelport/), and the llm.c bug it found is
|
|
10
|
+
fixed upstream in an open PR, [karpathy/llm.c#867](https://github.com/karpathy/llm.c/pull/867).
|
|
11
|
+
CI is green on Linux, Windows, macOS, Apple Silicon (Metal), two WebGPU adapters and headless Chrome
|
|
12
|
+
(the in-browser check). HIP (AMD) is the only backend never run on its real hardware.
|
|
13
|
+
|
|
14
|
+
| Measure | Estimate | What's missing |
|
|
15
|
+
|---|---|---|
|
|
16
|
+
| Public v0.1 (installable, works, honest about status) | ~95% | AMD verification |
|
|
17
|
+
| Ready to launch publicly | ~85% | Agent demo video, GitHub Pages switched on, a first Linux + NVIDIA run, launch posts |
|
|
18
|
+
| Mature product | ~75% | More agents tested, AMD, pipeline timing |
|
|
19
|
+
|
|
20
|
+
## What is verified
|
|
21
|
+
|
|
22
|
+
| Backend | Status | Evidence |
|
|
23
|
+
|---|---|---|
|
|
24
|
+
| Triton | Working | 12/12 zoo + 9/9 llm.c ports pass on RTX 5060 (Windows); 1.0-1.3x the original CUDA, matmul 6.2x |
|
|
25
|
+
| Metal (MLX) | Working | 12/12 zoo + 5/5 llm.c + flash-attention ports pass on Apple M1, checked by CI on every push |
|
|
26
|
+
| WebGPU (WGSL) | Working | 12/12 zoo pass on NVIDIA (Vulkan), Apple (Metal) and llvmpipe; 2/2 llm.c fp32 ports + flash-attention pass on all three; in browsers 24/24 (fp32 + fp16) on RTX 5060 + Intel UHD (Edge), and in Chrome on SwiftShader + Apple (CI) |
|
|
27
|
+
| CPU (Numba) | Working | 12/12 zoo pass (fp32) |
|
|
28
|
+
| HIP (AMD) | Unverified | Ports written; `scripts/amd_check.sh` ready to run on an AMD machine |
|
|
29
|
+
|
|
30
|
+
- **Real code:** `examples/llm.c` has 9 kernels from unmodified llm.c files (host code, cuBLAS headers,
|
|
31
|
+
`Packed128` templates), 20 PASS results across 5 hardware targets.
|
|
32
|
+
- **Fresh-agent test:** a coding agent with no context ported 4 new llm.c kernels; all 4 passed on the
|
|
33
|
+
first verification, and its feedback was fixed.
|
|
34
|
+
- **Install:** a clean `pip install kernelport` from PyPI was checked.
|
|
35
|
+
|
|
36
|
+
## What was done on 2026-10-14
|
|
37
|
+
|
|
38
|
+
| Area | Change |
|
|
39
|
+
|---|---|
|
|
40
|
+
| Release | 0.1.0 published to PyPI via tag-triggered `release.yml` with trusted publishing; install docs use `pip install kernelport`; `main` is 0.1.1.dev0 |
|
|
41
|
+
| CI | Tests on Linux, Windows, macOS; Metal zoo + llm.c on GitHub's Apple M1 runner; WebGPU on llvmpipe and Apple Metal; wheel build check |
|
|
42
|
+
| Real code | Host-code slicer (`kernelport/harness/device_source.py`) compiles real .cu files (main(), cuBLAS, stdio) with NVRTC; `examples/llm.c` with 9 kernels |
|
|
43
|
+
| llm.c bug | `softmax_forward_online_kernel8` leaves rows unwritten when C < block size; fix tested 90/90, posted by the owner as PR #867 from fork PS12007/llm.c |
|
|
44
|
+
| Fresh-agent test | 4/4 first-try passes; fixes from its feedback: float scalars rounded to their dtype, guide gaps, Windows console crash, clearer tune/bench output |
|
|
45
|
+
| Tuning | New `tune_port` tool (12th tool): verifies every variant, keeps only clear, noise-resistant wins |
|
|
46
|
+
| Benchmarks | Timer no longer measures Python launch overhead; 3 alternating runs with ranges and a noise warning |
|
|
47
|
+
| No NVIDIA locally | `kernelport validate --all` + Colab notebook to freeze references once on a free GPU |
|
|
48
|
+
| Device limits | Cases too big for an adapter are reported as not tested instead of failing the port |
|
|
49
|
+
| Robustness | Line-ending-insensitive hashes; LF workspace files; readable status table when piped |
|
|
50
|
+
|
|
51
|
+
## What was done on 2026-10-15
|
|
52
|
+
|
|
53
|
+
| Area | Change |
|
|
54
|
+
|---|---|
|
|
55
|
+
| Macro-defined kernels | `kernelport/analyzer/macros.py`, a small cpp-style expander (`#`, `##`, variadics, `FOR_TYPES(DEFINE_X)`). The analyzer finds kernels stamped out by macros, marked by `#define KERNEL __global__`, or opened by `C_KERNEL(name)(...)`, and records `generated_by`. The NVRTC slicer treats top-level macro calls as items of their own (kept if device code, blanked if host only). Tests: `tests/test_macros.py`, including a GPU validation of a macro-generated kernel |
|
|
56
|
+
| README demo | `scripts/record_demo.py` records a real CLI session (scan, validate, a broken softmax port FAILs, the fix PASSes, bench, status) and renders `docs/img/demo.svg`, an animated terminal, now at the top of the README. `record` needs CUDA + Triton; `render` re-draws from `docs/demo/transcript.json` |
|
|
57
|
+
| CLI | `kernelport verify softmax` / `bench softmax` take the kernel id as an argument; unknown ids are usage errors; piped output honours `$COLUMNS`; "found 1 kernel" |
|
|
58
|
+
| Report | Headline sentence, readable dark-mode links, PASS cells show hardware + speedup, unstarted kernels folded away; Markdown matches |
|
|
59
|
+
| Browser check | `docs/web/index.html` runs the 12 WGSL ports in the browser's WebGPU against kernelport's own cases (`scripts/build_web_demo.py`, 57 float32 cases, 2.1 MB); 12/12 PASS in Edge on the RTX 5060 and the Intel UHD iGPU; a sabotaged port FAILs. `scripts/check_web_demo.py` runs it headless |
|
|
60
|
+
| Browser bug found | zoo softmax WGSL used `-3.4028235e38` (above FLT_MAX): naga accepts, Chrome/Edge reject. Port and the webgpu skill guide fixed; the runner now refuses out-of-range float literals |
|
|
61
|
+
| FlashAttention example | `examples/flash-attention-minimal`: unmodified `flash.cu` (Apache-2.0), reference validated 6/6 within N <= 384 (beyond that the original's own `__expf`/fp32 rounding exceeds the fixed tolerance; documented, not loosened). Triton PASS at 23x, WGSL PASS on RTX 5060 / Apple / llvmpipe, Metal PASS on M1 (CI results committed). New init `{"dist": "full", "value": "-inf"}` |
|
|
62
|
+
| wgpu-native bug found | A `var` declared without initializer in a loop is zeroed once, not per iteration (WGSL spec, browsers), on every backend. Already fixed upstream in naga (gfx-rs/wgpu#9592, v30), but wgpu-native has no v30 release yet and wgpu-py 0.32 bundles 29.0.1.1. The runner refuses such code. Issue drafted (not posted) in `drafts/` (gitignored) |
|
|
63
|
+
| Browser CI | `scripts/check_web_demo.py` runs in CI's WebGPU jobs: Chrome on SwiftShader (Linux) and Apple GPU (macOS), 12/12 |
|
|
64
|
+
| Failure report | "unexpected NaN" hint also names overflow (inf/inf), not only unwritten elements |
|
|
65
|
+
| CI | Flaky WebGPU test fixed: the racy reduce_sum bad port can PASS on llvmpipe (workgroups run one by one), so it is skipped there; earlier red runs on 2026-10-14 were this flake |
|
|
66
|
+
|
|
67
|
+
## What was done on 2026-10-17
|
|
68
|
+
|
|
69
|
+
| Area | Change |
|
|
70
|
+
|---|---|
|
|
71
|
+
| Pipelines | Kernels run in a chain over named buffers (`.kernelport/pipelines/<name>.json`); every stage's port is checked against its frozen reference on the data the stage before really wrote. End-to-end drift vs a float64 chain is reported, never decides. Tools `write_pipeline` / `verify_pipeline` (14 tools), CLI `kernelport pipeline`, rows in `status` and both reports (stale results shown as UNVERIFIED). Backend `cuda` chains the originals |
|
|
72
|
+
| llm.c pipelines | `gpt2_loss_head` (softmax -> crossentropy -> backward) and `gpt2_embed_gelu_residual` (bf16): PASS on Triton and the originals; CI runs the bf16 one on Metal |
|
|
73
|
+
| Why it matters | A crossentropy port that clamps probs to >= 1e-3 passes its own cases and fails the pipeline (test). Drift shows fp32 softmax underflow (inf losses) and bf16 error growth (1.5x a tolerance after 3 kernels, same in the originals) |
|
|
74
|
+
|
|
75
|
+
## What was done on 2026-10-24
|
|
76
|
+
|
|
77
|
+
| Area | Change |
|
|
78
|
+
|---|---|
|
|
79
|
+
| llm.c PR #867 | A reviewer found the same early-return bug in `softmax_forward_kernel7`. Fixed on the PR branch (only whole warps exit; same speed), tested 504/504 configs on the RTX 5060. The unfixed kernel also passes there: undefined behaviour that happens to work, so only a static check can catch it. The PR's first commit had turned the file into CRLF (all 733 lines in the diff); restored to LF. **Committed in `C:\-CS\llm.c-fork`, not pushed** |
|
|
80
|
+
| Static warnings | `kernelport/analyzer/hazards.py`: a lane can return early before a full-mask warp shuffle/reduce. Shown by `scan` and `read_kernel`; the skill tells agents to test warp-splitting sizes. Flags exactly kernel7 + kernel8 in llm.c; 1 of 152 llama.cpp kernels |
|
|
81
|
+
| Analyzer crash | A kernel opening a brace in each `#if` branch (llama.cpp `mmf.cuh`) crashed the whole scan; fixed |
|
|
82
|
+
|
|
83
|
+
## What was done on 2026-10-27
|
|
84
|
+
|
|
85
|
+
| Area | Change |
|
|
86
|
+
|---|---|
|
|
87
|
+
| Pipeline timing | New `bench_pipeline` tool (15 tools) and `kernelport pipeline <name> --bench`: after a PASS, the chain is run once to capture each stage's real input, then the whole chain of ports and each stage are timed against the original CUDA kernels on those inputs (3 alternating rounds). Saved under `.kernelport/pipelines/results/<name>/<backend>/bench/` |
|
|
88
|
+
| First numbers (RTX 5060, Triton) | `gpt2_loss_head` at B=4, T=64, V=50257: chain 1.00 ms vs 1.33 ms original (1.33x; softmax 1.68x, the two cross-entropy kernels ~0.97x). `gpt2_embed_gelu_residual` (bf16, 4x256x768, ~10 µs kernels): about even (1.0-1.4x between runs) |
|
|
89
|
+
| Timing noise | A first run flagged a "slow" stage that moved between stages on reruns: single rounds of ~10 µs kernels spike up to 3x on this laptop. `bench_pipeline` now uses 5 rounds and names a stage slower only if every port round lost to every original round (as `tune_port` does) |
|
|
90
|
+
| Encoder port | `encoder_forward_kernel3` Triton port rewritten row-wise (one program per token and block of C: one token-id load, no per-element divide): 0.023 vs 0.025 ms for the old port, steady across runs; re-verified 4/4 and the bf16 pipeline PASS |
|
|
91
|
+
| PR #867 reply | Reply to the kernel7 reviewer drafted in `drafts/llm-c-867-kernel7-reply.md` (local, gitignored), with the push steps. Still not pushed or posted |
|
|
92
|
+
|
|
93
|
+
## What was done on 2026-10-28
|
|
94
|
+
|
|
95
|
+
| Area | Change |
|
|
96
|
+
|---|---|
|
|
97
|
+
| Barrier warnings | `analyzer/hazards.py` also warns when some threads can miss a `__syncthreads()` (or `block.sync()`, or a `blockReduce` helper): a thread-dependent early return before it, or the barrier inside a branch or loop that differs between threads. Over 340 kernels: 4 loop cases in llm.c (threads can hit the barrier a different number of times), 3 + 4 deliberate early returns in llm.c / llama.cpp (fine on NVIDIA, worded as a porting note), 0 in the zoo. Two llama.cpp false-positive patterns fixed and tested |
|
|
98
|
+
| WGSL gap found | wgpu-native (naga, wgpu 0.32) accepts a `workgroupBarrier()` that browsers reject as non-uniform (checked in Edge). A port could PASS in kernelport and not compile in Chrome. The runner now refuses it with a fix hint; it agrees with Edge on 6 probe shaders and accepts all 15 existing WGSL ports |
|
|
99
|
+
| Skill | SKILL.md, webgpu.md and metal.md: keep every thread alive to each barrier in ports, guard the work instead |
|
|
100
|
+
|
|
101
|
+
## Next steps (owner)
|
|
102
|
+
|
|
103
|
+
None of these need API credits.
|
|
104
|
+
|
|
105
|
+
- [ ] **AMD:** join AMD's AI Developer Program for free Developer Cloud credits, start an MI300X with the
|
|
106
|
+
ROCm image, run `bash scripts/amd_check.sh`, send back `amd_results.txt`.
|
|
107
|
+
- [ ] **Colab:** open `notebooks/freeze_references_colab.ipynb` in Colab (T4 runtime) and run the
|
|
108
|
+
cells under "Self-test" only (skip the "Your repo" cells). It runs the zoo originals + Triton
|
|
109
|
+
ports and the llm.c example, the first Linux + NVIDIA run, and downloads `selftest_results.txt`.
|
|
110
|
+
- [ ] **Demo video/GIF (30-60 s):** one prompt to the agent, FAIL → fix → PASS, the green status
|
|
111
|
+
table. The biggest launch lever. Step-by-step recording plan in `drafts/demo-video-plan.md`.
|
|
112
|
+
- [ ] **Browser check online:** GitHub repo Settings → Pages → Source "Deploy from a branch" → `main`,
|
|
113
|
+
folder `/docs` → Save. (Claude can't do this: creating a public site is blocked for it.) Then
|
|
114
|
+
https://ps12007.github.io/kernelport/ is a landing page and `/web/` the browser check (15 ports,
|
|
115
|
+
27/27 PASS in Edge on the RTX 5060). `docs/.nojekyll` is already there.
|
|
116
|
+
- [ ] **Launch posts, same day:** Show HN, r/LocalLLaMA, r/MachineLearning, X. Drafts with a
|
|
117
|
+
pre-post checklist in `drafts/launch-posts.md` (local, gitignored).
|
|
118
|
+
- [x] **PR #867:** kernel7 fix + line-ending restore pushed and the reply posted (2026-11-02); the PR
|
|
119
|
+
diff is now 1 file, +8 / -8. Keep watching for review comments.
|
|
120
|
+
- [ ] **wgpu loop-var bug (optional):** drafts are ready, not posted, in `drafts/` (local only,
|
|
121
|
+
gitignored): an issue for pygfx/wgpu-py (`wgpu-loop-var-issue.md`, with
|
|
122
|
+
`wgpu-loop-var-repro.py`) and a short comment for gfx-rs/wgpu-native PR #630. Already fixed in
|
|
123
|
+
naga v30 (gfx-rs/wgpu#9592); wgpu-native has no v30 release yet (re-checked 2026-11-02: latest is
|
|
124
|
+
still v29.0.1.1, #630 still open). Re-check both before posting.
|
|
125
|
+
- [ ] **Release 0.2.0:** version bumped and CHANGELOG.md written (2026-11-02); push the `v0.2.0` tag
|
|
126
|
+
(RELEASING.md) if it isn't on PyPI yet.
|
|
127
|
+
- [ ] Optional: try Codex, Cursor or Gemini CLI with `kernelport setup`.
|
|
128
|
+
|
|
129
|
+
Future releases: bump the version in `pyproject.toml` and `kernelport/__init__.py`, then push a
|
|
130
|
+
`vX.Y.Z` tag (see RELEASING.md).
|
|
131
|
+
|
|
132
|
+
## Ideas to make it better
|
|
133
|
+
|
|
134
|
+
- **Pipelines, more:** a pipeline in the browser check; a chain with a matmul; why the original encoder's time doubles between sessions.
|
|
135
|
+
- **More real projects:** a cuBLAS-heavy repo, or flash-attention's backward pass (forward is done).
|
|
136
|
+
- **Linux GPU checks:** free CI runners have no GPU; a Colab or Kaggle run per release would cover Linux + NVIDIA.
|
|
137
|
+
- **Browser check, more:** let visitors paste a WGSL port; larger cases as an optional download.
|
|
138
|
+
- **Real Mac timings:** CI's virtual M1 proves correctness but gives no fair speed numbers.
|
|
139
|
+
- **When wgpu-native ships v30:** the loop-var check can stay (harmless); note the fixed version in the message.
|
|
140
|
+
|
|
141
|
+
Done 2026-10-15 from this list: macro-defined kernels, report polish, browser demo page, FlashAttention example.
|
|
142
|
+
Done 2026-10-17: multi-kernel pipelines. Done 2026-10-27: pipeline timing.
|
|
143
|
+
Done 2026-11-02: llm.c + FlashAttention WGSL ports in the browser check.
|
|
144
|
+
|
|
145
|
+
**Handy here:** headless Edge runs WebGPU on this laptop (`scripts/check_web_demo.py`; `--discrete` for
|
|
146
|
+
the RTX 5060) and takes screenshots for checking pages (`msedge --headless=new --screenshot=...`).
|
|
147
|
+
`scripts/record_demo.py` re-records the README terminal demo.
|
|
148
|
+
|
|
149
|
+
## How to resume
|
|
150
|
+
|
|
151
|
+
Open Claude Code in `C:\-CS\CUDAtoanything` and say "keep working on kernelport".
|
|
152
|
+
|
|
153
|
+
| What | Where |
|
|
154
|
+
|---|---|
|
|
155
|
+
| Repo | https://github.com/PS12007/kernelport |
|
|
156
|
+
| Package | https://pypi.org/project/kernelport/ |
|
|
157
|
+
| CI runs | https://github.com/PS12007/kernelport/actions |
|
|
158
|
+
| llm.c PR | https://github.com/karpathy/llm.c/pull/867 (branch `fix-softmax-online-kernel8-small-c` on PS12007/llm.c; local clone `C:\-CS\llm.c-fork`, `core.autocrlf=false`) |
|
|
159
|
+
| Environment | `.venv` (Python 3.12, torch 2.11 cu128, triton-windows 3.7, cupy 14.2); run tools as `.venv\Scripts\python.exe` / `.venv\Scripts\kernelport.exe` |
|
|
160
|
+
| Tests | `.venv\Scripts\python.exe -m pytest -q` (~6-8 min; 332 pass, 43 skip for hardware not on this machine; with `wgpu` installed the WebGPU tests run too) |
|
|
161
|
+
|
|
162
|
+
## Rules to keep
|
|
163
|
+
|
|
164
|
+
- No large downloads; test installs (e.g. `wgpu`) are removed afterwards.
|
|
165
|
+
- No API credits, ever (owner's choice; nothing requires them).
|
|
166
|
+
- Edits to the real agent config (`~/.claude.json`) are reverted after testing.
|
|
167
|
+
- Nothing is posted publicly (issues, PRs, tags, releases) without the owner's go-ahead.
|
|
168
|
+
- On this Windows box, write code with the editor tools, not shell heredocs (they mangle backslashes and backticks).
|
|
@@ -0,0 +1,74 @@
|
|
|
1
|
+
# kernelport: status and launch plan
|
|
2
|
+
|
|
3
|
+
*Updated 2026-10-15. kernelport 0.1.0 on PyPI; see HANDOFF.md for the latest one-page status. Technical history: [PROGRESS.md](PROGRESS.md).*
|
|
4
|
+
|
|
5
|
+
## Where we are
|
|
6
|
+
|
|
7
|
+
| Measure | Estimate | Why |
|
|
8
|
+
|---|---|---|
|
|
9
|
+
| Public v0.1 (usable, installable, honest) | **~95%** | Released to PyPI, CI green on 3 OSes + Apple Silicon + 2 WebGPU adapters, real-code example, fresh-agent test passed. Missing: AMD verification. |
|
|
10
|
+
| Launch-ready (could be posted for attention) | **~80%** | Missing: a demo video/GIF, a first run on Linux + NVIDIA (only Windows + NVIDIA so far), launch posts. |
|
|
11
|
+
| Mature product | **~60%** | Lexical analyzer (no C++ front end), single-kernel focus, no multi-kernel pipelines, HIP unverified, only one agent (Claude) tested. |
|
|
12
|
+
|
|
13
|
+
### Backend status
|
|
14
|
+
|
|
15
|
+
| Backend | Status | Evidence |
|
|
16
|
+
|---|---|---|
|
|
17
|
+
| Triton | working | 12/12 zoo + 9/9 llm.c ports PASS on RTX 5060 (Windows); 1.0-1.3x the original CUDA on the zoo, matmul 6.2x |
|
|
18
|
+
| Metal (MLX) | working | 12/12 zoo + 5/5 llm.c ports PASS on Apple M1 in CI, every push |
|
|
19
|
+
| WebGPU (WGSL) | working | 12/12 zoo PASS on NVIDIA (Vulkan), Apple (Metal) and llvmpipe (CI); 2/2 llm.c fp32 ports PASS on all three |
|
|
20
|
+
| CPU (Numba) | working | 12/12 zoo PASS (fp32) |
|
|
21
|
+
| HIP (hipRTC) | **unverified** | ports written; `scripts/amd_check.sh` ready for an AMD machine |
|
|
22
|
+
|
|
23
|
+
### What has been proven
|
|
24
|
+
|
|
25
|
+
- **Real code:** `examples/llm.c` has 9 kernels from unmodified llm.c files (host code, cuBLAS headers,
|
|
26
|
+
`Packed128` templates), 20 PASS results across 5 hardware targets.
|
|
27
|
+
- **A real bug found:** validation exposed that llm.c's `softmax_forward_online_kernel8` leaves rows
|
|
28
|
+
unwritten when C < block size. Fix submitted upstream: karpathy/llm.c#867.
|
|
29
|
+
- **Fresh agent:** a coding agent with no context ported 4 new kernels; 4/4 PASS on the first
|
|
30
|
+
verification. Its feedback was fixed.
|
|
31
|
+
- **Install:** `pip install kernelport` from PyPI, clean install checked.
|
|
32
|
+
- **Honesty checks:** deliberately broken ports fail for the right reason on every backend; tuning
|
|
33
|
+
and benchmarks refuse to report noise as speedups.
|
|
34
|
+
|
|
35
|
+
## Next steps
|
|
36
|
+
|
|
37
|
+
### Owner actions (need an account, hardware or a decision)
|
|
38
|
+
|
|
39
|
+
1. **AMD:** get AMD Developer Cloud credits (AMD AI Developer Program), start an MI300X with the
|
|
40
|
+
ROCm image, run `bash scripts/amd_check.sh`, send back `amd_results.txt`.
|
|
41
|
+
2. **Colab:** run `notebooks/freeze_references_colab.ipynb` once on a free T4. That also gives the
|
|
42
|
+
first Linux + NVIDIA run.
|
|
43
|
+
3. **Demo video/GIF (30-60 s):** clone a CUDA-only repo, one prompt to the agent, the green status
|
|
44
|
+
table. This is the single biggest launch lever.
|
|
45
|
+
4. **Launch posts, same day:** Show HN, r/LocalLLaMA, r/MachineLearning, X (MLX and Triton
|
|
46
|
+
communities). Lead with "proven correct, not just translated" and the llm.c bug.
|
|
47
|
+
5. Optional: try Codex / Cursor / Gemini CLI with `kernelport setup` (all free tiers work; no
|
|
48
|
+
API credits needed anywhere).
|
|
49
|
+
|
|
50
|
+
### Engineering that would make it better
|
|
51
|
+
|
|
52
|
+
- **Linux GPU in CI:** none of the free runners have one; a Colab or Kaggle notebook run per
|
|
53
|
+
release would cover Linux + NVIDIA.
|
|
54
|
+
- **Multi-kernel pipelines:** verify a sequence (e.g. layernorm -> matmul -> gelu) end to end,
|
|
55
|
+
not just single kernels.
|
|
56
|
+
- **More real projects:** e.g. a FlashAttention-style kernel or a cuBLAS-heavy repo.
|
|
57
|
+
- **Browser demo page:** paste a CUDA kernel, watch the WGSL port verified on your own GPU.
|
|
58
|
+
- **Report polish:** the HTML report is what people will share.
|
|
59
|
+
- **Physical Mac timings:** CI's virtual M1 verifies correctness but gives no fair speed numbers.
|
|
60
|
+
|
|
61
|
+
## Could it trend on GitHub?
|
|
62
|
+
|
|
63
|
+
It has a real chance with a deliberate launch. In its favour: a timely hook (CUDA lock-in, Apple
|
|
64
|
+
Silicon, coding agents), a distinctive angle (other tools translate; none prove ports correct on
|
|
65
|
+
real hardware), a recognisable real-code example (llm.c) plus a real upstream bug fix, and a
|
|
66
|
+
two-minute install. Against: without a demo video it stays abstract, and the "NVIDIA needed once
|
|
67
|
+
for validation" step needs explaining (the Colab notebook answers it).
|
|
68
|
+
|
|
69
|
+
## Rules kept during development
|
|
70
|
+
|
|
71
|
+
- No large downloads; anything downloaded for testing is uninstalled afterwards.
|
|
72
|
+
- No API credits spent (owner's choice; nothing requires them).
|
|
73
|
+
- Any edit to real agent config (`~/.claude.json`) is reverted after testing.
|
|
74
|
+
- Nothing is posted publicly (issues, PRs) without the owner's go-ahead.
|
|
@@ -1,6 +1,6 @@
|
|
|
1
1
|
Metadata-Version: 2.5
|
|
2
2
|
Name: kernelport
|
|
3
|
-
Version: 0.
|
|
3
|
+
Version: 0.2.0
|
|
4
4
|
Summary: Bring CUDA-only kernels to Mac, AMD, browsers, and CPU, with proof they are correct.
|
|
5
5
|
Project-URL: Homepage, https://github.com/PS12007/kernelport
|
|
6
6
|
Project-URL: Documentation, https://github.com/PS12007/kernelport/tree/main/docs
|
|
@@ -68,6 +68,7 @@ Description-Content-Type: text/markdown
|
|
|
68
68
|
# kernelport
|
|
69
69
|
|
|
70
70
|
[](https://github.com/PS12007/kernelport/actions/workflows/ci.yml)
|
|
71
|
+
[](https://pypi.org/project/kernelport/)
|
|
71
72
|
|
|
72
73
|
Bring CUDA-only kernels to Mac, AMD, browsers, and CPU, with proof they are correct.
|
|
73
74
|
|
|
@@ -76,10 +77,15 @@ Cursor, Gemini CLI) writes the ports; kernelport runs them on real hardware and
|
|
|
76
77
|
one against a reference that was itself validated against the original CUDA kernel. A port is
|
|
77
78
|
only ever reported as **PASS** if its current code ran on real hardware and matched.
|
|
78
79
|
|
|
79
|
-
> Status: early release (0.
|
|
80
|
+
> Status: early release (0.2.0, [changelog](https://github.com/PS12007/kernelport/blob/main/CHANGELOG.md)). Triton, CPU and WebGPU backends work and are verified;
|
|
80
81
|
> Metal is verified on Apple Silicon in CI; the HIP runner and zoo ports are written but not yet
|
|
81
82
|
> verified on an AMD GPU. See [PROGRESS.md](https://github.com/PS12007/kernelport/blob/main/PROGRESS.md).
|
|
82
83
|
|
|
84
|
+
|
|
85
|
+
|
|
86
|
+
*A real session on an RTX 5060, with the steps an agent takes through the MCP tools run here from the CLI.
|
|
87
|
+
Re-record it with [scripts/record_demo.py](https://github.com/PS12007/kernelport/blob/main/scripts/record_demo.py).*
|
|
88
|
+
|
|
83
89
|
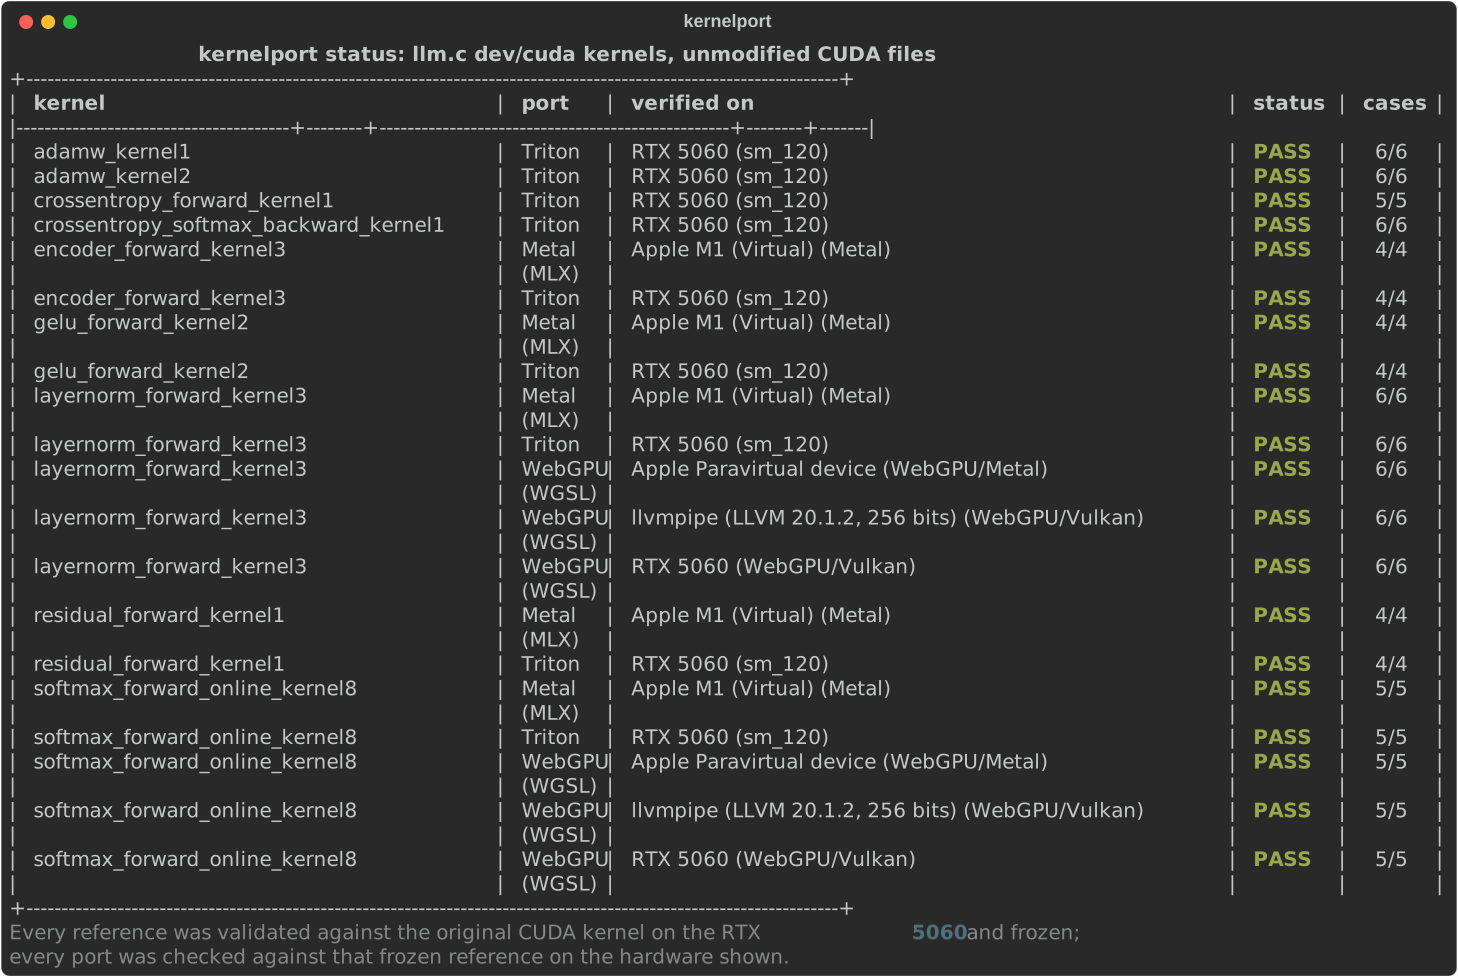
|
|
84
90
|
|
|
85
91
|
*Real code, real hardware: [examples/llm.c](https://github.com/PS12007/kernelport/tree/main/examples/llm.c).*
|
|
@@ -111,7 +117,7 @@ skill. Details: [docs/how-it-works.md](https://github.com/PS12007/kernelport/blo
|
|
|
111
117
|
```bash
|
|
112
118
|
# 1. install (CUDA build of torch first; see docs/installation.md)
|
|
113
119
|
pip install --index-url https://download.pytorch.org/whl/cu128 torch
|
|
114
|
-
pip install "kernelport[cuda,triton,cpu]
|
|
120
|
+
pip install "kernelport[cuda,triton,cpu]"
|
|
115
121
|
|
|
116
122
|
# 2. check what can run here
|
|
117
123
|
kernelport doctor
|
|
@@ -136,14 +142,21 @@ given only the one-line request and kernelport's guide; each of its ports passed
|
|
|
136
142
|
verification. Validation also found an undocumented precondition in llm.c:
|
|
137
143
|
`softmax_forward_online_kernel8` leaves rows unwritten when C < block size.
|
|
138
144
|
|
|
145
|
+
[`examples/flash-attention-minimal`](https://github.com/PS12007/kernelport/tree/main/examples/flash-attention-minimal)
|
|
146
|
+
does the same for a FlashAttention forward pass (unmodified `flash.cu`, PyTorch-extension host
|
|
147
|
+
code). The Triton port passes and runs 23x faster than the original on the same GPU; the WGSL
|
|
148
|
+
port passes on three WebGPU adapters and the Metal port on Apple M1 (CI). Its README documents where the original's own
|
|
149
|
+
`__expf` and float32 rounding stay within kernelport's fixed tolerance (N <= 384), rather than
|
|
150
|
+
loosening it.
|
|
151
|
+
|
|
139
152
|
## Backends
|
|
140
153
|
|
|
141
154
|
| backend | port language | runs on | status |
|
|
142
|
-
|
|
155
|
+
|---|---|---|---|
|
|
143
156
|
| `triton` | Triton (Python) | NVIDIA (triton / triton-windows), AMD ROCm | working |
|
|
144
157
|
| `cpu` | Numba (Python) | any machine | working (float32/float64) |
|
|
145
158
|
| `metal` | Metal kernel bodies via MLX `metal_kernel` | Apple Silicon | working (float32/float16/bfloat16), verified in CI on an Apple M1 |
|
|
146
|
-
| `webgpu` | WGSL | any Vulkan / Metal / D3D12 GPU via wgpu-native (core WebGPU only, so browser-portable) | working (float32/float16); verified on NVIDIA (Vulkan), Apple (Metal) and llvmpipe (software Vulkan) |
|
|
159
|
+
| `webgpu` | WGSL | any Vulkan / Metal / D3D12 GPU via wgpu-native (core WebGPU only, so browser-portable) | working (float32/float16); verified on NVIDIA (Vulkan), Apple (Metal) and llvmpipe (software Vulkan), and in a browser (Edge) on NVIDIA and Intel GPUs |
|
|
147
160
|
| `hip` | HIP C++ via hipRTC (CuPy ROCm) | AMD ROCm | written, launch path tested on NVIDIA, **not yet verified on AMD** |
|
|
148
161
|
|
|
149
162
|
Ports for a backend that is not available on the current machine are saved as **UNVERIFIED**,
|
|
@@ -152,12 +165,12 @@ never PASS. Commit `.kernelport/` and run `kernelport verify` on the right machi
|
|
|
152
165
|
## No coding agent? Use the built-in one (optional)
|
|
153
166
|
|
|
154
167
|
```bash
|
|
155
|
-
pip install "kernelport[agent]
|
|
168
|
+
pip install "kernelport[agent]"
|
|
156
169
|
export ANTHROPIC_API_KEY=... # or: ant auth login
|
|
157
170
|
kernelport agent "port the CUDA kernels in this repo to Triton and verify them"
|
|
158
171
|
```
|
|
159
172
|
|
|
160
|
-
`kernelport agent` runs Claude (default `claude-opus-5-5`) in a tool-use loop over the same
|
|
173
|
+
`kernelport agent` runs Claude (default `claude-opus-5-5`) in a tool-use loop over the same 15
|
|
161
174
|
tools the MCP server exposes, with the workflow skill as its system prompt. It can only act
|
|
162
175
|
through those tools, so all writes stay in `.kernelport/` and it cannot run shell commands.
|
|
163
176
|
Runs are billed to **your** Anthropic account, so it asks before starting (`--yes` skips the
|
|
@@ -192,6 +205,22 @@ Measured on an RTX 5060 Laptop GPU (sm_120) and an i7-14700HX (28 threads), benc
|
|
|
192
205
|
|
|
193
206
|
(n/c = wall-clock time (CPU, or WebGPU including submission), not comparable to GPU kernel time.)
|
|
194
207
|
|
|
208
|
+
### Check the WGSL ports in your browser
|
|
209
|
+
|
|
210
|
+
[`docs/web/`](https://github.com/PS12007/kernelport/tree/main/docs/web) is a single page with no
|
|
211
|
+
dependencies. It runs the 12 WGSL ports on your GPU through the browser's WebGPU and compares every
|
|
212
|
+
output with the frozen reference, using kernelport's tolerances, in float32 and (where the GPU has `shader-f16`) float16. The inputs, expected outputs,
|
|
213
|
+
tolerances and shaders come from kernelport's own harness (`scripts/build_web_demo.py`).
|
|
214
|
+
|
|
215
|
+
```bash
|
|
216
|
+
python -m http.server -d docs/web 8000 # then open http://localhost:8000
|
|
217
|
+
python scripts/check_web_demo.py # or headless, in Chrome/Edge (add --discrete for the dGPU)
|
|
218
|
+
```
|
|
219
|
+
|
|
220
|
+
All 12 ports pass in both dtypes (24/24, 114 cases) in Edge on an RTX 5060 and on Intel UHD Graphics (the i7-14700HX's iGPU). The page also caught a
|
|
221
|
+
real portability bug: the softmax port wrote `-3.4028235e38`, a decimal just above the largest f32.
|
|
222
|
+
wgpu-native rounds it, but browsers reject the shader. The webgpu runner now refuses such literals.
|
|
223
|
+
|
|
195
224
|
## CLI
|
|
196
225
|
|
|
197
226
|
Every MCP tool has a CLI equivalent, so you can drive the workflow by hand or from CI:
|
|
@@ -208,6 +237,8 @@ Every MCP tool has a CLI equivalent, so you can drive the workflow by hand or fr
|
|
|
208
237
|
| `kernelport verify` | `verify_port` | port vs frozen reference |
|
|
209
238
|
| `kernelport bench` | `bench_port` | time port vs original (after PASS) |
|
|
210
239
|
| `kernelport tune <id> <backend>` | `tune_port` | verify + time every `TUNE` variant, keep the fastest that passes |
|
|
240
|
+
| `kernelport pipeline [name]` | `write_pipeline`, `verify_pipeline` | run ported kernels in a chain; check every stage on real intermediate data |
|
|
241
|
+
| `kernelport pipeline <name> --bench` | `bench_pipeline` | time the chain of ports vs the original CUDA chain, whole and per stage (after PASS) |
|
|
211
242
|
| `kernelport status` | `list_status` | kernel × backend × hardware table |
|
|
212
243
|
| `kernelport report [--md]` | `make_report` | HTML or Markdown report |
|
|
213
244
|
| `kernelport setup` | – | register with Claude Code / Codex / Cursor / Gemini CLI |
|
|
@@ -222,16 +222,120 @@
|
|
|
222
222
|
- llm.c softmax bug: a fix was tested (remove the early return, guard the -inf merge: 10/10 C values
|
|
223
223
|
PASS); issue text drafted for the owner, not posted.
|
|
224
224
|
|
|
225
|
+
- **Macro-defined kernels + README demo** (2026-10-15):
|
|
226
|
+
- `analyzer/macros.py`: a small cpp-style expander (object/function-like macros, `#`, `##`,
|
|
227
|
+
`__VA_ARGS__` and GNU `args...`, nested calls, macro names as arguments, recursion guard, size/depth
|
|
228
|
+
caps). The analyzer finds kernels stamped out by macros (`FOR_TYPES(DEFINE_SCALE)`), marked by
|
|
229
|
+
`#define KERNEL __global__ __launch_bounds__(128)`, or opened by a macro (`C_KERNEL(name)(...) {...}`),
|
|
230
|
+
records `generated_by`, ignores `__global__` inside `#define` bodies, and reads bodies through macros
|
|
231
|
+
(`KERNEL_LOOP`) for param kinds and features. The NVRTC slicer treats a top-level call of a known macro
|
|
232
|
+
as its own item (kept if its expansion has device code, blanked if host only), and an unterminated
|
|
233
|
+
item ends at the next directive. Checked on the 40 kernel-bearing .cu/.cuh files shipped in torch and
|
|
234
|
+
cupy: no crashes, under 0.1 s each, no false kernels. A macro-generated kernel validates end to end on
|
|
235
|
+
the RTX 5060 (tests/test_macros.py).
|
|
236
|
+
- `scripts/record_demo.py`: records a real CLI session (zoo softmax -> Triton: a port without the max
|
|
237
|
+
subtraction FAILs 21/24, the fix PASSes 24/24) and renders an animated SVG terminal for the README;
|
|
238
|
+
box characters are drawn as lines and text is pinned to the grid so any font lines up.
|
|
239
|
+
- CLI/report: `verify`/`bench` take a positional kernel id; piped output honours `$COLUMNS`; the
|
|
240
|
+
"unexpected NaN" hint also names overflow. CI: the WebGPU racy-port test is skipped on CPU adapters,
|
|
241
|
+
where the race may not happen (it caused the red runs on 2026-10-14).
|
|
242
|
+
|
|
243
|
+
- **Report, browser check, FlashAttention** (2026-10-15, later):
|
|
244
|
+
- Report: headline sentence, readable dark-mode links, PASS cells name the hardware and speedup,
|
|
245
|
+
unstarted kernels folded into one list; Markdown matches.
|
|
246
|
+
- `docs/web/`: an in-browser WebGPU check of the 12 zoo WGSL ports, built from kernelport's own
|
|
247
|
+
harness (`scripts/build_web_demo.py`); `scripts/check_web_demo.py` runs it headless and CI runs it in
|
|
248
|
+
Chrome (SwiftShader on Linux, the Apple GPU on macOS). 12/12 in Edge on the RTX 5060 and Intel UHD.
|
|
249
|
+
It caught a real bug: the softmax WGSL port used `-3.4028235e38` (above FLT_MAX); naga accepts it,
|
|
250
|
+
Tint rejects it. The runner now refuses out-of-range float literals.
|
|
251
|
+
- `examples/flash-attention-minimal`: unmodified flash.cu; reference validated 6/6 for N <= 384 (the
|
|
252
|
+
original's own `__expf`/fp32 rounding exceeds the fixed tolerance at N = 512, so larger sizes are
|
|
253
|
+
documented, not claimed); Triton 23x, WGSL and Metal PASS. Porting to WGSL found that wgpu-native
|
|
254
|
+
(naga before v30, as bundled by wgpu-py 0.32) zeroes a loop-local `var` without initializer only once
|
|
255
|
+
(WGSL: every iteration; fixed upstream in gfx-rs/wgpu#9592); the runner refuses it.
|
|
256
|
+
Harness: init `{"dist": "full", "value": "-inf"}`.
|
|
257
|
+
|
|
258
|
+
- **Pipelines** (2026-10-17): `kernelport/harness/pipeline.py`, tools `write_pipeline` /
|
|
259
|
+
`verify_pipeline` (14 tools), CLI `kernelport pipeline`. A pipeline (`.kernelport/pipelines/<name>.json`)
|
|
260
|
+
names buffers (generated with `init`, or written by a stage) and stages (kernel id, `dims` mapping,
|
|
261
|
+
`bind` params -> buffers). `resolve` checks names, dtypes, read-before-write and element counts against
|
|
262
|
+
the frozen specs. Each stage's port output is compared with its frozen reference on the exact input it
|
|
263
|
+
received (usual tolerances; PASS/FAIL comes only from this). A float64 chain of references gives
|
|
264
|
+
end-to-end drift: worst |err| / (atol + rtol|exact|) per buffer plus a count of inf/NaN in one chain
|
|
265
|
+
only; reported, never decides (relative error was useless: 1e-90 vs 0). Backend `cuda` chains the
|
|
266
|
+
originals. Results in `pipelines/results/<name>/<backend>/<hw>.json`; `status` and both reports show
|
|
267
|
+
them, downgraded to UNVERIFIED when the pipeline, a port/source or a reference changed.
|
|
268
|
+
examples/llm.c: `gpt2_loss_head` (softmax -> crossentropy -> backward, fp32) and
|
|
269
|
+
`gpt2_embed_gelu_residual` (bf16), PASS on Triton and the originals (RTX 5060); CI runs the bf16 one
|
|
270
|
+
on Metal. Findings: fp32 softmax underflow makes some losses inf on confident logits (originals 8/16,
|
|
271
|
+
ports 5/16, `__expf` vs `exp`); bf16 drift reaches 1.5x one kernel's tolerance after 3 kernels, same for
|
|
272
|
+
originals and ports. `tests/bad_ports/crossentropy_clamped.py` (clamps probs >= 1e-3) PASSes its own
|
|
273
|
+
cases and FAILs the pipeline.
|
|
274
|
+
|
|
275
|
+
- **Static warnings + llm.c kernel7** (2026-10-24): a reviewer on llm.c#867 noted that
|
|
276
|
+
`softmax_forward_kernel7` returns early on `tid >= C` too, which leaves partial warps in full-mask
|
|
277
|
+
`warpReduceMax/Sum` (undefined) and races lane 0 on `maxvals/sumvals[warpId]`. On the RTX 5060 the
|
|
278
|
+
unfixed kernel7 is still correct for C = 1..50257, block 32..1024, with and without fast math (504/504
|
|
279
|
+
configs), so validation cannot find it. Fix on the PR branch (local commit, not pushed): return only
|
|
280
|
+
when the whole warp is past C, lane 0 writes the slots; 504/504, same speed at C = 50257 (removing the
|
|
281
|
+
return entirely was ~2% slower). The PR's first commit had also converted softmax_forward.cu to CRLF
|
|
282
|
+
(GitHub showed all 733 lines changed); a commit restores LF, net diff 16 lines.
|
|
283
|
+
New `kernelport/analyzer/hazards.py`: warns when a lane-varying condition (from threadIdx.x,
|
|
284
|
+
thread_rank(), laneid; `/ 32` makes a value warp-uniform) returns before a full-mask warp op
|
|
285
|
+
(`__shfl*_sync`, `__syncwarp()`, votes, `cg::reduce`, warp-reduce helpers by name or via `__device__`
|
|
286
|
+
bodies; `__activemask()` masks excluded). `KernelInfo.warnings`; shown by `scan` (CLI + tool summary) and
|
|
287
|
+
`read_kernel`; SKILL.md tells agents to add warp-splitting cases. Flags exactly kernel7 and kernel8 in
|
|
288
|
+
llm.c dev/cuda; 1 of 152 llama.cpp ggml-cuda kernels (`quantize_mmq_q8_1`, safe there only because ne0 is
|
|
289
|
+
padded). Also fixed: kernels opening a brace in each `#if` branch (llama.cpp mmf.cuh) crashed the whole
|
|
290
|
+
scan; braces are now matched in the first branch only, and an unparseable kernel is skipped.
|
|
291
|
+
|
|
292
|
+
- **Pipeline timing** (2026-10-27): `bench_pipeline(name, backend, case=None)` (15th tool) and
|
|
293
|
+
`kernelport pipeline <name> --bench [--case]`. Requires a current PASS for the pipeline on this backend
|
|
294
|
+
and hardware. `harness.pipeline.stage_inputs` runs the chain once with the ports and keeps each stage's
|
|
295
|
+
real input; each stage's port and original are then prepared on their own copy of it, and the whole
|
|
296
|
+
chain (launched back to back) and each stage are timed in 3 alternating rounds (CUDA events where the
|
|
297
|
+
backend allows). No data flows between stages while timing, so the numbers are kernel time only. Result
|
|
298
|
+
in `pipelines/results/<name>/<backend>/bench/<hw>.json` (not read back as a verification result).
|
|
299
|
+
RTX 5060, Triton: `gpt2_loss_head` at 4x64x50257 = 1.00 ms vs 1.33 ms (1.33x; softmax 1.68x,
|
|
300
|
+
crossentropy fwd/bwd ~0.97x); `gpt2_embed_gelu_residual` at 4x256x768 bf16 about even. A first run named the encoder
|
|
301
|
+
port 0.44x; reruns moved the "slow" stage around: single rounds of ~10 us kernels spike up to 3x, so
|
|
302
|
+
bench_pipeline now takes 5 rounds and names a stage slower only when no round overlaps. The encoder's
|
|
303
|
+
Triton port was rewritten row-wise anyway (one token-id load per row, no per-element divide): 0.023 vs
|
|
304
|
+
0.025 ms. The original encoder measures 0.024-0.047 ms depending on the session (steady within one).
|
|
305
|
+
|
|
306
|
+
- **Block-barrier hazards** (2026-10-28): `analyzer/hazards.py` gets a second check,
|
|
307
|
+
`divergent_barriers`: a block barrier (`__syncthreads*`, `this_thread_block().sync()`, `block.sync()` on a
|
|
308
|
+
`thread_block`, `cg::sync`, `blockReduce`-style helpers by name or via `__device__` bodies, template calls
|
|
309
|
+
included) that some threads can miss: (a) a thread-dependent `return` before it, (b) inside an `if` whose
|
|
310
|
+
condition depends on threadIdx (any dim; `/ 32` does not make it block-uniform), (c) inside a loop whose
|
|
311
|
+
condition does. CUDA-side exemptions, from false positives in llama.cpp: a `for` whose start and bound
|
|
312
|
+
shift by the same thread term (wkv.cu, gla.cu), and a return inside a block that always ends in `return;`
|
|
313
|
+
(mmq.cuh fixup). Early return before `__syncthreads` is a deliberate idiom on NVIDIA (exited threads count
|
|
314
|
+
as arrived; llm.c's encoder.cuh says so), so that kind is worded as a porting note; branch/loop kinds as a
|
|
315
|
+
CUDA hazard. Scan of 340 kernels: llm.c fork 7 (4 loop cases: dev layernorm_backward kernel9/10,
|
|
316
|
+
fused_residual_forward_kernel6, llmc layernorm_backward_kernel10; 3 early returns), llama.cpp ggml-cuda 4
|
|
317
|
+
early returns, zoo 0.
|
|
318
|
+
**WGSL gap found:** wgpu-native 29 (naga, wgpu-py 0.32) accepts a `workgroupBarrier()` after a
|
|
319
|
+
non-uniform return, inside a divergent `if`, or in a divergent loop; Edge (Tint) rejects all three
|
|
320
|
+
("must only be called from uniform control flow"), plus two cases the CUDA exemptions would allow (a
|
|
321
|
+
shifted loop; a return nested in a branch that returns). So a WGSL port could PASS here and not compile in
|
|
322
|
+
a browser. The runner now refuses these (`check_barrier_uniformity`, reusing `divergent_barriers` in
|
|
323
|
+
`strict` mode with the invocation-id builtins as sources; WGSL is rewritten to C-style conditions first).
|
|
324
|
+
Agrees with Edge on all 6 probe shaders; all 15 existing WGSL ports are accepted. Not followed: Tint also
|
|
325
|
+
treats loads from read_write storage as non-uniform. Skill: SKILL.md, webgpu.md, metal.md.
|
|
326
|
+
|
|
225
327
|
## Next (pick up here)
|
|
226
328
|
Owner actions (see RELEASING.md for PyPI):
|
|
227
|
-
- PyPI:
|
|
228
|
-
|
|
329
|
+
- PyPI: DONE 2026-10-14, kernelport 0.1.0 published via release.yml (tag v0.1.0); clean `pip install
|
|
330
|
+
kernelport` verified. Next release: bump version, tag `vX.Y.Z`.
|
|
331
|
+
- llm.c softmax fix: posted by the owner as karpathy/llm.c#867 (branch fix-softmax-online-kernel8-small-c
|
|
332
|
+
on PS12007/llm.c). A reviewer flagged kernel7; the fix and an LF restore are committed in the local
|
|
333
|
+
clone C:\-CS\llm.c-fork, waiting for the owner's go-ahead to push (and to reply on the PR).
|
|
229
334
|
- HIP + Triton-on-ROCm: run `bash scripts/amd_check.sh` on an AMD machine (AMD Developer Cloud
|
|
230
335
|
credits via the AMD AI Developer Program); it writes amd_results.txt. Live `kernelport agent` test: skipped
|
|
231
336
|
by owner choice (no API credits); the MCP/CLI path covers the same tools;
|
|
232
337
|
run notebooks/freeze_references_colab.ipynb once on Colab; dogfood with Codex / Cursor too.
|
|
233
|
-
Engineering left:
|
|
234
|
-
launch posts.
|
|
338
|
+
Engineering left: a demo GIF/video; launch posts.
|
|
235
339
|
|
|
236
340
|
## How to resume
|
|
237
341
|
- Env: `.venv` (Python 3.12, torch 2.11.0+cu128, triton-windows 3.7.1, cupy-cuda12x 14.2). `kernelport doctor`.
|
|
@@ -244,7 +348,9 @@ launch posts.
|
|
|
244
348
|
## Known issues / notes
|
|
245
349
|
- Requires mcp>=2.0 (FastMCP was renamed MCPServer in 2.x; we use the 2.x API only).
|
|
246
350
|
- The zoo is not shipped in the wheel; `kernelport zoo` needs a repo checkout (or cwd containing zoo/).
|
|
247
|
-
- Analyzer is lexical, not a C++ front end
|
|
351
|
+
- Analyzer is lexical, not a C++ front end. Macro-defined kernels are found by a small macro expander
|
|
352
|
+
(`kernelport/analyzer/macros.py`: object/function-like macros, # and ##, variadics, macro-name arguments);
|
|
353
|
+
`#if` is not evaluated (the last `#define` wins). Kernels behind #if branches, and
|
|
248
354
|
pointer kinds through complex aliasing (structs of pointers, pointer arithmetic in loops) may be wrong.
|
|
249
355
|
Kinds are suggestions; the agent confirms them, and reference validation catches mistakes.
|
|
250
356
|
- Reductions (reduce_sum, matmul_naive, cumsum) use inputs quantized to multiples of 1/16 (`"step"` in
|