kernelport 0.1.0__tar.gz
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- kernelport-0.1.0/.gitattributes +2 -0
- kernelport-0.1.0/.github/workflows/ci.yml +134 -0
- kernelport-0.1.0/.github/workflows/release.yml +44 -0
- kernelport-0.1.0/.gitignore +12 -0
- kernelport-0.1.0/LAUNCH_PLAN.md +118 -0
- kernelport-0.1.0/LICENSE +21 -0
- kernelport-0.1.0/PKG-INFO +228 -0
- kernelport-0.1.0/PROGRESS.md +269 -0
- kernelport-0.1.0/README.md +161 -0
- kernelport-0.1.0/RELEASING.md +47 -0
- kernelport-0.1.0/docs/how-it-works.md +105 -0
- kernelport-0.1.0/docs/img/llmc-status.svg +210 -0
- kernelport-0.1.0/docs/installation.md +97 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/index.json +29 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/frozen/launch.json +199 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/frozen/reference.py +19 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/kernel.json +171 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/launch.json +199 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/ports/triton/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +22 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/ports/triton/port.py +35 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +381 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/reference.py +19 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel1-6b9a0c/validation.json +381 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/frozen/launch.json +199 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/frozen/reference.py +19 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/kernel.json +171 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/launch.json +199 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/ports/triton/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +22 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/ports/triton/port.py +35 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +381 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/reference.py +19 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/adamw_kernel2-d4071f/validation.json +381 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/frozen/launch.json +120 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/frozen/reference.py +7 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/kernel.json +99 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/launch.json +120 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/ports/triton/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +22 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/ports/triton/port.py +23 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +156 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/reference.py +7 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_forward_kernel1-0f4382/validation.json +156 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/frozen/launch.json +146 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/frozen/reference.py +7 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/kernel.json +111 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/launch.json +146 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/ports/triton/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +22 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/ports/triton/port.py +29 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +189 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/reference.py +7 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/crossentropy_softmax_backward_ke-5a0892/validation.json +189 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel1-1864a1/kernel.json +111 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel2-8ee6db/kernel.json +111 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/frozen/launch.json +132 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/frozen/reference.py +2 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/kernel.json +111 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/launch.json +132 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/metal/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/metal/port.py +21 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/metal/results/apple-m1-virtual-metal.json +133 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/attempts.jsonl +3 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +12 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/port.py +29 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +133 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/ports/triton/tune/tune.json +222 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/reference.py +2 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/encoder_forward_kernel3-83fda5/validation.json +133 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel1-ba054e/kernel.json +63 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/frozen/launch.json +74 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/frozen/reference.py +8 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/kernel.json +63 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/launch.json +74 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/metal/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/metal/port.py +15 -0
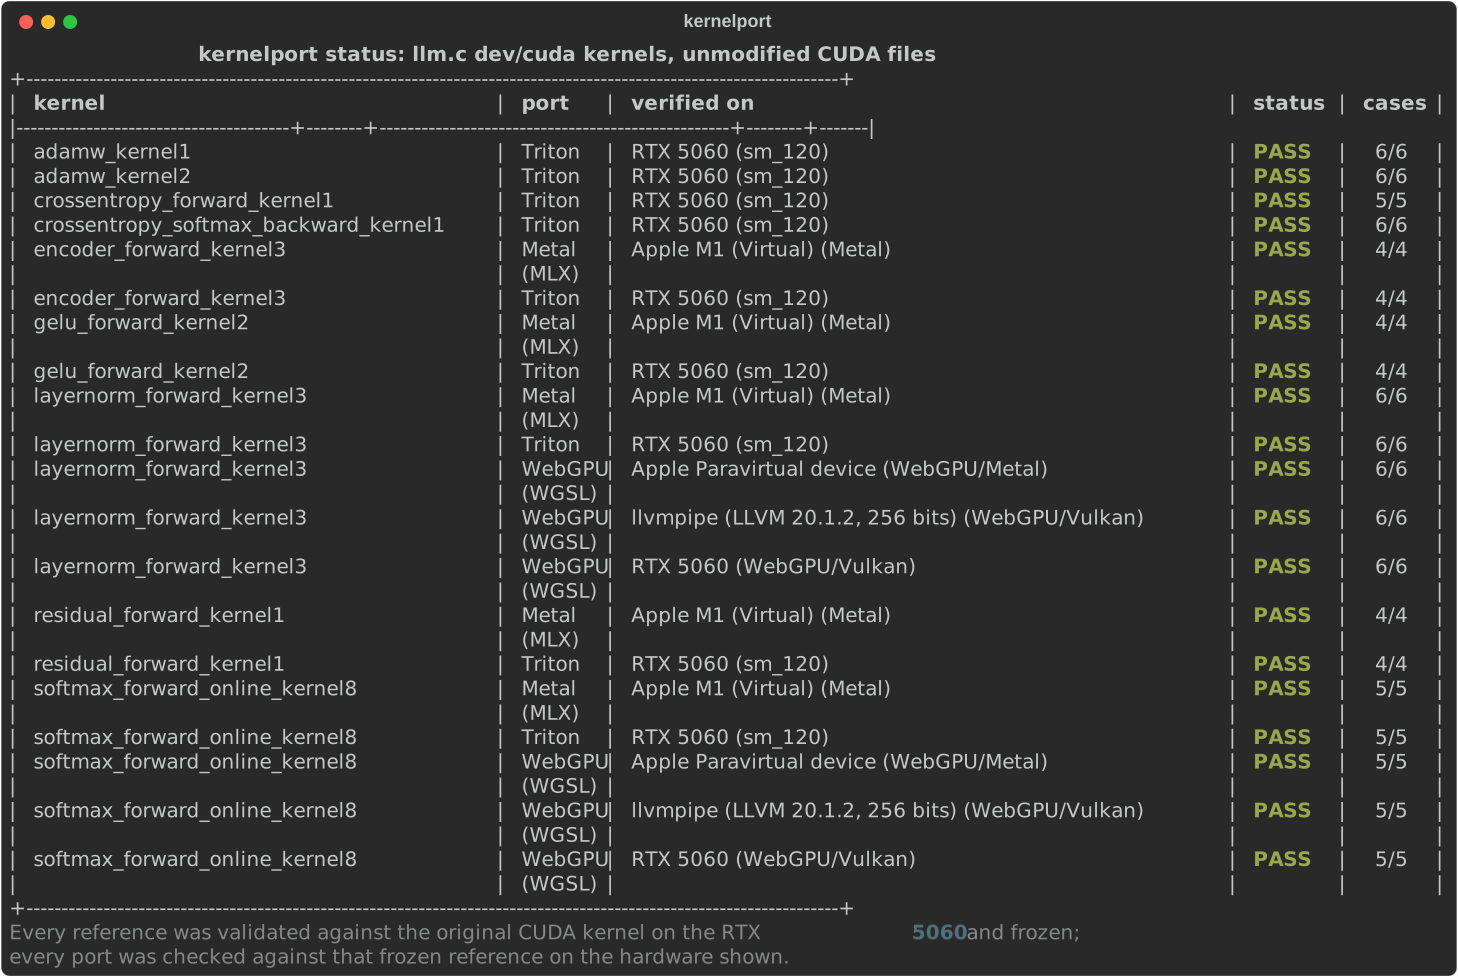
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/metal/results/apple-m1-virtual-metal.json +125 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/triton/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +12 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/triton/port.py +22 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +125 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/reference.py +8 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/gelu_forward_kernel2-a68cbd/validation.json +125 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel1-4d2ec2/kernel.json +123 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/frozen/launch.json +138 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/frozen/reference.py +8 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/kernel.json +125 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/launch.json +138 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/metal/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/metal/port.py +42 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/metal/results/apple-m1-virtual-metal.json +387 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/triton/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +12 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/triton/port.py +39 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +387 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/bench/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +12 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/port.py +44 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/results/apple-paravirtual-device-webgpu-metal.json +387 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/results/llvmpipe-llvm-20-1-2-256-bits-webgpu-vulkan.json +387 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/ports/webgpu/results/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +387 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/reference.py +8 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel3-e551c3/validation.json +387 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel4-d55f38/kernel.json +125 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel5-4b05bb/kernel.json +146 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/layernorm_forward_kernel6-137835/kernel.json +128 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/mean_kernel-e0b51b/kernel.json +91 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/normalization_kernel-4c4090/kernel.json +135 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/frozen/launch.json +86 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/frozen/reference.py +2 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/kernel.json +75 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/launch.json +86 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/metal/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/metal/port.py +13 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/metal/results/apple-m1-virtual-metal.json +125 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/triton/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +12 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/triton/port.py +18 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +125 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/reference.py +2 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel1-2423a3/validation.json +125 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/residual_forward_kernel2-3e3587/kernel.json +75 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/rstd_kernel-30478b/kernel.json +103 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_kernel1-2619de/kernel.json +75 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_kernel2-1cd536/kernel.json +79 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_kernel3-fc6e41/kernel.json +79 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_kernel4-c8e3ac/kernel.json +80 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_kernel7-4d52ba/kernel.json +80 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel1-ce266a/kernel.json +75 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel2-3de0c7/kernel.json +77 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/frozen/launch.json +93 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/frozen/manifest.json +9 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/frozen/reference.py +5 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/kernel.json +78 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/launch.json +93 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/metal/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/metal/port.py +45 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/metal/results/apple-m1-virtual-metal.json +156 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/triton/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/triton/bench/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +12 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/triton/port.py +36 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/triton/results/nvidia-geforce-rtx-5060-laptop-gpu-sm_120.json +156 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/attempts.jsonl +1 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/bench/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +12 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/port.py +51 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/results/apple-paravirtual-device-webgpu-metal.json +156 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/results/llvmpipe-llvm-20-1-2-256-bits-webgpu-vulkan.json +156 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/ports/webgpu/results/nvidia-geforce-rtx-5060-laptop-gpu-webgpu-vulkan.json +156 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/reference.py +5 -0
- kernelport-0.1.0/examples/llm.c/.kernelport/kernels/softmax_forward_online_kernel8-320025/validation.json +156 -0
- kernelport-0.1.0/examples/llm.c/LICENSE +21 -0
- kernelport-0.1.0/examples/llm.c/README.md +68 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/adamw.cu +226 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/common.h +385 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/crossentropy_forward.cu +148 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/crossentropy_softmax_backward.cu +165 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/encoder_forward.cu +260 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/gelu_forward.cu +174 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/layernorm_forward.cu +629 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/residual_forward.cu +167 -0
- kernelport-0.1.0/examples/llm.c/dev/cuda/softmax_forward.cu +733 -0
- kernelport-0.1.0/kernelport/__init__.py +3 -0
- kernelport-0.1.0/kernelport/__main__.py +5 -0
- kernelport-0.1.0/kernelport/agent.py +178 -0
- kernelport-0.1.0/kernelport/analyzer/__init__.py +0 -0
- kernelport-0.1.0/kernelport/analyzer/cuda_parser.py +480 -0
- kernelport-0.1.0/kernelport/analyzer/models.py +80 -0
- kernelport-0.1.0/kernelport/analyzer/suggest.py +120 -0
- kernelport-0.1.0/kernelport/backends/__init__.py +5 -0
- kernelport-0.1.0/kernelport/backends/base.py +138 -0
- kernelport-0.1.0/kernelport/backends/cpu/__init__.py +1 -0
- kernelport-0.1.0/kernelport/backends/cpu/capability.py +25 -0
- kernelport-0.1.0/kernelport/backends/cpu/config.py +36 -0
- kernelport-0.1.0/kernelport/backends/cpu/runner.py +67 -0
- kernelport-0.1.0/kernelport/backends/hip/__init__.py +1 -0
- kernelport-0.1.0/kernelport/backends/hip/capability.py +34 -0
- kernelport-0.1.0/kernelport/backends/hip/config.py +28 -0
- kernelport-0.1.0/kernelport/backends/hip/runner.py +48 -0
- kernelport-0.1.0/kernelport/backends/metal/__init__.py +1 -0
- kernelport-0.1.0/kernelport/backends/metal/capability.py +32 -0
- kernelport-0.1.0/kernelport/backends/metal/config.py +35 -0
- kernelport-0.1.0/kernelport/backends/metal/runner.py +142 -0
- kernelport-0.1.0/kernelport/backends/triton/__init__.py +1 -0
- kernelport-0.1.0/kernelport/backends/triton/capability.py +29 -0
- kernelport-0.1.0/kernelport/backends/triton/config.py +41 -0
- kernelport-0.1.0/kernelport/backends/triton/runner.py +44 -0
- kernelport-0.1.0/kernelport/backends/webgpu/__init__.py +1 -0
- kernelport-0.1.0/kernelport/backends/webgpu/capability.py +34 -0
- kernelport-0.1.0/kernelport/backends/webgpu/config.py +38 -0
- kernelport-0.1.0/kernelport/backends/webgpu/runner.py +285 -0
- kernelport-0.1.0/kernelport/bench/__init__.py +0 -0
- kernelport-0.1.0/kernelport/bench/timer.py +76 -0
- kernelport-0.1.0/kernelport/cli.py +501 -0
- kernelport-0.1.0/kernelport/doctor.py +285 -0
- kernelport-0.1.0/kernelport/hardware.py +60 -0
- kernelport-0.1.0/kernelport/harness/__init__.py +0 -0
- kernelport-0.1.0/kernelport/harness/compare.py +152 -0
- kernelport-0.1.0/kernelport/harness/device_source.py +273 -0
- kernelport-0.1.0/kernelport/harness/expr.py +80 -0
- kernelport-0.1.0/kernelport/harness/inputs.py +194 -0
- kernelport-0.1.0/kernelport/harness/reference.py +76 -0
- kernelport-0.1.0/kernelport/harness/results.py +118 -0
- kernelport-0.1.0/kernelport/harness/run_cuda.py +126 -0
- kernelport-0.1.0/kernelport/harness/spec.py +199 -0
- kernelport-0.1.0/kernelport/harness/tolerances.py +48 -0
- kernelport-0.1.0/kernelport/harness/verify.py +131 -0
- kernelport-0.1.0/kernelport/hashing.py +28 -0
- kernelport-0.1.0/kernelport/mcp_server.py +95 -0
- kernelport-0.1.0/kernelport/report/__init__.py +1 -0
- kernelport-0.1.0/kernelport/report/data.py +147 -0
- kernelport-0.1.0/kernelport/report/html.py +174 -0
- kernelport-0.1.0/kernelport/report/markdown.py +75 -0
- kernelport-0.1.0/kernelport/setup_agents/__init__.py +1 -0
- kernelport-0.1.0/kernelport/setup_agents/backup.py +59 -0
- kernelport-0.1.0/kernelport/setup_agents/detect.py +78 -0
- kernelport-0.1.0/kernelport/setup_agents/register.py +302 -0
- kernelport-0.1.0/kernelport/setup_agents/skills_install.py +31 -0
- kernelport-0.1.0/kernelport/tools.py +455 -0
- kernelport-0.1.0/kernelport/tune.py +99 -0
- kernelport-0.1.0/kernelport/workspace.py +400 -0
- kernelport-0.1.0/kernelport/zoo.py +176 -0
- kernelport-0.1.0/notebooks/freeze_references_colab.ipynb +102 -0
- kernelport-0.1.0/pyproject.toml +71 -0
- kernelport-0.1.0/scripts/amd_check.sh +64 -0
- kernelport-0.1.0/scripts/check_env.py +13 -0
- kernelport-0.1.0/scripts/render_status_svg.py +44 -0
- kernelport-0.1.0/skills/kernelport/SKILL.md +200 -0
- kernelport-0.1.0/skills/kernelport/backends/cpu.md +138 -0
- kernelport-0.1.0/skills/kernelport/backends/hip.md +53 -0
- kernelport-0.1.0/skills/kernelport/backends/metal.md +76 -0
- kernelport-0.1.0/skills/kernelport/backends/triton.md +117 -0
- kernelport-0.1.0/skills/kernelport/backends/webgpu.md +146 -0
- kernelport-0.1.0/skills/kernelport/common_bugs.md +40 -0
- kernelport-0.1.0/tests/bad_ports/cpu/cumsum_exclusive.py +16 -0
- kernelport-0.1.0/tests/bad_ports/cpu/layernorm_unbiased.py +25 -0
- kernelport-0.1.0/tests/bad_ports/cpu/reduce_sum_overwrites.py +18 -0
- kernelport-0.1.0/tests/bad_ports/cpu/relu_rebinds_output.py +7 -0
- kernelport-0.1.0/tests/bad_ports/cpu/relu_returns_array.py +7 -0
- kernelport-0.1.0/tests/bad_ports/cpu/vector_add_missing_tail.py +13 -0
- kernelport-0.1.0/tests/bad_ports/matmul_tf32.py +20 -0
- kernelport-0.1.0/tests/bad_ports/relu_leaky.py +15 -0
- kernelport-0.1.0/tests/bad_ports/softmax_first_chunk_sum.py +25 -0
- kernelport-0.1.0/tests/bad_ports/softmax_no_max.py +17 -0
- kernelport-0.1.0/tests/bad_ports/vector_add_compile_error.py +13 -0
- kernelport-0.1.0/tests/bad_ports/vector_add_missing_tail.py +15 -0
- kernelport-0.1.0/tests/bad_ports/vector_add_noop.py +5 -0
- kernelport-0.1.0/tests/bad_ports/vector_add_sub.py +14 -0
- kernelport-0.1.0/tests/bad_ports/vector_add_tiny_error.py +15 -0
- kernelport-0.1.0/tests/bad_ports/webgpu/reduce_sum_racy_add.py +28 -0
- kernelport-0.1.0/tests/bad_ports/webgpu/relu_wrong_name.py +13 -0
- kernelport-0.1.0/tests/bad_ports/webgpu/vector_add_grid_too_big.py +13 -0
- kernelport-0.1.0/tests/bad_ports/webgpu/vector_add_no_stride.py +16 -0
- kernelport-0.1.0/tests/conftest.py +28 -0
- kernelport-0.1.0/tests/fixtures/embedded_kernel.py +13 -0
- kernelport-0.1.0/tests/fixtures/host_mixed/helpers.cuh +18 -0
- kernelport-0.1.0/tests/fixtures/host_mixed/kernels.cu +66 -0
- kernelport-0.1.0/tests/fixtures/tricky.cu +58 -0
- kernelport-0.1.0/tests/test_agent.py +132 -0
- kernelport-0.1.0/tests/test_analyzer.py +150 -0
- kernelport-0.1.0/tests/test_backends.py +113 -0
- kernelport-0.1.0/tests/test_compare.py +116 -0
- kernelport-0.1.0/tests/test_cpu_backend.py +126 -0
- kernelport-0.1.0/tests/test_device_source.py +105 -0
- kernelport-0.1.0/tests/test_doctor.py +26 -0
- kernelport-0.1.0/tests/test_expr.py +28 -0
- kernelport-0.1.0/tests/test_harness_gpu.py +79 -0
- kernelport-0.1.0/tests/test_hip_backend.py +68 -0
- kernelport-0.1.0/tests/test_inputs.py +76 -0
- kernelport-0.1.0/tests/test_mcp_protocol.py +62 -0
- kernelport-0.1.0/tests/test_metal_backend.py +135 -0
- kernelport-0.1.0/tests/test_report.py +140 -0
- kernelport-0.1.0/tests/test_results.py +37 -0
- kernelport-0.1.0/tests/test_setup.py +189 -0
- kernelport-0.1.0/tests/test_skills.py +72 -0
- kernelport-0.1.0/tests/test_spec.py +45 -0
- kernelport-0.1.0/tests/test_tools.py +178 -0
- kernelport-0.1.0/tests/test_tune.py +205 -0
- kernelport-0.1.0/tests/test_webgpu_backend.py +135 -0
- kernelport-0.1.0/tests/test_workspace.py +257 -0
- kernelport-0.1.0/tests/test_zoo_originals.py +73 -0
- kernelport-0.1.0/zoo/cumsum/kernel.cu +37 -0
- kernelport-0.1.0/zoo/cumsum/launch.json +24 -0
- kernelport-0.1.0/zoo/cumsum/ports/cpu.py +20 -0
- kernelport-0.1.0/zoo/cumsum/ports/hip.hip +38 -0
- kernelport-0.1.0/zoo/cumsum/ports/metal.py +32 -0
- kernelport-0.1.0/zoo/cumsum/ports/triton.py +28 -0
- kernelport-0.1.0/zoo/cumsum/ports/webgpu.py +38 -0
- kernelport-0.1.0/zoo/cumsum/reference.py +7 -0
- kernelport-0.1.0/zoo/embedding_gather/kernel.cu +13 -0
- kernelport-0.1.0/zoo/embedding_gather/launch.json +28 -0
- kernelport-0.1.0/zoo/embedding_gather/ports/cpu.py +15 -0
- kernelport-0.1.0/zoo/embedding_gather/ports/hip.hip +14 -0
- kernelport-0.1.0/zoo/embedding_gather/ports/metal.py +15 -0
- kernelport-0.1.0/zoo/embedding_gather/ports/triton.py +25 -0
- kernelport-0.1.0/zoo/embedding_gather/ports/webgpu.py +19 -0
- kernelport-0.1.0/zoo/embedding_gather/reference.py +5 -0
- kernelport-0.1.0/zoo/layernorm/kernel.cu +45 -0
- kernelport-0.1.0/zoo/layernorm/launch.json +33 -0
- kernelport-0.1.0/zoo/layernorm/ports/cpu.py +29 -0
- kernelport-0.1.0/zoo/layernorm/ports/hip.hip +46 -0
- kernelport-0.1.0/zoo/layernorm/ports/metal.py +41 -0
- kernelport-0.1.0/zoo/layernorm/ports/triton.py +43 -0
- kernelport-0.1.0/zoo/layernorm/ports/webgpu.py +39 -0
- kernelport-0.1.0/zoo/layernorm/reference.py +7 -0
- kernelport-0.1.0/zoo/matmul_naive/kernel.cu +16 -0
- kernelport-0.1.0/zoo/matmul_naive/launch.json +29 -0
- kernelport-0.1.0/zoo/matmul_naive/ports/cpu.py +25 -0
- kernelport-0.1.0/zoo/matmul_naive/ports/hip.hip +17 -0
- kernelport-0.1.0/zoo/matmul_naive/ports/metal.py +17 -0
- kernelport-0.1.0/zoo/matmul_naive/ports/triton.py +20 -0
- kernelport-0.1.0/zoo/matmul_naive/ports/webgpu.py +21 -0
- kernelport-0.1.0/zoo/matmul_naive/reference.py +5 -0
- kernelport-0.1.0/zoo/reduce_sum/kernel.cu +22 -0
- kernelport-0.1.0/zoo/reduce_sum/launch.json +25 -0
- kernelport-0.1.0/zoo/reduce_sum/ports/cpu.py +19 -0
- kernelport-0.1.0/zoo/reduce_sum/ports/hip.hip +23 -0
- kernelport-0.1.0/zoo/reduce_sum/ports/metal.py +35 -0
- kernelport-0.1.0/zoo/reduce_sum/ports/triton.py +21 -0
- kernelport-0.1.0/zoo/reduce_sum/ports/webgpu.py +41 -0
- kernelport-0.1.0/zoo/reduce_sum/reference.py +5 -0
- kernelport-0.1.0/zoo/relu/kernel.cu +12 -0
- kernelport-0.1.0/zoo/relu/launch.json +23 -0
- kernelport-0.1.0/zoo/relu/ports/cpu.py +14 -0
- kernelport-0.1.0/zoo/relu/ports/hip.hip +13 -0
- kernelport-0.1.0/zoo/relu/ports/metal.py +14 -0
- kernelport-0.1.0/zoo/relu/ports/triton.py +19 -0
- kernelport-0.1.0/zoo/relu/ports/webgpu.py +17 -0
- kernelport-0.1.0/zoo/relu/reference.py +7 -0
- kernelport-0.1.0/zoo/rmsnorm/kernel.cu +43 -0
- kernelport-0.1.0/zoo/rmsnorm/launch.json +31 -0
- kernelport-0.1.0/zoo/rmsnorm/ports/cpu.py +21 -0
- kernelport-0.1.0/zoo/rmsnorm/ports/hip.hip +34 -0
- kernelport-0.1.0/zoo/rmsnorm/ports/metal.py +29 -0
- kernelport-0.1.0/zoo/rmsnorm/ports/triton.py +34 -0
- kernelport-0.1.0/zoo/rmsnorm/ports/webgpu.py +30 -0
- kernelport-0.1.0/zoo/rmsnorm/reference.py +8 -0
- kernelport-0.1.0/zoo/rope/kernel.cu +27 -0
- kernelport-0.1.0/zoo/rope/launch.json +33 -0
- kernelport-0.1.0/zoo/rope/ports/cpu.py +27 -0
- kernelport-0.1.0/zoo/rope/ports/hip.hip +28 -0
- kernelport-0.1.0/zoo/rope/ports/metal.py +25 -0
- kernelport-0.1.0/zoo/rope/ports/triton.py +35 -0
- kernelport-0.1.0/zoo/rope/ports/webgpu.py +31 -0
- kernelport-0.1.0/zoo/rope/reference.py +13 -0
- kernelport-0.1.0/zoo/saxpy/kernel.cu +11 -0
- kernelport-0.1.0/zoo/saxpy/launch.json +24 -0
- kernelport-0.1.0/zoo/saxpy/ports/cpu.py +13 -0
- kernelport-0.1.0/zoo/saxpy/ports/hip.hip +12 -0
- kernelport-0.1.0/zoo/saxpy/ports/metal.py +13 -0
- kernelport-0.1.0/zoo/saxpy/ports/triton.py +18 -0
- kernelport-0.1.0/zoo/saxpy/ports/webgpu.py +16 -0
- kernelport-0.1.0/zoo/saxpy/reference.py +5 -0
- kernelport-0.1.0/zoo/softmax/kernel.cu +42 -0
- kernelport-0.1.0/zoo/softmax/launch.json +26 -0
- kernelport-0.1.0/zoo/softmax/ports/cpu.py +29 -0
- kernelport-0.1.0/zoo/softmax/ports/hip.hip +43 -0
- kernelport-0.1.0/zoo/softmax/ports/metal.py +37 -0
- kernelport-0.1.0/zoo/softmax/ports/triton.py +45 -0
- kernelport-0.1.0/zoo/softmax/ports/webgpu.py +49 -0
- kernelport-0.1.0/zoo/softmax/reference.py +7 -0
- kernelport-0.1.0/zoo/transpose/kernel.cu +24 -0
- kernelport-0.1.0/zoo/transpose/launch.json +24 -0
- kernelport-0.1.0/zoo/transpose/ports/cpu.py +26 -0
- kernelport-0.1.0/zoo/transpose/ports/hip.hip +25 -0
- kernelport-0.1.0/zoo/transpose/ports/metal.py +26 -0
- kernelport-0.1.0/zoo/transpose/ports/triton.py +23 -0
- kernelport-0.1.0/zoo/transpose/ports/webgpu.py +30 -0
- kernelport-0.1.0/zoo/transpose/reference.py +5 -0
- kernelport-0.1.0/zoo/vector_add/kernel.cu +12 -0
- kernelport-0.1.0/zoo/vector_add/launch.json +27 -0
- kernelport-0.1.0/zoo/vector_add/ports/cpu.py +13 -0
- kernelport-0.1.0/zoo/vector_add/ports/hip.hip +13 -0
- kernelport-0.1.0/zoo/vector_add/ports/metal.py +13 -0
- kernelport-0.1.0/zoo/vector_add/ports/triton.py +19 -0
- kernelport-0.1.0/zoo/vector_add/ports/webgpu.py +21 -0
- kernelport-0.1.0/zoo/vector_add/reference.py +5 -0
|
@@ -0,0 +1,134 @@
|
|
|
1
|
+
name: CI
|
|
2
|
+
|
|
3
|
+
on:
|
|
4
|
+
push:
|
|
5
|
+
branches: [main]
|
|
6
|
+
pull_request:
|
|
7
|
+
workflow_dispatch:
|
|
8
|
+
|
|
9
|
+
concurrency:
|
|
10
|
+
# PRs: newest push wins. main: one group per commit, so every commit gets a full run.
|
|
11
|
+
group: ci-${{ github.event_name == 'pull_request' && github.ref || github.sha }}
|
|
12
|
+
cancel-in-progress: ${{ github.event_name == 'pull_request' }}
|
|
13
|
+
|
|
14
|
+
jobs:
|
|
15
|
+
test:
|
|
16
|
+
# CPU-only: analyzer, harness, reports, MCP protocol, setup, CPU (Numba) backend,
|
|
17
|
+
# and the fake-runtime contract tests for metal / hip / agent. GPU tests skip.
|
|
18
|
+
name: tests (${{ matrix.os }})
|
|
19
|
+
runs-on: ${{ matrix.os }}
|
|
20
|
+
strategy:
|
|
21
|
+
fail-fast: false
|
|
22
|
+
matrix:
|
|
23
|
+
os: [ubuntu-latest, windows-latest, macos-latest]
|
|
24
|
+
steps:
|
|
25
|
+
- uses: actions/checkout@v4
|
|
26
|
+
- uses: actions/setup-python@v5
|
|
27
|
+
with:
|
|
28
|
+
python-version: "3.12"
|
|
29
|
+
cache: pip
|
|
30
|
+
- name: Install (CPU torch)
|
|
31
|
+
run: |
|
|
32
|
+
python -m pip install --upgrade pip
|
|
33
|
+
python -m pip install torch --index-url https://download.pytorch.org/whl/cpu
|
|
34
|
+
python -m pip install -e ".[cpu,dev]"
|
|
35
|
+
- name: kernelport doctor
|
|
36
|
+
run: kernelport doctor
|
|
37
|
+
- name: Tests
|
|
38
|
+
run: python -m pytest -q -rs
|
|
39
|
+
|
|
40
|
+
metal:
|
|
41
|
+
# GitHub's macOS arm64 runners are Apple Silicon VMs ("Apple M1 (Virtual)") with a real
|
|
42
|
+
# Metal device, so every zoo metal port is verified for real on each push. The originals
|
|
43
|
+
# show UNVERIFIED here (no CUDA); the ports are checked against the stored references.
|
|
44
|
+
name: metal zoo (macos arm64, MLX)
|
|
45
|
+
runs-on: macos-14
|
|
46
|
+
steps:
|
|
47
|
+
- uses: actions/checkout@v4
|
|
48
|
+
- uses: actions/setup-python@v5
|
|
49
|
+
with:
|
|
50
|
+
python-version: "3.12"
|
|
51
|
+
cache: pip
|
|
52
|
+
- name: Install
|
|
53
|
+
run: |
|
|
54
|
+
python -m pip install --upgrade pip
|
|
55
|
+
python -m pip install -e ".[metal,dev]"
|
|
56
|
+
- name: MLX device
|
|
57
|
+
# Fail loudly rather than letting the Mac tests skip if the runner loses its Metal device.
|
|
58
|
+
run: python -c "import mlx.core as mx; print(mx.default_device()); assert mx.metal.is_available()"
|
|
59
|
+
- name: Metal backend tests
|
|
60
|
+
run: python -m pytest -q -rs tests/test_metal_backend.py
|
|
61
|
+
- name: Metal zoo
|
|
62
|
+
run: kernelport zoo --backend metal --no-bench
|
|
63
|
+
- name: llm.c example (Metal ports vs references frozen on NVIDIA)
|
|
64
|
+
working-directory: examples/llm.c
|
|
65
|
+
run: |
|
|
66
|
+
kernelport verify --backend metal
|
|
67
|
+
kernelport status
|
|
68
|
+
- uses: actions/upload-artifact@v4
|
|
69
|
+
with:
|
|
70
|
+
name: llmc-results-metal
|
|
71
|
+
path: examples/llm.c/.kernelport/kernels/*/ports/metal/results/*.json
|
|
72
|
+
|
|
73
|
+
webgpu:
|
|
74
|
+
# WGSL ports through wgpu-native: Mesa llvmpipe (software Vulkan) on Linux, Metal on macOS.
|
|
75
|
+
# Cases larger than an adapter's binding limit are reported as not tested, not as FAIL.
|
|
76
|
+
name: webgpu zoo (${{ matrix.os }})
|
|
77
|
+
runs-on: ${{ matrix.os }}
|
|
78
|
+
strategy:
|
|
79
|
+
fail-fast: false
|
|
80
|
+
matrix:
|
|
81
|
+
os: [ubuntu-latest, macos-14]
|
|
82
|
+
steps:
|
|
83
|
+
- uses: actions/checkout@v4
|
|
84
|
+
- uses: actions/setup-python@v5
|
|
85
|
+
with:
|
|
86
|
+
python-version: "3.12"
|
|
87
|
+
cache: pip
|
|
88
|
+
- name: Vulkan (lavapipe)
|
|
89
|
+
if: runner.os == 'Linux'
|
|
90
|
+
run: sudo apt-get update -q && sudo apt-get install -y -q mesa-vulkan-drivers
|
|
91
|
+
- name: Install
|
|
92
|
+
run: |
|
|
93
|
+
python -m pip install --upgrade pip
|
|
94
|
+
python -m pip install torch --index-url https://download.pytorch.org/whl/cpu
|
|
95
|
+
python -m pip install -e ".[webgpu,dev]"
|
|
96
|
+
- name: Adapter
|
|
97
|
+
run: python -c "import wgpu; a = wgpu.gpu.request_adapter_sync(); print(a.info); print(sorted(a.features))"
|
|
98
|
+
- name: WebGPU backend tests
|
|
99
|
+
run: python -m pytest -q -rs tests/test_webgpu_backend.py
|
|
100
|
+
- name: WebGPU zoo
|
|
101
|
+
run: kernelport zoo --backend webgpu --no-bench
|
|
102
|
+
- name: llm.c example (WGSL ports vs references frozen on NVIDIA)
|
|
103
|
+
working-directory: examples/llm.c
|
|
104
|
+
run: |
|
|
105
|
+
kernelport verify --backend webgpu
|
|
106
|
+
kernelport status
|
|
107
|
+
- uses: actions/upload-artifact@v4
|
|
108
|
+
with:
|
|
109
|
+
name: llmc-results-webgpu-${{ matrix.os }}
|
|
110
|
+
path: examples/llm.c/.kernelport/kernels/*/ports/webgpu/results/*.json
|
|
111
|
+
|
|
112
|
+
package:
|
|
113
|
+
name: build sdist + wheel
|
|
114
|
+
runs-on: ubuntu-latest
|
|
115
|
+
steps:
|
|
116
|
+
- uses: actions/checkout@v4
|
|
117
|
+
- uses: actions/setup-python@v5
|
|
118
|
+
with:
|
|
119
|
+
python-version: "3.12"
|
|
120
|
+
- name: Build
|
|
121
|
+
run: |
|
|
122
|
+
python -m pip install --upgrade pip build twine
|
|
123
|
+
python -m build
|
|
124
|
+
python -m twine check dist/*
|
|
125
|
+
- name: Smoke test the wheel (core install, no torch)
|
|
126
|
+
run: |
|
|
127
|
+
python -m venv /tmp/wheel-env
|
|
128
|
+
/tmp/wheel-env/bin/pip install dist/*.whl
|
|
129
|
+
cd /tmp && /tmp/wheel-env/bin/kernelport --help
|
|
130
|
+
/tmp/wheel-env/bin/python -c "import kernelport.mcp_server, kernelport.tools"
|
|
131
|
+
- uses: actions/upload-artifact@v4
|
|
132
|
+
with:
|
|
133
|
+
name: dist
|
|
134
|
+
path: dist/
|
|
@@ -0,0 +1,44 @@
|
|
|
1
|
+
name: Release
|
|
2
|
+
|
|
3
|
+
# Publishes to PyPI when a version tag (v0.1.0, ...) is pushed.
|
|
4
|
+
# One-time setup on pypi.org: add a "trusted publisher" for this repo with
|
|
5
|
+
# workflow file "release.yml" and environment "pypi". No API token is stored here.
|
|
6
|
+
|
|
7
|
+
on:
|
|
8
|
+
push:
|
|
9
|
+
tags: ["v*"]
|
|
10
|
+
|
|
11
|
+
jobs:
|
|
12
|
+
build:
|
|
13
|
+
runs-on: ubuntu-latest
|
|
14
|
+
steps:
|
|
15
|
+
- uses: actions/checkout@v4
|
|
16
|
+
- uses: actions/setup-python@v5
|
|
17
|
+
with:
|
|
18
|
+
python-version: "3.12"
|
|
19
|
+
- name: Check tag matches version
|
|
20
|
+
run: |
|
|
21
|
+
v=$(python -c "import tomllib; print(tomllib.load(open('pyproject.toml','rb'))['project']['version'])")
|
|
22
|
+
test "v$v" = "${GITHUB_REF_NAME}" || { echo "tag ${GITHUB_REF_NAME} != pyproject version $v"; exit 1; }
|
|
23
|
+
- name: Build
|
|
24
|
+
run: |
|
|
25
|
+
python -m pip install --upgrade pip build twine
|
|
26
|
+
python -m build
|
|
27
|
+
python -m twine check dist/*
|
|
28
|
+
- uses: actions/upload-artifact@v4
|
|
29
|
+
with:
|
|
30
|
+
name: dist
|
|
31
|
+
path: dist/
|
|
32
|
+
|
|
33
|
+
publish:
|
|
34
|
+
needs: build
|
|
35
|
+
runs-on: ubuntu-latest
|
|
36
|
+
environment: pypi
|
|
37
|
+
permissions:
|
|
38
|
+
id-token: write
|
|
39
|
+
steps:
|
|
40
|
+
- uses: actions/download-artifact@v4
|
|
41
|
+
with:
|
|
42
|
+
name: dist
|
|
43
|
+
path: dist/
|
|
44
|
+
- uses: pypa/gh-action-pypi-publish@release/v1
|
|
@@ -0,0 +1,118 @@
|
|
|
1
|
+
# kernelport: status and launch plan
|
|
2
|
+
|
|
3
|
+
*Written 2026-10-13, at commit `a376f38`. Updated 2026-10-14: Metal verified in CI, CI + release
|
|
4
|
+
workflow, Colab freeze flow, autotuning.*
|
|
5
|
+
|
|
6
|
+
## Where we are
|
|
7
|
+
|
|
8
|
+
**About 85% of the way to a solid public v0.1, and roughly 60% of a mature product.**
|
|
9
|
+
All 16 planned milestones (M0–M16) are built, committed and pushed. The test suite has
|
|
10
|
+
262 passing and 43 skipped locally (the skips need a Mac, an AMD GPU, or the optional `wgpu`
|
|
11
|
+
package). CI runs the CPU suite on Linux, macOS and Windows and the Metal zoo on Apple Silicon.
|
|
12
|
+
What's left is mostly real-world proof and polish, not features.
|
|
13
|
+
|
|
14
|
+
### Backend status
|
|
15
|
+
|
|
16
|
+
| Backend | Status | Zoo ports passing |
|
|
17
|
+
|---|---|---|
|
|
18
|
+
| Triton | working, verified on an RTX 5060 Laptop GPU | 12/12 (fp32, fp16, bf16); 1.0–1.3× the original CUDA, matmul 6.2× |
|
|
19
|
+
| CPU (Numba) | working, verified | 12/12 (fp32) |
|
|
20
|
+
| WebGPU (WGSL via wgpu-native) | working, verified on the RTX 5060 through Vulkan | 12/12 (fp32, fp16) |
|
|
21
|
+
| Metal (MLX) | working, verified in CI on an Apple M1 (GitHub macOS runner) | 12/12 (fp32, fp16, bf16) |
|
|
22
|
+
| HIP (hipRTC) | runner and ports written, launch path tested on NVIDIA, **not verified on AMD** | 12 written |
|
|
23
|
+
|
|
24
|
+
### What has been tested
|
|
25
|
+
|
|
26
|
+
- Full workflow through the real MCP server (dogfood): 3/3 references frozen on the first try,
|
|
27
|
+
6/6 ports PASS, 2 needed one repair each, both diagnosed from the failure report.
|
|
28
|
+
- `kernelport setup` against a real Claude Code install (server connected, skill discovered),
|
|
29
|
+
then `--uninstall`; `~/.claude.json` was confirmed identical to the pre-setup snapshot.
|
|
30
|
+
- Deliberately broken ports for every working backend fail for the right reason.
|
|
31
|
+
- The built-in agent (`kernelport agent`) is tested only with a scripted fake client.
|
|
32
|
+
No live API calls have been made.
|
|
33
|
+
|
|
34
|
+
## Must fix before launch
|
|
35
|
+
|
|
36
|
+
1. ~~**Verify Metal on an Apple Silicon Mac.**~~ **Done 2026-10-14.** GitHub's macOS arm64 runners
|
|
37
|
+
have a real Metal device; all 12 zoo ports pass every case and CI re-checks them on every push.
|
|
38
|
+
(Still worth one run on a physical Mac for timings, which a virtualized runner cannot give.)
|
|
39
|
+
2. ~~**Fresh-agent dogfood.**~~ **Done 2026-10-14:** 4/4 kernels PASS on the first verify; its feedback
|
|
40
|
+
is fixed (see PROGRESS.md). Still worth repeating with Codex / Cursor. So far a person (who already knew the kernels) drove the tools.
|
|
41
|
+
Give a clean Claude Code or Codex session only "port the CUDA kernels in this repo to
|
|
42
|
+
Triton and verify them" and record pass rate, attempts, and where the skill was unclear.
|
|
43
|
+
3. **Easy install.**
|
|
44
|
+
- Publish to PyPI. The name `kernelport` was free on 2026-10-14; `release.yml` publishes on a `v*`
|
|
45
|
+
tag once a trusted publisher is set up on pypi.org (owner action).
|
|
46
|
+
- ~~GitHub Actions CI: CPU-only tests on Linux, macOS and Windows.~~ Done.
|
|
47
|
+
- A one-line install path. Today the CUDA build of torch has to come from the PyTorch index first.
|
|
48
|
+
- Only Windows has been tested so far.
|
|
49
|
+
4. **Make the NVIDIA reference step easy to work around.** Validating a reference runs the
|
|
50
|
+
original CUDA kernel, so it needs an NVIDIA GPU, and the main target audience (Mac users)
|
|
51
|
+
often has none. Options:
|
|
52
|
+
- ~~document "validate once on a GPU machine or free Colab, commit `.kernelport/`, verify anywhere"~~ Done
|
|
53
|
+
(docs/installation.md, and the skill tells agents what to do on UNAVAILABLE);
|
|
54
|
+
- ~~ship a Colab notebook that validates and freezes references for a repo~~ Done:
|
|
55
|
+
`notebooks/freeze_references_colab.ipynb` + `kernelport validate --all` (not yet run on Colab itself).
|
|
56
|
+
5. ~~**Prove it on real code.**~~ **Done 2026-10-14:** `examples/llm.c`, five unmodified llm.c kernels
|
|
57
|
+
(host code, cuBLAS headers, macros, `Packed128` templates) validated, ported to Triton (NVIDIA) and
|
|
58
|
+
Metal (CI), plus a real precondition bug found. Still open: a multi-file project that calls
|
|
59
|
+
cuBLAS from kernels' callers, and kernels generated by macros (the slicer and analyzer are lexical).
|
|
60
|
+
|
|
61
|
+
## Would make it noticeably better
|
|
62
|
+
|
|
63
|
+
- ~~**Autotuning after PASS**~~ Done: `tune_port` / `kernelport tune` verifies every variant and only
|
|
64
|
+
keeps a clear, noise-resistant win.
|
|
65
|
+
- **Browser demo page:** paste a CUDA kernel and watch the WGSL port get verified on your own GPU.
|
|
66
|
+
- **A report worth screenshotting:** the HTML report is what people will share.
|
|
67
|
+
- **A HIP run on AMD**, for example on a rented cloud GPU.
|
|
68
|
+
- **Browser check for WGSL ports** (Playwright and Chromium, about 150 MB) to confirm they
|
|
69
|
+
also pass in Chrome, not just wgpu-native.
|
|
70
|
+
- **Live smoke test of `kernelport agent`** (needs an API key; costs credits).
|
|
71
|
+
|
|
72
|
+
## Could it trend on GitHub?
|
|
73
|
+
|
|
74
|
+
**It has a real chance, but only with a deliberate launch.** Nothing reaches trending just by
|
|
75
|
+
being pushed.
|
|
76
|
+
|
|
77
|
+
**In its favour**
|
|
78
|
+
- The hook is timely: CUDA lock-in, Apple Silicon and AI coding agents are all hot topics.
|
|
79
|
+
- A distinctive angle. Existing CUDA-portability tools (HIPIFY, ZLUDA, SCALE, chipStar) are
|
|
80
|
+
translators or compatibility layers. As far as I know, none combine agents writing the ports
|
|
81
|
+
with a harness that refuses to say PASS without proof on real hardware.
|
|
82
|
+
Pitch: **"proven correct, not just translated."**
|
|
83
|
+
- Agent-native: one-command `kernelport setup` for Claude Code, Codex, Cursor and Gemini CLI
|
|
84
|
+
makes "try it in 2 minutes" believable.
|
|
85
|
+
|
|
86
|
+
**Against it**
|
|
87
|
+
- Without a demo it's an abstract developer tool.
|
|
88
|
+
- The NVIDIA-for-validation requirement can confuse the target audience.
|
|
89
|
+
- Some people are sceptical of "AI ports your code". The verification angle answers that, so lead with it.
|
|
90
|
+
|
|
91
|
+
### What gets repos onto trending
|
|
92
|
+
|
|
93
|
+
1. **A 30–60 s demo video or GIF:** clone a CUDA-only repo, one prompt, a green report with
|
|
94
|
+
kernels passing on a MacBook.
|
|
95
|
+
2. **A recognisable target:** "we ran X's CUDA kernels on a Mac, verified" beats "12 zoo kernels".
|
|
96
|
+
3. **Launch posts on the same day:** Show HN, r/LocalLLaMA, r/MachineLearning, and X
|
|
97
|
+
(tag the MLX and Triton communities). Trending is driven by stars per day, so concentrated
|
|
98
|
+
attention beats a slow trickle.
|
|
99
|
+
4. **A README that sells in 10 seconds:** demo GIF at the top, three-line quick start, the
|
|
100
|
+
results table. The content exists; it needs the visual.
|
|
101
|
+
|
|
102
|
+
## Suggested order
|
|
103
|
+
|
|
104
|
+
1. ~~CI + PyPI packaging~~ (CI done; PyPI waits on the trusted-publisher setup)
|
|
105
|
+
2. ~~Fresh-agent dogfood run~~ (done)
|
|
106
|
+
3. ~~Mac verification run~~ (done in CI)
|
|
107
|
+
4. ~~Port one well-known CUDA-only project end to end~~ (llm.c, done)
|
|
108
|
+
5. Demo GIF and README polish
|
|
109
|
+
6. Launch (same-day posts)
|
|
110
|
+
|
|
111
|
+
## Rules kept during development
|
|
112
|
+
|
|
113
|
+
- No large downloads; anything downloaded for testing is uninstalled afterwards (`wgpu` was,
|
|
114
|
+
so WebGPU tests skip until `pip install kernelport[webgpu]`).
|
|
115
|
+
- No API credits spent.
|
|
116
|
+
- Any edit to real agent config (`~/.claude.json`) is reverted after testing.
|
|
117
|
+
|
|
118
|
+
Full technical history and resume notes: [PROGRESS.md](PROGRESS.md).
|
kernelport-0.1.0/LICENSE
ADDED
|
@@ -0,0 +1,21 @@
|
|
|
1
|
+
MIT License
|
|
2
|
+
|
|
3
|
+
Copyright (c) 2026 kernelport contributors
|
|
4
|
+
|
|
5
|
+
Permission is hereby granted, free of charge, to any person obtaining a copy
|
|
6
|
+
of this software and associated documentation files (the "Software"), to deal
|
|
7
|
+
in the Software without restriction, including without limitation the rights
|
|
8
|
+
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
|
|
9
|
+
copies of the Software, and to permit persons to whom the Software is
|
|
10
|
+
furnished to do so, subject to the following conditions:
|
|
11
|
+
|
|
12
|
+
The above copyright notice and this permission notice shall be included in all
|
|
13
|
+
copies or substantial portions of the Software.
|
|
14
|
+
|
|
15
|
+
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
|
|
16
|
+
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
|
|
17
|
+
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
|
|
18
|
+
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
|
|
19
|
+
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
|
|
20
|
+
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
|
|
21
|
+
SOFTWARE.
|
|
@@ -0,0 +1,228 @@
|
|
|
1
|
+
Metadata-Version: 2.5
|
|
2
|
+
Name: kernelport
|
|
3
|
+
Version: 0.1.0
|
|
4
|
+
Summary: Bring CUDA-only kernels to Mac, AMD, browsers, and CPU, with proof they are correct.
|
|
5
|
+
Project-URL: Homepage, https://github.com/PS12007/kernelport
|
|
6
|
+
Project-URL: Documentation, https://github.com/PS12007/kernelport/tree/main/docs
|
|
7
|
+
Project-URL: Issues, https://github.com/PS12007/kernelport/issues
|
|
8
|
+
Author: kernelport contributors
|
|
9
|
+
License-Expression: MIT
|
|
10
|
+
License-File: LICENSE
|
|
11
|
+
Keywords: cuda,gpu,hip,kernels,mcp,metal,triton,webgpu
|
|
12
|
+
Classifier: Development Status :: 3 - Alpha
|
|
13
|
+
Classifier: Intended Audience :: Developers
|
|
14
|
+
Classifier: Intended Audience :: Science/Research
|
|
15
|
+
Classifier: Operating System :: OS Independent
|
|
16
|
+
Classifier: Programming Language :: Python :: 3
|
|
17
|
+
Classifier: Programming Language :: Python :: 3.11
|
|
18
|
+
Classifier: Programming Language :: Python :: 3.12
|
|
19
|
+
Classifier: Programming Language :: Python :: 3.13
|
|
20
|
+
Classifier: Topic :: Scientific/Engineering :: Artificial Intelligence
|
|
21
|
+
Classifier: Topic :: Software Development :: Compilers
|
|
22
|
+
Requires-Python: >=3.11
|
|
23
|
+
Requires-Dist: mcp>=2.0
|
|
24
|
+
Requires-Dist: numpy>=1.26
|
|
25
|
+
Requires-Dist: rich>=13
|
|
26
|
+
Requires-Dist: typer>=0.12
|
|
27
|
+
Provides-Extra: agent
|
|
28
|
+
Requires-Dist: anthropic>=0.40; extra == 'agent'
|
|
29
|
+
Provides-Extra: all
|
|
30
|
+
Requires-Dist: anthropic>=0.40; extra == 'all'
|
|
31
|
+
Requires-Dist: cupy-cuda12x>=13; extra == 'all'
|
|
32
|
+
Requires-Dist: mlx>=0.22; (sys_platform == 'darwin') and extra == 'all'
|
|
33
|
+
Requires-Dist: numba>=0.60; extra == 'all'
|
|
34
|
+
Requires-Dist: nvidia-cuda-nvrtc-cu12; extra == 'all'
|
|
35
|
+
Requires-Dist: nvidia-cuda-runtime-cu12; extra == 'all'
|
|
36
|
+
Requires-Dist: pytest>=8; extra == 'all'
|
|
37
|
+
Requires-Dist: torch>=2.4; extra == 'all'
|
|
38
|
+
Requires-Dist: torch>=2.7; extra == 'all'
|
|
39
|
+
Requires-Dist: triton-windows>=3.3; (sys_platform == 'win32') and extra == 'all'
|
|
40
|
+
Requires-Dist: triton>=3.3; (sys_platform == 'linux') and extra == 'all'
|
|
41
|
+
Requires-Dist: wgpu>=0.30; extra == 'all'
|
|
42
|
+
Provides-Extra: cpu
|
|
43
|
+
Requires-Dist: numba>=0.60; extra == 'cpu'
|
|
44
|
+
Requires-Dist: torch>=2.4; extra == 'cpu'
|
|
45
|
+
Provides-Extra: cuda
|
|
46
|
+
Requires-Dist: cupy-cuda12x>=13; extra == 'cuda'
|
|
47
|
+
Requires-Dist: nvidia-cuda-nvrtc-cu12; extra == 'cuda'
|
|
48
|
+
Requires-Dist: nvidia-cuda-runtime-cu12; extra == 'cuda'
|
|
49
|
+
Requires-Dist: torch>=2.7; extra == 'cuda'
|
|
50
|
+
Provides-Extra: dev
|
|
51
|
+
Requires-Dist: pytest>=8; extra == 'dev'
|
|
52
|
+
Provides-Extra: hip
|
|
53
|
+
Requires-Dist: torch>=2.4; extra == 'hip'
|
|
54
|
+
Provides-Extra: metal
|
|
55
|
+
Requires-Dist: mlx>=0.22; (sys_platform == 'darwin') and extra == 'metal'
|
|
56
|
+
Requires-Dist: torch>=2.4; extra == 'metal'
|
|
57
|
+
Provides-Extra: ref
|
|
58
|
+
Requires-Dist: torch>=2.4; extra == 'ref'
|
|
59
|
+
Provides-Extra: triton
|
|
60
|
+
Requires-Dist: torch>=2.7; extra == 'triton'
|
|
61
|
+
Requires-Dist: triton-windows>=3.3; (sys_platform == 'win32') and extra == 'triton'
|
|
62
|
+
Requires-Dist: triton>=3.3; (sys_platform == 'linux') and extra == 'triton'
|
|
63
|
+
Provides-Extra: webgpu
|
|
64
|
+
Requires-Dist: torch>=2.4; extra == 'webgpu'
|
|
65
|
+
Requires-Dist: wgpu>=0.30; extra == 'webgpu'
|
|
66
|
+
Description-Content-Type: text/markdown
|
|
67
|
+
|
|
68
|
+
# kernelport
|
|
69
|
+
|
|
70
|
+
[](https://github.com/PS12007/kernelport/actions/workflows/ci.yml)
|
|
71
|
+
|
|
72
|
+
Bring CUDA-only kernels to Mac, AMD, browsers, and CPU, with proof they are correct.
|
|
73
|
+
|
|
74
|
+
kernelport is an **MCP server + agent skill + CLI**. Your coding agent (Claude Code, Codex,
|
|
75
|
+
Cursor, Gemini CLI) writes the ports; kernelport runs them on real hardware and checks every
|
|
76
|
+
one against a reference that was itself validated against the original CUDA kernel. A port is
|
|
77
|
+
only ever reported as **PASS** if its current code ran on real hardware and matched.
|
|
78
|
+
|
|
79
|
+
> Status: early release (0.1.0). Triton, CPU and WebGPU backends work and are verified;
|
|
80
|
+
> Metal is verified on Apple Silicon in CI; the HIP runner and zoo ports are written but not yet
|
|
81
|
+
> verified on an AMD GPU. See [PROGRESS.md](https://github.com/PS12007/kernelport/blob/main/PROGRESS.md).
|
|
82
|
+
|
|
83
|
+
|
|
84
|
+
|
|
85
|
+
*Real code, real hardware: [examples/llm.c](https://github.com/PS12007/kernelport/tree/main/examples/llm.c).*
|
|
86
|
+
|
|
87
|
+
## How it works
|
|
88
|
+
|
|
89
|
+
```
|
|
90
|
+
your repo: kernels/*.cu
|
|
91
|
+
│ scan_kernels (lexical CUDA analyzer: params, kinds, features)
|
|
92
|
+
▼
|
|
93
|
+
PyTorch reference + input spec written by the agent
|
|
94
|
+
│ validate_reference runs the ORIGINAL CUDA kernel on every case
|
|
95
|
+
▼
|
|
96
|
+
frozen reference (sha256 manifest) only a passing validation can freeze it
|
|
97
|
+
│ write_port / verify_port port vs frozen reference, every case and dtype
|
|
98
|
+
▼
|
|
99
|
+
PASS / FAIL (+ compact failure report) / UNVERIFIED (backend not available here)
|
|
100
|
+
│ bench_port only after PASS on this machine
|
|
101
|
+
▼
|
|
102
|
+
report.html / report.md
|
|
103
|
+
```
|
|
104
|
+
|
|
105
|
+
The agent never sets tolerances, never edits the frozen reference, and gets at most 6 failed
|
|
106
|
+
verification attempts per port. Those rules are enforced in the tools, not just in the
|
|
107
|
+
skill. Details: [docs/how-it-works.md](https://github.com/PS12007/kernelport/blob/main/docs/how-it-works.md).
|
|
108
|
+
|
|
109
|
+
## Quick start
|
|
110
|
+
|
|
111
|
+
```bash
|
|
112
|
+
# 1. install (CUDA build of torch first; see docs/installation.md)
|
|
113
|
+
pip install --index-url https://download.pytorch.org/whl/cu128 torch
|
|
114
|
+
pip install "kernelport[cuda,triton,cpu] @ git+https://github.com/PS12007/kernelport"
|
|
115
|
+
|
|
116
|
+
# 2. check what can run here
|
|
117
|
+
kernelport doctor
|
|
118
|
+
|
|
119
|
+
# 3. register the MCP server and skill with your agents (shows every change, asks first)
|
|
120
|
+
kernelport setup # --print to only show instructions, --uninstall to undo
|
|
121
|
+
```
|
|
122
|
+
|
|
123
|
+
Then, in your repo, ask your agent:
|
|
124
|
+
|
|
125
|
+
> port the CUDA kernels in this repo to Triton and verify them
|
|
126
|
+
|
|
127
|
+
## Real code: llm.c's CUDA kernels on a Mac
|
|
128
|
+
|
|
129
|
+
[`examples/llm.c`](https://github.com/PS12007/kernelport/tree/main/examples/llm.c) takes nine kernels from Karpathy's
|
|
130
|
+
[llm.c](https://github.com/karpathy/llm.c) `dev/cuda/` (unmodified files, host code and all):
|
|
131
|
+
layernorm, GELU, residual, encoder, online softmax, AdamW and cross-entropy, including bf16 and
|
|
132
|
+
128-bit packed loads. References were validated against the original CUDA kernels and frozen on
|
|
133
|
+
an RTX 5060, and all nine Triton ports pass there. The Metal ports pass on Apple Silicon in CI
|
|
134
|
+
against those same frozen references. Four of the nine were ported by a fresh coding agent
|
|
135
|
+
given only the one-line request and kernelport's guide; each of its ports passed on the first
|
|
136
|
+
verification. Validation also found an undocumented precondition in llm.c:
|
|
137
|
+
`softmax_forward_online_kernel8` leaves rows unwritten when C < block size.
|
|
138
|
+
|
|
139
|
+
## Backends
|
|
140
|
+
|
|
141
|
+
| backend | port language | runs on | status |
|
|
142
|
+
|---|---|---|---|---|
|
|
143
|
+
| `triton` | Triton (Python) | NVIDIA (triton / triton-windows), AMD ROCm | working |
|
|
144
|
+
| `cpu` | Numba (Python) | any machine | working (float32/float64) |
|
|
145
|
+
| `metal` | Metal kernel bodies via MLX `metal_kernel` | Apple Silicon | working (float32/float16/bfloat16), verified in CI on an Apple M1 |
|
|
146
|
+
| `webgpu` | WGSL | any Vulkan / Metal / D3D12 GPU via wgpu-native (core WebGPU only, so browser-portable) | working (float32/float16); verified on NVIDIA (Vulkan), Apple (Metal) and llvmpipe (software Vulkan) |
|
|
147
|
+
| `hip` | HIP C++ via hipRTC (CuPy ROCm) | AMD ROCm | written, launch path tested on NVIDIA, **not yet verified on AMD** |
|
|
148
|
+
|
|
149
|
+
Ports for a backend that is not available on the current machine are saved as **UNVERIFIED**,
|
|
150
|
+
never PASS. Commit `.kernelport/` and run `kernelport verify` on the right machine to verify them there.
|
|
151
|
+
|
|
152
|
+
## No coding agent? Use the built-in one (optional)
|
|
153
|
+
|
|
154
|
+
```bash
|
|
155
|
+
pip install "kernelport[agent] @ git+https://github.com/PS12007/kernelport"
|
|
156
|
+
export ANTHROPIC_API_KEY=... # or: ant auth login
|
|
157
|
+
kernelport agent "port the CUDA kernels in this repo to Triton and verify them"
|
|
158
|
+
```
|
|
159
|
+
|
|
160
|
+
`kernelport agent` runs Claude (default `claude-opus-5-5`) in a tool-use loop over the same 12
|
|
161
|
+
tools the MCP server exposes, with the workflow skill as its system prompt. It can only act
|
|
162
|
+
through those tools, so all writes stay in `.kernelport/` and it cannot run shell commands.
|
|
163
|
+
Runs are billed to **your** Anthropic account, so it asks before starting (`--yes` skips the
|
|
164
|
+
prompt). The run stops at `--max-turns` (default 80). Server-side refusal fallbacks are on by
|
|
165
|
+
default (`--no-fallbacks` to disable).
|
|
166
|
+
|
|
167
|
+
## The kernel zoo
|
|
168
|
+
|
|
169
|
+
`zoo/` holds 12 CUDA kernels with launch specs and references: vector_add, relu, saxpy,
|
|
170
|
+
transpose, reduce_sum, softmax, layernorm, rmsnorm, matmul_naive, rope, embedding_gather and
|
|
171
|
+
cumsum. Between them they use templates, shared memory, `__syncthreads`, warp shuffles,
|
|
172
|
+
atomics, block reductions, scans, gathers and int64 indices. Every original passes its reference.
|
|
173
|
+
`kernelport zoo --backend triton|cpu` validates them and verifies the stored ports.
|
|
174
|
+
|
|
175
|
+
Measured on an RTX 5060 Laptop GPU (sm_120) and an i7-14700HX (28 threads), bench case of each spec
|
|
176
|
+
(the largest), float32. Every stored port passes every case: Triton in fp32/fp16/bf16, cpu in fp32, webgpu in fp32/fp16, metal in fp32/fp16/bf16 (on an Apple M1 GitHub Actions runner, checked on every push; no timings, a virtualized runner is not a fair benchmark). CI also runs the WGSL ports on Apple Metal and on llvmpipe; there the largest embedding_gather cases exceed those adapters' binding limits (128 MiB on llvmpipe) and are reported as not tested.
|
|
177
|
+
|
|
178
|
+
| kernel | triton vs original CUDA | cpu (Numba) | webgpu (WGSL) | metal (MLX) |
|
|
179
|
+
|---|---|---|---|---|
|
|
180
|
+
| vector_add | PASS, 1.00x | PASS, 7.8 ms (n/c) | PASS, 1.12 ms (n/c) | PASS |
|
|
181
|
+
| relu | PASS, 1.04x | PASS, 5.7 ms (n/c) | PASS, 1.06 ms (n/c) | PASS |
|
|
182
|
+
| saxpy | PASS, 1.00x | PASS, 6.4 ms (n/c) | PASS, 1.08 ms (n/c) | PASS |
|
|
183
|
+
| transpose | PASS, 1.00x | PASS, 11.2 ms (n/c) | PASS, 1.06 ms (n/c) | PASS |
|
|
184
|
+
| reduce_sum | PASS, 1.04x | PASS, 3.4 ms (n/c) | PASS, 0.58 ms (n/c) | PASS |
|
|
185
|
+
| softmax | PASS, 1.00x | PASS, 35.5 ms (n/c) | PASS, 0.67 ms (n/c) | PASS |
|
|
186
|
+
| layernorm | PASS, 1.00x | PASS, 9.1 ms (n/c) | PASS, 0.96 ms (n/c) | PASS |
|
|
187
|
+
| rmsnorm | PASS, 1.00x | PASS, 7.0 ms (n/c) | PASS, 1.13 ms (n/c) | PASS |
|
|
188
|
+
| matmul_naive | PASS, 6.20x (tiled `tl.dot`, IEEE fp32) | PASS, 40.3 ms (n/c) | PASS, 4.21 ms (n/c) | PASS |
|
|
189
|
+
| rope | PASS, 1.00x | PASS, 13.1 ms (n/c) | PASS, 1.42 ms (n/c) | PASS |
|
|
190
|
+
| embedding_gather | PASS, 1.02x | PASS, 11.8 ms (n/c) | PASS, 1.46 ms (n/c) | PASS |
|
|
191
|
+
| cumsum | PASS, 1.30x | PASS, 6.9 ms (n/c) | PASS, 1.18 ms (n/c) | PASS |
|
|
192
|
+
|
|
193
|
+
(n/c = wall-clock time (CPU, or WebGPU including submission), not comparable to GPU kernel time.)
|
|
194
|
+
|
|
195
|
+
## CLI
|
|
196
|
+
|
|
197
|
+
Every MCP tool has a CLI equivalent, so you can drive the workflow by hand or from CI:
|
|
198
|
+
|
|
199
|
+
| command | MCP tool | what it does |
|
|
200
|
+
|---|---|---|
|
|
201
|
+
| `kernelport doctor` | `kernelport_doctor` | OS, GPU, extras, each backend with a reason |
|
|
202
|
+
| `kernelport scan [path]` | `scan_kernels` | find `__global__` kernels (also CUDA strings in .py) |
|
|
203
|
+
| `kernelport read <id>` | `read_kernel` | source, parsed signature, suggested input spec |
|
|
204
|
+
| `kernelport skill [name]` | `read_skill` | workflow, common_bugs, or a backend guide |
|
|
205
|
+
| `kernelport write-reference` | `write_reference` | save a candidate reference + spec |
|
|
206
|
+
| `kernelport validate <id>` or `--all` | `validate_reference` | original CUDA vs reference; freeze on PASS |
|
|
207
|
+
| `kernelport write-port` | `write_port` | save a port |
|
|
208
|
+
| `kernelport verify` | `verify_port` | port vs frozen reference |
|
|
209
|
+
| `kernelport bench` | `bench_port` | time port vs original (after PASS) |
|
|
210
|
+
| `kernelport tune <id> <backend>` | `tune_port` | verify + time every `TUNE` variant, keep the fastest that passes |
|
|
211
|
+
| `kernelport status` | `list_status` | kernel × backend × hardware table |
|
|
212
|
+
| `kernelport report [--md]` | `make_report` | HTML or Markdown report |
|
|
213
|
+
| `kernelport setup` | – | register with Claude Code / Codex / Cursor / Gemini CLI |
|
|
214
|
+
| `kernelport mcp` | – | run the MCP server on stdio |
|
|
215
|
+
| `kernelport agent "<task>"` | – | optional built-in agent (your Anthropic API key) |
|
|
216
|
+
|
|
217
|
+
## Development
|
|
218
|
+
|
|
219
|
+
```bash
|
|
220
|
+
python -m venv .venv && .venv/Scripts/activate # or source .venv/bin/activate
|
|
221
|
+
pip install --index-url https://download.pytorch.org/whl/cu128 torch
|
|
222
|
+
pip install -e ".[cuda,triton,cpu,dev]"
|
|
223
|
+
python -m pytest -q # ~4 min; GPU tests skip without CUDA, cpu tests need only numba
|
|
224
|
+
```
|
|
225
|
+
|
|
226
|
+
## License
|
|
227
|
+
|
|
228
|
+
MIT
|