evalview 0.8.0__tar.gz → 0.8.1__tar.gz
This diff represents the content of publicly available package versions that have been released to one of the supported registries. The information contained in this diff is provided for informational purposes only and reflects changes between package versions as they appear in their respective public registries.
- evalview-0.8.1/PKG-INFO +210 -0
- evalview-0.8.1/README.md +136 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/__init__.py +1 -1
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/cohere_adapter.py +14 -5
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/crewai_native_adapter.py +5 -2
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/goose_adapter.py +7 -3
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/http_adapter.py +15 -5
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/langgraph_adapter.py +3 -2
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/mcp_adapter.py +4 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/mistral_adapter.py +19 -8
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/ollama_adapter.py +1 -1
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/openai_assistants_adapter.py +1 -1
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/openclaw_adapter.py +7 -3
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/registry.py +7 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/tapescope_adapter.py +2 -2
- evalview-0.8.1/evalview/adapters/vercel_ai_adapter.py +223 -0
- evalview-0.8.1/evalview/cloud/auth.py +125 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/cloud/push.py +66 -16
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/check_cmd.py +108 -4
- evalview-0.8.1/evalview/commands/cloud_cmd.py +254 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/shared.py +10 -48
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/watch_cmd.py +89 -16
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/chaos.py +3 -3
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/fleet.py +3 -3
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/freshness.py +9 -23
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/goal_drift.py +5 -18
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/loader.py +29 -1
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/retrieval_lineage.py +5 -16
- evalview-0.8.1/evalview/core/text.py +23 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/types.py +10 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/evaluator.py +34 -18
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/hallucination_evaluator.py +1 -1
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/output_evaluator.py +15 -21
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/sequence_evaluator.py +5 -5
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/tool_call_evaluator.py +4 -4
- evalview-0.8.1/evalview/py.typed +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/_console_coverage.py +5 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/_console_statistical.py +4 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/console_reporter.py +3 -2
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/html_reporter.py +9 -8
- evalview-0.8.1/evalview.egg-info/PKG-INFO +210 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview.egg-info/SOURCES.txt +7 -1
- {evalview-0.8.0 → evalview-0.8.1}/pyproject.toml +3 -13
- evalview-0.8.1/tests/test_cloud_auth_and_push.py +203 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_loader.py +8 -2
- evalview-0.8.1/tests/test_loader_skill_suites.py +111 -0
- evalview-0.8.1/tests/test_vercel_ai_adapter.py +357 -0
- evalview-0.8.1/tests/test_watch_cmd.py +155 -0
- evalview-0.8.0/PKG-INFO +0 -1063
- evalview-0.8.0/README.md +0 -989
- evalview-0.8.0/evalview/cloud/auth.py +0 -80
- evalview-0.8.0/evalview/cloud/client.py +0 -175
- evalview-0.8.0/evalview/commands/cloud_cmd.py +0 -179
- evalview-0.8.0/evalview.egg-info/PKG-INFO +0 -1063
- {evalview-0.8.0 → evalview-0.8.1}/LICENSE +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/NOTICE +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/__main__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/aider_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/anthropic_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/base.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/crewai_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/huggingface_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/opencode_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/adapters/pydantic_ai_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/api.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/benchmarks/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/benchmarks/canary/README.md +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/benchmarks/canary/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/benchmarks/canary/suite.v1.held-out.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/benchmarks/canary/suite.v1.public.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/chat.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/chat_commands.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/chat_demo.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/chat_prompt.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/chat_runtime.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/chat_session.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/chat_slash.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/ci/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/ci/comment.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/cli.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/cloud/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/_check_helpers.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/_check_verdict.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/_init_demo_agent.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/_init_tests.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/_init_wizard.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/add_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/assertion_wizard.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/autopr_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/badge_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/baseline_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/benchmark_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/capture_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/chat_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/check_display.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/ci_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/demo_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/diff_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/drift_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/expand_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/feedback_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/fleet_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/freshness_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/generate_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/golden_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/gym_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/hooks_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/import_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/init_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/judge_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/listing_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/log_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/mcp_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/model_check_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/model_check_render.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/monitor_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/openclaw_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/progress_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/quarantine_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/replay_trace_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/run/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/run/_adapters.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/run/_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/run/_executor.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/run/_helpers.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/run/_reporter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/run/_runner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/simulate_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/since_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/skill_agent_runner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/skill_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/slack_digest_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/snapshot_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/telemetry_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/traces_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/trends_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/validate_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/commands/visual_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/compare.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/adapter_factory.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/behavioral_anomalies.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/benchmark_hardening.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/budget.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/canary_suite.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/cassette.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/celebrations.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/config.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/contract_diff.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/dashboard.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/diff.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/discord_notifier.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/drift_classifier.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/drift_kind.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/drift_tracker.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/eval_profiles.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/golden.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/healing.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/judge_cache.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/llm_configs.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/llm_provider.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/mcp_contract.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/messages.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/model_check_scoring.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/model_provider_runner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/model_runtime_detector.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/model_snapshots.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/noise_tracker.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/observability.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/otel_semconv.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/parallel.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/pricing.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/project_state.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/quarantine.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/rationale.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/recommendations.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/regression_synth.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/replay_pipeline.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/retry.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/root_cause.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/root_cause_hint.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/runner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/security.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/semantic_diff.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/simulation.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/slack_notifier.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/test_quality.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/tool_categories.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/tracing.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/turn_coherence.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/variant_clusterer.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/verdict.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/core/watcher.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/cost_evaluator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/latency_evaluator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/pii_evaluator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/safety_evaluator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/evaluators/statistical_evaluator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/expander.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/exporters/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/exporters/html_exporter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/importers/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/importers/log_importer.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/mcp_server.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/openclaw.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/pytest_plugin.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/recorder.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/_templates.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/json_reporter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/trace_live_reporter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/reporters/trace_reporter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/base.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/claude_code_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/codex_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/crewai_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/custom_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/langgraph_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/openai_assistants_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/openclaw_adapter.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/adapters/registry.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/agent_runner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/agent_types.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/constants.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/evaluators/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/evaluators/_security_checks.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/evaluators/_security_patterns.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/evaluators/deterministic.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/evaluators/orchestrator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/evaluators/rubric.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/parser.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/runner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/security_scanner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/test_generator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/test_helpers.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/types.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/ui_utils.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/skills/validator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/storage/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/storage/database.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/telemetry/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/telemetry/client.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/telemetry/config.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/telemetry/decorators.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/telemetry/events.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/code-generation.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/cost-budget.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/customer-support.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/data-analysis.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/latency-budget.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/multi-turn-memory.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/output-format.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/rag-citation.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/rag-grounding.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/research-synthesis.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/safety-refusal.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/tool-error-handling.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/tool-not-called.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/tool-sequence.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/templates/patterns/wrong-tool-chosen.yaml +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/test_generation.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/test_generation_constants.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/test_generation_discovery.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/test_generation_seeds.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/test_generation_synthesis.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/test_generation_types.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/trace_cmd/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/trace_cmd/collector.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/trace_cmd/patcher.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/trace_cmd/runner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/tracking/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/tracking/database.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/tracking/regression.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/version_check.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/visualization/__init__.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/visualization/_mermaid.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/visualization/_template.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview/visualization/generators.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview.egg-info/dependency_links.txt +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview.egg-info/entry_points.txt +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview.egg-info/requires.txt +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/evalview.egg-info/top_level.txt +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/setup.cfg +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_adapters.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_api.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_autopr.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_behavioral_anomalies.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_benchmark_hardening.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_canary_suite.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_cassette.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_celebrations.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_chaos.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_check_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_check_pipeline.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_ci_generate_comment.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_config_models.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_diff_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_diff_engine.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_dogfood_e2e.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_drift_classifier.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_drift_tracker.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_e2e_snapshot_check.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_endpoint_detection.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_evaluator_accuracy.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_evaluator_orchestrator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_evaluators.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_fleet.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_forbidden_tools.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_freshness.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_generate_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_goal_drift.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_golden_store.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_healing.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_init_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_judge_cache.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_llm_provider.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_log_importer_csv.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_main_evaluator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_mcp_contracts.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_mcp_server.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_messages.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_model_check_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_model_check_scoring.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_model_runtime_detector.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_model_snapshots.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_monitor.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_multi_turn_evaluation.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_new_features.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_noise_tracker.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_observability_regressions.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_otel_semconv.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_pii_evaluator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_project_state.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_pytest_plugin.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_rationale.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_replay_pipeline.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_retrieval_lineage.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_root_cause.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_root_cause_hint.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_run_cmd_tags.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_run_guidance.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_runner.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_security.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_semantic_diff.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_simulation.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_snapshot_generated_workflow.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_snapshot_json_output.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_statistical_evaluator.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_telemetry_client.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_turn_coherence.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_types.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_validate_cmd.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_verdict.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_version_check.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_visualization_generators.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_week1_integration.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_week2_quarantine.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_week2_review_fixes.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_week2_since_and_comment.py +0 -0
- {evalview-0.8.0 → evalview-0.8.1}/tests/test_week3_progress_and_drift.py +0 -0
evalview-0.8.1/PKG-INFO
ADDED
|
@@ -0,0 +1,210 @@
|
|
|
1
|
+
Metadata-Version: 2.4
|
|
2
|
+
Name: evalview
|
|
3
|
+
Version: 0.8.1
|
|
4
|
+
Summary: Open-source testing and regression detection framework for AI agents. Golden baseline diffing, CI/CD integration, works with LangGraph, CrewAI, OpenAI, Anthropic Claude, HuggingFace, Ollama, and MCP.
|
|
5
|
+
Author-email: EvalView Team <hidai@evalview.com>
|
|
6
|
+
License-Expression: Apache-2.0
|
|
7
|
+
Project-URL: Homepage, https://evalview.com
|
|
8
|
+
Project-URL: Documentation, https://github.com/hidai25/eval-view#readme
|
|
9
|
+
Project-URL: Repository, https://github.com/hidai25/eval-view.git
|
|
10
|
+
Project-URL: Issue Tracker, https://github.com/hidai25/eval-view/issues
|
|
11
|
+
Project-URL: Changelog, https://github.com/hidai25/eval-view/blob/main/CHANGELOG.md
|
|
12
|
+
Keywords: ai,agents,testing,evaluation,llm,langchain,langgraph,crewai,openai,anthropic,claude,huggingface,ollama,mcp,multi-agent,pytest-ai,ai-agent-testing,llm-testing,agent-evaluation,regression-testing,golden-baseline,ci-cd-testing,yaml-testing,tool-calling,agent-regression,llm-regression,skill-testing,mcp-contract-testing,pass-at-k,non-deterministic-testing,ai-ci-cd
|
|
13
|
+
Classifier: Development Status :: 4 - Beta
|
|
14
|
+
Classifier: Intended Audience :: Developers
|
|
15
|
+
Classifier: Programming Language :: Python :: 3
|
|
16
|
+
Classifier: Programming Language :: Python :: 3.9
|
|
17
|
+
Classifier: Programming Language :: Python :: 3.10
|
|
18
|
+
Classifier: Programming Language :: Python :: 3.11
|
|
19
|
+
Classifier: Programming Language :: Python :: 3.12
|
|
20
|
+
Classifier: Topic :: Software Development :: Testing
|
|
21
|
+
Classifier: Topic :: Software Development :: Quality Assurance
|
|
22
|
+
Classifier: Topic :: Scientific/Engineering :: Artificial Intelligence
|
|
23
|
+
Requires-Python: >=3.9
|
|
24
|
+
Description-Content-Type: text/markdown
|
|
25
|
+
License-File: LICENSE
|
|
26
|
+
License-File: NOTICE
|
|
27
|
+
Requires-Dist: click>=8.1.0
|
|
28
|
+
Requires-Dist: pydantic>=2.5.0
|
|
29
|
+
Requires-Dist: pyyaml>=6.0
|
|
30
|
+
Requires-Dist: openai>=1.12.0
|
|
31
|
+
Requires-Dist: anthropic>=0.39.0
|
|
32
|
+
Requires-Dist: rich>=13.7.0
|
|
33
|
+
Requires-Dist: prompt_toolkit>=3.0.0
|
|
34
|
+
Requires-Dist: httpx>=0.26.0
|
|
35
|
+
Requires-Dist: python-dateutil>=2.8.2
|
|
36
|
+
Requires-Dist: python-dotenv>=1.0.0
|
|
37
|
+
Requires-Dist: jinja2>=3.0
|
|
38
|
+
Requires-Dist: jsonschema>=4.0.0
|
|
39
|
+
Requires-Dist: tomli>=2.0; python_version < "3.11"
|
|
40
|
+
Provides-Extra: reports
|
|
41
|
+
Requires-Dist: plotly>=5.0; extra == "reports"
|
|
42
|
+
Provides-Extra: watch
|
|
43
|
+
Requires-Dist: watchdog>=3.0; extra == "watch"
|
|
44
|
+
Provides-Extra: schedule
|
|
45
|
+
Requires-Dist: croniter>=2.0; extra == "schedule"
|
|
46
|
+
Provides-Extra: telemetry
|
|
47
|
+
Requires-Dist: posthog>=3.0.0; extra == "telemetry"
|
|
48
|
+
Provides-Extra: cohere
|
|
49
|
+
Requires-Dist: cohere>=5.0.0; extra == "cohere"
|
|
50
|
+
Provides-Extra: mistral
|
|
51
|
+
Requires-Dist: mistralai>=1.0.0; extra == "mistral"
|
|
52
|
+
Provides-Extra: all
|
|
53
|
+
Requires-Dist: plotly>=5.0; extra == "all"
|
|
54
|
+
Requires-Dist: watchdog>=3.0; extra == "all"
|
|
55
|
+
Requires-Dist: croniter>=2.0; extra == "all"
|
|
56
|
+
Requires-Dist: posthog>=3.0.0; extra == "all"
|
|
57
|
+
Requires-Dist: cohere>=5.0.0; extra == "all"
|
|
58
|
+
Requires-Dist: mistralai>=1.0.0; extra == "all"
|
|
59
|
+
Provides-Extra: dev
|
|
60
|
+
Requires-Dist: pytest>=7.4.0; extra == "dev"
|
|
61
|
+
Requires-Dist: pytest-asyncio>=0.21.0; extra == "dev"
|
|
62
|
+
Requires-Dist: pytest-cov>=4.1.0; extra == "dev"
|
|
63
|
+
Requires-Dist: black==24.10.0; extra == "dev"
|
|
64
|
+
Requires-Dist: mypy>=1.7.0; extra == "dev"
|
|
65
|
+
Requires-Dist: types-PyYAML>=6.0; extra == "dev"
|
|
66
|
+
Requires-Dist: ruff>=0.1.0; extra == "dev"
|
|
67
|
+
Requires-Dist: jinja2>=3.0; extra == "dev"
|
|
68
|
+
Requires-Dist: plotly>=5.0; extra == "dev"
|
|
69
|
+
Requires-Dist: watchdog>=3.0; extra == "dev"
|
|
70
|
+
Requires-Dist: anthropic>=0.39.0; extra == "dev"
|
|
71
|
+
Requires-Dist: fastapi>=0.109.0; extra == "dev"
|
|
72
|
+
Requires-Dist: uvicorn>=0.27.0; extra == "dev"
|
|
73
|
+
Dynamic: license-file
|
|
74
|
+
|
|
75
|
+
<!-- mcp-name: io.github.hidai25/evalview-mcp -->
|
|
76
|
+
<!-- keywords: AI agent testing, regression detection, golden baselines -->
|
|
77
|
+
|
|
78
|
+
<p align="center">
|
|
79
|
+
<img src="assets/logo.png" alt="EvalView" width="350">
|
|
80
|
+
<br>
|
|
81
|
+
<strong>Snapshot testing for AI agents.</strong><br>
|
|
82
|
+
Record what your agent does today. Get told when it silently changes.
|
|
83
|
+
</p>
|
|
84
|
+
|
|
85
|
+
<p align="center">
|
|
86
|
+
<a href="https://pypi.org/project/evalview/"><img src="https://img.shields.io/pypi/v/evalview.svg?label=release" alt="PyPI version"></a>
|
|
87
|
+
<a href="https://pypi.org/project/evalview/"><img src="https://img.shields.io/pypi/dm/evalview.svg?label=downloads" alt="PyPI downloads"></a>
|
|
88
|
+
<a href="https://github.com/hidai25/eval-view/actions/workflows/dogfood.yml"><img src="https://github.com/hidai25/eval-view/actions/workflows/dogfood.yml/badge.svg" alt="Daily dogfood"></a>
|
|
89
|
+
<a href="https://github.com/hidai25/eval-view/stargazers"><img src="https://img.shields.io/github/stars/hidai25/eval-view?style=social" alt="GitHub stars"></a>
|
|
90
|
+
<a href="https://opensource.org/licenses/Apache-2.0"><img src="https://img.shields.io/badge/License-Apache_2.0-blue.svg" alt="License"></a>
|
|
91
|
+
</p>
|
|
92
|
+
|
|
93
|
+
---
|
|
94
|
+
|
|
95
|
+
Your agent returns `200` and looks fine. But a model update, a provider change, or a one-line prompt edit just made it skip a clarification, call the wrong tool, or quietly drop output quality. Your tests still pass. Your users notice before you do.
|
|
96
|
+
|
|
97
|
+
**EvalView snapshots your agent's behavior — the tools it calls, in what order, with what output — and tells you the moment that behavior changes.** Like Jest snapshots, but for tool-calling, multi-turn agents.
|
|
98
|
+
|
|
99
|
+
[](https://github.com/user-attachments/assets/96d8b5f7-3561-44a1-86a4-270fb0d1d8a6)
|
|
100
|
+
|
|
101
|
+
<sub>↑ 30-second live demo — no API key needed</sub>
|
|
102
|
+
|
|
103
|
+
## Quick Start
|
|
104
|
+
|
|
105
|
+
```bash
|
|
106
|
+
pip install evalview
|
|
107
|
+
```
|
|
108
|
+
|
|
109
|
+
```bash
|
|
110
|
+
evalview snapshot # Record your agent's current behavior as the baseline
|
|
111
|
+
evalview check # After any change, diff against the baseline
|
|
112
|
+
```
|
|
113
|
+
|
|
114
|
+
That's the whole loop. `check` returns one of:
|
|
115
|
+
|
|
116
|
+
```
|
|
117
|
+
✓ login-flow PASSED behavior matches baseline
|
|
118
|
+
⚠ refund-request TOOLS_CHANGED called a different tool, or in a different order
|
|
119
|
+
✗ billing-dispute REGRESSION score dropped — output quality fell
|
|
120
|
+
```
|
|
121
|
+
|
|
122
|
+
It diffs the **whole trajectory** — tool names, parameters, and order — not just the final string. The deterministic tool + sequence diff runs offline, with no API key. Add an LLM judge only when you want output-quality scoring.
|
|
123
|
+
|
|
124
|
+
No agent yet? See it work in 30 seconds:
|
|
125
|
+
|
|
126
|
+
```bash
|
|
127
|
+
evalview demo
|
|
128
|
+
```
|
|
129
|
+
|
|
130
|
+
## Why snapshot testing (and not assertions)?
|
|
131
|
+
|
|
132
|
+
Most eval tools ask you to *write down what "good" looks like* — assertions, metrics, rubrics. That's a lot of upfront work, and you can only catch the failures you thought to assert.
|
|
133
|
+
|
|
134
|
+
EvalView inverts it: **it records what your agent actually does now, and flags any drift from that.** You catch regressions you never anticipated, with zero assertions written. When the new behavior is correct, `evalview snapshot` accepts it as the new baseline — same as updating a snapshot in Jest.
|
|
135
|
+
|
|
136
|
+
| | EvalView | Assertion-based eval tools |
|
|
137
|
+
|---|---|---|
|
|
138
|
+
| Setup | Record current behavior | Write assertions/metrics first |
|
|
139
|
+
| Catches | Any drift from baseline | Only what you asserted |
|
|
140
|
+
| Non-determinism | Multi-variant baselines (up to 5 valid paths) | You handle it |
|
|
141
|
+
| Unit of comparison | Full tool-call trajectory | Usually final output |
|
|
142
|
+
|
|
143
|
+
This makes EvalView a **merge-time regression gate**, which is a different job from observability (Langfuse, LangSmith) or metric scoring (promptfoo, DeepEval, Braintrust). Many teams run one of those for visibility **and** EvalView as the gate. [Honest comparisons →](docs/COMPARISONS.md)
|
|
144
|
+
|
|
145
|
+
## EvalView tests itself in public, every day
|
|
146
|
+
|
|
147
|
+
The badge at the top is live. Every day at 09:00 UTC, a [GitHub Action](.github/workflows/dogfood.yml) runs EvalView against EvalView — including a regression check where **the tool snapshots a live agent and diffs it with the same `snapshot` / `check` loop** this README asks you to trust. It also runs the full test suite, type checks, `evalview demo`, the end-to-end flows, an `evalview monitor` smoke test, and chat-mode self-tests.
|
|
148
|
+
|
|
149
|
+
When something breaks, the run opens a single rolling [`🐕 dogfood` issue](https://github.com/hidai25/eval-view/issues?q=label%3Adogfood) and keeps updating it until the tool is green again — so failures are public, not quietly patched.
|
|
150
|
+
|
|
151
|
+
[Live dogfood runs →](https://github.com/hidai25/eval-view/actions/workflows/dogfood.yml) · [How it works →](docs/INTERNAL_DOGFOODING.md)
|
|
152
|
+
|
|
153
|
+
## CI: block regressions in every PR
|
|
154
|
+
|
|
155
|
+
```yaml
|
|
156
|
+
# .github/workflows/evalview.yml
|
|
157
|
+
name: EvalView
|
|
158
|
+
on: [pull_request]
|
|
159
|
+
jobs:
|
|
160
|
+
agent-check:
|
|
161
|
+
runs-on: ubuntu-latest
|
|
162
|
+
permissions: { pull-requests: write }
|
|
163
|
+
steps:
|
|
164
|
+
- uses: actions/checkout@v4
|
|
165
|
+
- uses: hidai25/eval-view@v0.8.1
|
|
166
|
+
with:
|
|
167
|
+
openai-api-key: ${{ secrets.OPENAI_API_KEY }}
|
|
168
|
+
```
|
|
169
|
+
|
|
170
|
+
You get a PR comment with the diff, cost/latency deltas, and a pass/fail gate. [CI/CD guide →](docs/CI_CD.md)
|
|
171
|
+
|
|
172
|
+
## Works with your stack
|
|
173
|
+
|
|
174
|
+
LangGraph · CrewAI · OpenAI · Claude · Mistral · Ollama · MCP · **any HTTP API**.
|
|
175
|
+
|
|
176
|
+
```bash
|
|
177
|
+
evalview check --agent http://localhost:8000/invoke
|
|
178
|
+
```
|
|
179
|
+
|
|
180
|
+
[Framework details →](docs/FRAMEWORK_SUPPORT.md)
|
|
181
|
+
|
|
182
|
+
## Use it as a library
|
|
183
|
+
|
|
184
|
+
```python
|
|
185
|
+
from evalview import gate
|
|
186
|
+
|
|
187
|
+
result = gate(test_dir="tests/")
|
|
188
|
+
result.passed # bool
|
|
189
|
+
result.diffs # per-test scores and tool diffs
|
|
190
|
+
```
|
|
191
|
+
|
|
192
|
+
[Python API →](docs/CLI_REFERENCE.md#python-api)
|
|
193
|
+
|
|
194
|
+
## More
|
|
195
|
+
|
|
196
|
+
EvalView also does multi-turn testing, statistical/pass@k runs, record/replay cassettes, model-drift canaries, production monitoring with Slack alerts, and auto-generated regression tests from incidents. These are power-user features — start with `snapshot` and `check`, reach for the rest when you need them.
|
|
197
|
+
|
|
198
|
+
→ [Full feature reference](docs/CLI_REFERENCE.md) · [Getting Started](docs/GETTING_STARTED.md) · [FAQ](docs/FAQ.md)
|
|
199
|
+
|
|
200
|
+
## Contributing
|
|
201
|
+
|
|
202
|
+
This is a young project built mostly by one developer. Issues, PRs, and "I tried it and X was confusing" feedback are all genuinely valuable.
|
|
203
|
+
|
|
204
|
+
- [Open an issue](https://github.com/hidai25/eval-view/issues) · [Discussions](https://github.com/hidai25/eval-view/discussions) · [CONTRIBUTING.md](CONTRIBUTING.md)
|
|
205
|
+
|
|
206
|
+
**License:** Apache 2.0
|
|
207
|
+
|
|
208
|
+
---
|
|
209
|
+
|
|
210
|
+
[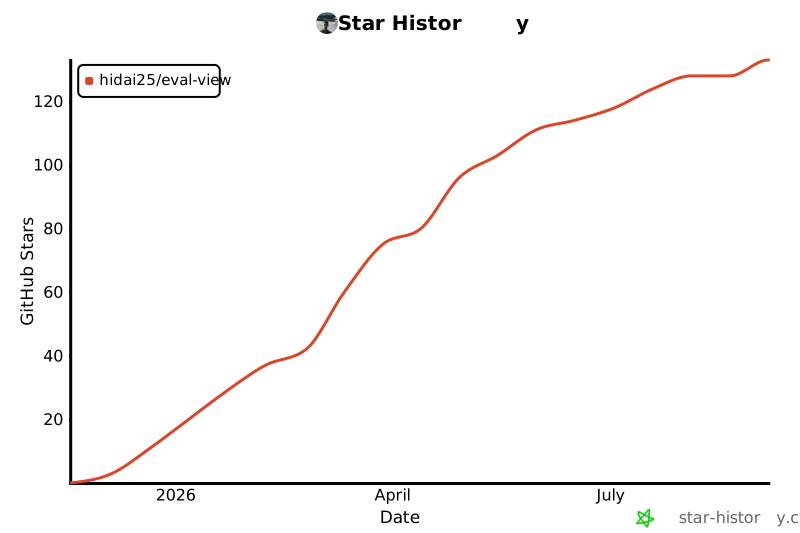](https://star-history.com/#hidai25/eval-view&Date)
|
evalview-0.8.1/README.md
ADDED
|
@@ -0,0 +1,136 @@
|
|
|
1
|
+
<!-- mcp-name: io.github.hidai25/evalview-mcp -->
|
|
2
|
+
<!-- keywords: AI agent testing, regression detection, golden baselines -->
|
|
3
|
+
|
|
4
|
+
<p align="center">
|
|
5
|
+
<img src="assets/logo.png" alt="EvalView" width="350">
|
|
6
|
+
<br>
|
|
7
|
+
<strong>Snapshot testing for AI agents.</strong><br>
|
|
8
|
+
Record what your agent does today. Get told when it silently changes.
|
|
9
|
+
</p>
|
|
10
|
+
|
|
11
|
+
<p align="center">
|
|
12
|
+
<a href="https://pypi.org/project/evalview/"><img src="https://img.shields.io/pypi/v/evalview.svg?label=release" alt="PyPI version"></a>
|
|
13
|
+
<a href="https://pypi.org/project/evalview/"><img src="https://img.shields.io/pypi/dm/evalview.svg?label=downloads" alt="PyPI downloads"></a>
|
|
14
|
+
<a href="https://github.com/hidai25/eval-view/actions/workflows/dogfood.yml"><img src="https://github.com/hidai25/eval-view/actions/workflows/dogfood.yml/badge.svg" alt="Daily dogfood"></a>
|
|
15
|
+
<a href="https://github.com/hidai25/eval-view/stargazers"><img src="https://img.shields.io/github/stars/hidai25/eval-view?style=social" alt="GitHub stars"></a>
|
|
16
|
+
<a href="https://opensource.org/licenses/Apache-2.0"><img src="https://img.shields.io/badge/License-Apache_2.0-blue.svg" alt="License"></a>
|
|
17
|
+
</p>
|
|
18
|
+
|
|
19
|
+
---
|
|
20
|
+
|
|
21
|
+
Your agent returns `200` and looks fine. But a model update, a provider change, or a one-line prompt edit just made it skip a clarification, call the wrong tool, or quietly drop output quality. Your tests still pass. Your users notice before you do.
|
|
22
|
+
|
|
23
|
+
**EvalView snapshots your agent's behavior — the tools it calls, in what order, with what output — and tells you the moment that behavior changes.** Like Jest snapshots, but for tool-calling, multi-turn agents.
|
|
24
|
+
|
|
25
|
+
[](https://github.com/user-attachments/assets/96d8b5f7-3561-44a1-86a4-270fb0d1d8a6)
|
|
26
|
+
|
|
27
|
+
<sub>↑ 30-second live demo — no API key needed</sub>
|
|
28
|
+
|
|
29
|
+
## Quick Start
|
|
30
|
+
|
|
31
|
+
```bash
|
|
32
|
+
pip install evalview
|
|
33
|
+
```
|
|
34
|
+
|
|
35
|
+
```bash
|
|
36
|
+
evalview snapshot # Record your agent's current behavior as the baseline
|
|
37
|
+
evalview check # After any change, diff against the baseline
|
|
38
|
+
```
|
|
39
|
+
|
|
40
|
+
That's the whole loop. `check` returns one of:
|
|
41
|
+
|
|
42
|
+
```
|
|
43
|
+
✓ login-flow PASSED behavior matches baseline
|
|
44
|
+
⚠ refund-request TOOLS_CHANGED called a different tool, or in a different order
|
|
45
|
+
✗ billing-dispute REGRESSION score dropped — output quality fell
|
|
46
|
+
```
|
|
47
|
+
|
|
48
|
+
It diffs the **whole trajectory** — tool names, parameters, and order — not just the final string. The deterministic tool + sequence diff runs offline, with no API key. Add an LLM judge only when you want output-quality scoring.
|
|
49
|
+
|
|
50
|
+
No agent yet? See it work in 30 seconds:
|
|
51
|
+
|
|
52
|
+
```bash
|
|
53
|
+
evalview demo
|
|
54
|
+
```
|
|
55
|
+
|
|
56
|
+
## Why snapshot testing (and not assertions)?
|
|
57
|
+
|
|
58
|
+
Most eval tools ask you to *write down what "good" looks like* — assertions, metrics, rubrics. That's a lot of upfront work, and you can only catch the failures you thought to assert.
|
|
59
|
+
|
|
60
|
+
EvalView inverts it: **it records what your agent actually does now, and flags any drift from that.** You catch regressions you never anticipated, with zero assertions written. When the new behavior is correct, `evalview snapshot` accepts it as the new baseline — same as updating a snapshot in Jest.
|
|
61
|
+
|
|
62
|
+
| | EvalView | Assertion-based eval tools |
|
|
63
|
+
|---|---|---|
|
|
64
|
+
| Setup | Record current behavior | Write assertions/metrics first |
|
|
65
|
+
| Catches | Any drift from baseline | Only what you asserted |
|
|
66
|
+
| Non-determinism | Multi-variant baselines (up to 5 valid paths) | You handle it |
|
|
67
|
+
| Unit of comparison | Full tool-call trajectory | Usually final output |
|
|
68
|
+
|
|
69
|
+
This makes EvalView a **merge-time regression gate**, which is a different job from observability (Langfuse, LangSmith) or metric scoring (promptfoo, DeepEval, Braintrust). Many teams run one of those for visibility **and** EvalView as the gate. [Honest comparisons →](docs/COMPARISONS.md)
|
|
70
|
+
|
|
71
|
+
## EvalView tests itself in public, every day
|
|
72
|
+
|
|
73
|
+
The badge at the top is live. Every day at 09:00 UTC, a [GitHub Action](.github/workflows/dogfood.yml) runs EvalView against EvalView — including a regression check where **the tool snapshots a live agent and diffs it with the same `snapshot` / `check` loop** this README asks you to trust. It also runs the full test suite, type checks, `evalview demo`, the end-to-end flows, an `evalview monitor` smoke test, and chat-mode self-tests.
|
|
74
|
+
|
|
75
|
+
When something breaks, the run opens a single rolling [`🐕 dogfood` issue](https://github.com/hidai25/eval-view/issues?q=label%3Adogfood) and keeps updating it until the tool is green again — so failures are public, not quietly patched.
|
|
76
|
+
|
|
77
|
+
[Live dogfood runs →](https://github.com/hidai25/eval-view/actions/workflows/dogfood.yml) · [How it works →](docs/INTERNAL_DOGFOODING.md)
|
|
78
|
+
|
|
79
|
+
## CI: block regressions in every PR
|
|
80
|
+
|
|
81
|
+
```yaml
|
|
82
|
+
# .github/workflows/evalview.yml
|
|
83
|
+
name: EvalView
|
|
84
|
+
on: [pull_request]
|
|
85
|
+
jobs:
|
|
86
|
+
agent-check:
|
|
87
|
+
runs-on: ubuntu-latest
|
|
88
|
+
permissions: { pull-requests: write }
|
|
89
|
+
steps:
|
|
90
|
+
- uses: actions/checkout@v4
|
|
91
|
+
- uses: hidai25/eval-view@v0.8.1
|
|
92
|
+
with:
|
|
93
|
+
openai-api-key: ${{ secrets.OPENAI_API_KEY }}
|
|
94
|
+
```
|
|
95
|
+
|
|
96
|
+
You get a PR comment with the diff, cost/latency deltas, and a pass/fail gate. [CI/CD guide →](docs/CI_CD.md)
|
|
97
|
+
|
|
98
|
+
## Works with your stack
|
|
99
|
+
|
|
100
|
+
LangGraph · CrewAI · OpenAI · Claude · Mistral · Ollama · MCP · **any HTTP API**.
|
|
101
|
+
|
|
102
|
+
```bash
|
|
103
|
+
evalview check --agent http://localhost:8000/invoke
|
|
104
|
+
```
|
|
105
|
+
|
|
106
|
+
[Framework details →](docs/FRAMEWORK_SUPPORT.md)
|
|
107
|
+
|
|
108
|
+
## Use it as a library
|
|
109
|
+
|
|
110
|
+
```python
|
|
111
|
+
from evalview import gate
|
|
112
|
+
|
|
113
|
+
result = gate(test_dir="tests/")
|
|
114
|
+
result.passed # bool
|
|
115
|
+
result.diffs # per-test scores and tool diffs
|
|
116
|
+
```
|
|
117
|
+
|
|
118
|
+
[Python API →](docs/CLI_REFERENCE.md#python-api)
|
|
119
|
+
|
|
120
|
+
## More
|
|
121
|
+
|
|
122
|
+
EvalView also does multi-turn testing, statistical/pass@k runs, record/replay cassettes, model-drift canaries, production monitoring with Slack alerts, and auto-generated regression tests from incidents. These are power-user features — start with `snapshot` and `check`, reach for the rest when you need them.
|
|
123
|
+
|
|
124
|
+
→ [Full feature reference](docs/CLI_REFERENCE.md) · [Getting Started](docs/GETTING_STARTED.md) · [FAQ](docs/FAQ.md)
|
|
125
|
+
|
|
126
|
+
## Contributing
|
|
127
|
+
|
|
128
|
+
This is a young project built mostly by one developer. Issues, PRs, and "I tried it and X was confusing" feedback are all genuinely valuable.
|
|
129
|
+
|
|
130
|
+
- [Open an issue](https://github.com/hidai25/eval-view/issues) · [Discussions](https://github.com/hidai25/eval-view/discussions) · [CONTRIBUTING.md](CONTRIBUTING.md)
|
|
131
|
+
|
|
132
|
+
**License:** Apache 2.0
|
|
133
|
+
|
|
134
|
+
---
|
|
135
|
+
|
|
136
|
+
[](https://star-history.com/#hidai25/eval-view&Date)
|
|
@@ -49,17 +49,26 @@ class CohereAdapter(AgentAdapter):
|
|
|
49
49
|
async with tracer.start_span_async("Cohere Agent", SpanKind.AGENT):
|
|
50
50
|
api_start = datetime.now()
|
|
51
51
|
|
|
52
|
-
# Send request to Cohere
|
|
52
|
+
# Send request to Cohere. The import is safe here: __init__ already
|
|
53
|
+
# verified the optional cohere package is installed.
|
|
54
|
+
from cohere import UserChatMessageV2
|
|
55
|
+
|
|
53
56
|
response = await self.client.chat(
|
|
54
57
|
model=self.model,
|
|
55
|
-
messages=[
|
|
58
|
+
messages=[UserChatMessageV2(content=query)]
|
|
56
59
|
)
|
|
57
|
-
|
|
60
|
+
|
|
58
61
|
api_end = datetime.now()
|
|
59
62
|
api_latency = (api_end - api_start).total_seconds() * 1000
|
|
60
63
|
|
|
61
|
-
# Extract AI's response text
|
|
62
|
-
|
|
64
|
+
# Extract the AI's response text. content is Optional, and items may
|
|
65
|
+
# be thinking blocks that carry no text payload.
|
|
66
|
+
final_answer = ""
|
|
67
|
+
for item in response.message.content or []:
|
|
68
|
+
text = getattr(item, "text", None)
|
|
69
|
+
if text:
|
|
70
|
+
final_answer = text
|
|
71
|
+
break
|
|
63
72
|
|
|
64
73
|
# 2. Extract Token Usage (Changes for compatibility with V1 and V2 SDKs)
|
|
65
74
|
input_tokens = 0
|
|
@@ -262,8 +262,11 @@ class CrewAINativeAdapter(AgentAdapter):
|
|
|
262
262
|
|
|
263
263
|
rationale = RationaleCollector()
|
|
264
264
|
last_agent: Optional[str] = None
|
|
265
|
-
|
|
266
|
-
|
|
265
|
+
calls_by_step: List[Optional[Dict[str, Any]]] = (
|
|
266
|
+
list(tool_calls) if tool_calls else [None] * len(steps)
|
|
267
|
+
)
|
|
268
|
+
for i, (st, call) in enumerate(zip(steps, calls_by_step)):
|
|
269
|
+
agent_name = call.get("agent") if call else None
|
|
267
270
|
if agent_name and agent_name != last_agent:
|
|
268
271
|
rationale.capture_branch(
|
|
269
272
|
step_id=st.step_id,
|
|
@@ -317,9 +317,13 @@ class GooseAdapter(AgentAdapter):
|
|
|
317
317
|
if tokens_data:
|
|
318
318
|
if isinstance(tokens_data, dict):
|
|
319
319
|
total_tokens = TokenUsage(
|
|
320
|
-
input_tokens=
|
|
321
|
-
|
|
322
|
-
|
|
320
|
+
input_tokens=int(
|
|
321
|
+
tokens_data.get("input", tokens_data.get("input_tokens", 0)) or 0
|
|
322
|
+
),
|
|
323
|
+
output_tokens=int(
|
|
324
|
+
tokens_data.get("output", tokens_data.get("output_tokens", 0)) or 0
|
|
325
|
+
),
|
|
326
|
+
cached_tokens=int(tokens_data.get("cached", 0) or 0),
|
|
323
327
|
)
|
|
324
328
|
elif isinstance(tokens_data, int):
|
|
325
329
|
total_tokens = TokenUsage(output_tokens=tokens_data)
|
|
@@ -153,8 +153,12 @@ class HTTPAdapter(AgentAdapter):
|
|
|
153
153
|
input_tokens = 0
|
|
154
154
|
output_tokens = 0
|
|
155
155
|
if isinstance(tokens_data, dict):
|
|
156
|
-
input_tokens =
|
|
157
|
-
|
|
156
|
+
input_tokens = int(
|
|
157
|
+
tokens_data.get("input", tokens_data.get("input_tokens", 0)) or 0
|
|
158
|
+
)
|
|
159
|
+
output_tokens = int(
|
|
160
|
+
tokens_data.get("output", tokens_data.get("output_tokens", 0)) or 0
|
|
161
|
+
)
|
|
158
162
|
|
|
159
163
|
tracer.record_llm_call(
|
|
160
164
|
model=model_name,
|
|
@@ -250,9 +254,15 @@ class HTTPAdapter(AgentAdapter):
|
|
|
250
254
|
if isinstance(tokens_data, dict):
|
|
251
255
|
# Nested format: {"input": 100, "output": 500, "cached": 50}
|
|
252
256
|
total_tokens = TokenUsage(
|
|
253
|
-
input_tokens=
|
|
254
|
-
|
|
255
|
-
|
|
257
|
+
input_tokens=int(
|
|
258
|
+
tokens_data.get("input", tokens_data.get("input_tokens", 0)) or 0
|
|
259
|
+
),
|
|
260
|
+
output_tokens=int(
|
|
261
|
+
tokens_data.get("output", tokens_data.get("output_tokens", 0)) or 0
|
|
262
|
+
),
|
|
263
|
+
cached_tokens=int(
|
|
264
|
+
tokens_data.get("cached", tokens_data.get("cached_tokens", 0)) or 0
|
|
265
|
+
),
|
|
256
266
|
)
|
|
257
267
|
elif isinstance(tokens_data, int):
|
|
258
268
|
# Simple total: {"tokens": 1500}
|
|
@@ -128,6 +128,7 @@ class LangGraphAdapter(AgentAdapter):
|
|
|
128
128
|
|
|
129
129
|
# Step 2: Create run with streaming
|
|
130
130
|
input_key = context.get("input_key", self.input_key)
|
|
131
|
+
run_input: Dict[str, Any]
|
|
131
132
|
if input_key:
|
|
132
133
|
run_input = {input_key: query}
|
|
133
134
|
else:
|
|
@@ -559,7 +560,7 @@ class LangGraphAdapter(AgentAdapter):
|
|
|
559
560
|
return StepTrace(
|
|
560
561
|
step_id=step_data.get("id", f"step-{index}"),
|
|
561
562
|
step_name=step_data.get("name", f"Step {index + 1}"),
|
|
562
|
-
tool_name=step_data.get("tool"),
|
|
563
|
+
tool_name=step_data.get("tool") or "unknown",
|
|
563
564
|
parameters=step_data.get("parameters", {}),
|
|
564
565
|
output=step_data.get("output"),
|
|
565
566
|
success=step_data.get("success", True),
|
|
@@ -579,7 +580,7 @@ class LangGraphAdapter(AgentAdapter):
|
|
|
579
580
|
return StepTrace(
|
|
580
581
|
step_id=event.get("id", f"step-{datetime.now().timestamp()}"),
|
|
581
582
|
step_name=content[:50] if content else "Step",
|
|
582
|
-
tool_name=event.get("tool"),
|
|
583
|
+
tool_name=event.get("tool") or "unknown",
|
|
583
584
|
parameters=event.get("parameters", {}),
|
|
584
585
|
output=content,
|
|
585
586
|
success=True,
|
|
@@ -344,6 +344,8 @@ class MCPAdapter(AgentAdapter):
|
|
|
344
344
|
self, process: asyncio.subprocess.Process, method: str, params: Dict
|
|
345
345
|
) -> Dict:
|
|
346
346
|
"""Send JSON-RPC request via stdio."""
|
|
347
|
+
# Process is always spawned with stdin/stdout=PIPE
|
|
348
|
+
assert process.stdin is not None and process.stdout is not None
|
|
347
349
|
self._request_id += 1
|
|
348
350
|
request = {
|
|
349
351
|
"jsonrpc": "2.0",
|
|
@@ -377,6 +379,8 @@ class MCPAdapter(AgentAdapter):
|
|
|
377
379
|
self, process: asyncio.subprocess.Process, method: str, params: Dict
|
|
378
380
|
) -> None:
|
|
379
381
|
"""Send JSON-RPC notification (no response expected)."""
|
|
382
|
+
# Process is always spawned with stdin=PIPE
|
|
383
|
+
assert process.stdin is not None
|
|
380
384
|
notification = {
|
|
381
385
|
"jsonrpc": "2.0",
|
|
382
386
|
"method": method,
|
|
@@ -1,10 +1,11 @@
|
|
|
1
1
|
import os
|
|
2
2
|
import logging
|
|
3
3
|
from datetime import datetime
|
|
4
|
-
from typing import Any, Optional, Dict
|
|
4
|
+
from typing import Any, List, Optional, Dict
|
|
5
5
|
|
|
6
6
|
try:
|
|
7
|
-
from mistralai import Mistral
|
|
7
|
+
from mistralai import Mistral, UserMessage
|
|
8
|
+
from mistralai.models import Messages
|
|
8
9
|
except ImportError:
|
|
9
10
|
raise ImportError(
|
|
10
11
|
"The mistralai package is required for the Mistral adapter. "
|
|
@@ -51,18 +52,28 @@ class MistralAdapter(AgentAdapter):
|
|
|
51
52
|
api_start = datetime.now()
|
|
52
53
|
|
|
53
54
|
# Send request to Mistral
|
|
55
|
+
messages: List[Messages] = [UserMessage(content=query)]
|
|
54
56
|
response = await self.client.chat.complete_async(
|
|
55
57
|
model=self.model,
|
|
56
|
-
messages=
|
|
58
|
+
messages=messages
|
|
57
59
|
)
|
|
58
|
-
|
|
60
|
+
|
|
59
61
|
api_end = datetime.now()
|
|
60
62
|
api_latency = (api_end - api_start).total_seconds() * 1000
|
|
61
63
|
|
|
62
|
-
# Extract AI's response text
|
|
63
|
-
|
|
64
|
-
|
|
65
|
-
|
|
64
|
+
# Extract the AI's response text. content may be a plain string or a
|
|
65
|
+
# list of chunks (text, think, image, ...); join the text-bearing ones.
|
|
66
|
+
content = response.choices[0].message.content
|
|
67
|
+
if isinstance(content, str):
|
|
68
|
+
final_answer = content
|
|
69
|
+
elif isinstance(content, list):
|
|
70
|
+
final_answer = "".join(getattr(chunk, "text", "") or "" for chunk in content)
|
|
71
|
+
else:
|
|
72
|
+
final_answer = ""
|
|
73
|
+
|
|
74
|
+
# Token counts are Optional in the SDK response
|
|
75
|
+
input_tokens = response.usage.prompt_tokens or 0
|
|
76
|
+
output_tokens = response.usage.completion_tokens or 0
|
|
66
77
|
|
|
67
78
|
# Calculate Cost
|
|
68
79
|
total_cost = calculate_cost(
|
|
@@ -101,10 +101,10 @@ class OllamaAdapter(AgentAdapter):
|
|
|
101
101
|
finish_reason = data.get("choices", [{}])[0].get("finish_reason", "stop")
|
|
102
102
|
|
|
103
103
|
# Build token usage
|
|
104
|
+
# total_tokens is a computed property on TokenUsage, not a field
|
|
104
105
|
token_usage = TokenUsage(
|
|
105
106
|
input_tokens=usage.get("prompt_tokens", 0),
|
|
106
107
|
output_tokens=usage.get("completion_tokens", 0),
|
|
107
|
-
total_tokens=usage.get("total_tokens", 0),
|
|
108
108
|
)
|
|
109
109
|
|
|
110
110
|
# Record LLM call span
|
|
@@ -288,9 +288,13 @@ class OpenClawAdapter(AgentAdapter):
|
|
|
288
288
|
if tokens_data:
|
|
289
289
|
if isinstance(tokens_data, dict):
|
|
290
290
|
total_tokens = TokenUsage(
|
|
291
|
-
input_tokens=
|
|
292
|
-
|
|
293
|
-
|
|
291
|
+
input_tokens=int(
|
|
292
|
+
tokens_data.get("input", tokens_data.get("input_tokens", 0)) or 0
|
|
293
|
+
),
|
|
294
|
+
output_tokens=int(
|
|
295
|
+
tokens_data.get("output", tokens_data.get("output_tokens", 0)) or 0
|
|
296
|
+
),
|
|
297
|
+
cached_tokens=int(tokens_data.get("cached", 0) or 0),
|
|
294
298
|
)
|
|
295
299
|
elif isinstance(tokens_data, int):
|
|
296
300
|
total_tokens = TokenUsage(output_tokens=tokens_data)
|
|
@@ -284,6 +284,13 @@ class AdapterRegistry:
|
|
|
284
284
|
except ImportError:
|
|
285
285
|
logger.warning("AiderAdapter not available")
|
|
286
286
|
|
|
287
|
+
try:
|
|
288
|
+
from evalview.adapters.vercel_ai_adapter import VercelAIAdapter
|
|
289
|
+
|
|
290
|
+
cls.register("vercel-ai", VercelAIAdapter)
|
|
291
|
+
except ImportError:
|
|
292
|
+
logger.warning("VercelAIAdapter not available")
|
|
293
|
+
|
|
287
294
|
cls._initialized = True
|
|
288
295
|
|
|
289
296
|
@classmethod
|
|
@@ -193,8 +193,8 @@ class TapeScopeAdapter(AgentAdapter):
|
|
|
193
193
|
**context,
|
|
194
194
|
}
|
|
195
195
|
|
|
196
|
-
events = []
|
|
197
|
-
steps = []
|
|
196
|
+
events: List[Dict[str, Any]] = []
|
|
197
|
+
steps: List[StepTrace] = []
|
|
198
198
|
final_output = ""
|
|
199
199
|
raw_text = "" # Fallback for plain text
|
|
200
200
|
total_usage = TokenUsage(input_tokens=0, output_tokens=0, cached_tokens=0)
|